Java并发包和线程池
JDK 并发包 JUC
java.util.concurrent
重入锁 ReentrantLock
几个重要方法 re-entrance-lock
lock.lock();
//获得锁,如占用,则等待
lockInteruptibly();
//获得锁,但优先响应中断,就是可以中断的
tryLock();
//失败返回false,不等待
tryLock(time,unit);
//在给定时间内尝试获得锁
unlock();
//释放锁
private int num;
private static final Lock lock = new ReentrantLock();
private static final Condition condition = lock.newCondition();

lock.lock();
try {
  while (不符合条件) {
    condition.await();
  }
  num++;
  System.out.print(Thread.currentThread().getName());
} catch (InterruptedException e) {
  throw new RuntimeException(e);
} finally {
  condition.signalAll();
  lock.unlock();
}
在 Java 中,重入锁(Reentrant Lock)是一种支持同一线程重复获取锁而不会被阻塞的锁机制。它的实现可以分为两种:
- 一种是基于 JVM 的内置锁(
synchronized); - 一种是基于 JUC 包的显示锁(如
ReentrantLock)。
synchronized 的重入原理(基于 JVM 实现) 非公平锁
synchronized是基于对象头(Object Monitor)的 Monitor Lock 实现的。- 每个对象都有一个 Monitor,如果一个线程已经获取了该 Monitor,再次进入时会增加一个计数器(称为重入计数)。
- 只有当线程完全退出所有
synchronized块后,才会真正释放这个锁。
📌 JVM 中的重入机制依赖于 Monitor 的 Owner 和计数器:
- 记录当前持锁线程(Owner)。
- 如果当前线程再次请求锁,只需将计数器
+1。 - 退出时递减计数器,直到为 0 时释放。
ReentrantLock 的重入原理(基于 AQS 实现) 公平锁
ReentrantLock是基于 AbstractQueuedSynchronizer(AQS) 实现的。- AQS 使用一个 volatile 的
state字段记录加锁次数,支持可重入。 - 线程第一次获得锁时:
- 设置 state = 1,并记录当前线程为 owner。
- 如果 owner 线程再次请求:
- 检查线程是否为当前 owner,如果是就直接 state++。
- 释放锁时:
- 每释放一次 state–;
- 当 state 为 0 时才真正释放锁并唤醒等待线程。
重入锁的好搭档:Condition 条件
condition.await()和 wait()类似
condition.signal()和 notify()类似
要在 lock 块内。
condition可以有多个,每个condition.await阻塞只能通过该condition的signal/signalall来唤醒!这是synchronized关键字所达不到的
注意如果signal在await之前,可能会通知丢失,变成死锁,随意最好用状态变量来循环解决。
Condition 的实现基于 AQS,也就是 AbstractQueuedSynchronizer。它背后的核心原理是通过 等待队列 和 通知机制 来协调线程的执行。 线程调用 await() 方法时,当前线程会被挂起并加入到 AQS 的队列中。
唤醒是通过 设置线程的状态 来实现的。AQS 会通过 CAS 操作 原子地改变线程的状态,保证线程安全。
Semaphore
信号量机制
允许多个线程同时访问
Semaphore semaphore=new semaphore(int permits);//permits是个许可证


run(){
    semaphore.acquire();

    ..

    semaphore.release();
}
以下代码模拟了对某个服务的并发请求,每次只能有 3 个客户端同时访问,请求总数为 10。
public class SemaphoreExample {
    public static void main(String[] args) {
        final int clientCount = 3;
        final int totalRequestCount = 10;
        Semaphore semaphore = new Semaphore(clientCount);
        ExecutorService executorService = Executors.newCachedThreadPool();
        for (int i = 0; i < totalRequestCount; i++) {
            executorService.execute(()->{
                try {
                    semaphore.acquire();
                    System.out.print(semaphore.availablePermits() + " ");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                } finally {
                    semaphore.release();
                }
            });
        }
        executorService.shutdown();
    }
}
resutl: 2 1 2 2 2 2 2 1 2 2
循环打印ABC.
class ABCPrinter {
    // 创建三个信号量,用于控制线程的执行顺序
    private static final Semaphore semaphoreA = new Semaphore(0);
    private static final Semaphore semaphoreB = new Semaphore(0);
    private static final Semaphore semaphoreC = new Semaphore(0);

    public static void main(String[] args) {
        Runnable printA = () -> {
            try {
                for (int i = 0; i < 10; i++) {
                    semaphoreA.acquire(); // 等待A的信号
                    System.out.print("A");
                    semaphoreB.release(); // 释放B的信号
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        };
。。。
    }
}
Semaphore 的实现基于 AQS(AbstractQueuedSynchronizer),通过维护一个计数器来控制并发线程数。每当线程请求资源时,计数器减少,当计数器为 0 时,后续线程会被挂起。通过 release() 方法可以释放资源并增加计数器的值,唤醒等待的线程。
ReentrantReadWriteLock
读写分离锁,可以减少锁竞争,提升性能
ReentrantReadWriteLock 内部通过一个 state 字段来表示锁的状态。这个状态由 高 16 位 和 低 16 位 两部分组成:
- 高 16 位:表示写锁的数量。
- 低 16 位:表示读锁的数量。
ReentrantReadWriteLock 是其常见的实现,它使用 AQS(AbstractQueuedSynchronizer) 来协调线程间的并发访问。读锁是共享锁,多个线程可以同时持有;写锁是独占锁,只有一个线程能持有写锁,且在写锁持有期间,不允许任何线程读取或写入资源。
StampedLock
StampedLock 是 Java 8 中引入的一个新型锁,提供比 ReentrantReadWriteLock 更高效的并发控制机制,尤其适用于需要大量读操作的场景。StampedLock 也通过 ReentrantLock 的机制来实现。
- 写锁:独占锁。
- 悲观读锁:类似于
ReentrantReadWriteLock的读锁。 - 乐观读锁:允许在不持有锁的情况下读取数据,在提交之前检查数据是否被修改过。
CountdownLatch
就是倒计数的锁存期,可以让线程等待直到倒计时结束,再开始执行
用来控制一个线程等待多个线程。
维护了一个计数器 cnt,每次调用 countDown() 方法会让计数器的值减 1,减到 0 的时候,那些因为调用 await() 方法而在等待的线程就会被唤醒。
实现原理: CountDownLatch 的底层通过 AQS 实现,使用一个 volatile 的 state 变量表示倒计时,线程通过 await() 进入 AQS 的 CLH 双向等待队列阻塞。 每个调用 countDown() 的线程原子性地将 state 减一,当 state 变为 0 时,调用 releaseShared() 唤醒所有等待线程。
public class CountdownLatchExample {

    public static void main(String[] args) throws InterruptedException {
        final int totalThread = 10;
        CountDownLatch countDownLatch = new CountDownLatch(totalThread);
        ExecutorService executorService = Executors.newCachedThreadPool();
        for (int i = 0; i < totalThread; i++) {
            executorService.execute(() -> {
                System.out.print("run..");
                countDownLatch.countDown();
            });
        }
        countDownLatch.await();
        System.out.println("end");
        executorService.shutdown();
    }
}
result:
run..run..run..run..run..run..run..run..run..run..end
CyclicBarrier
允许一组线程互相等待,直到都到达某个公共屏障点
用来控制多个线程互相等待,只有当多个线程都到达时,这些线程才会继续执行。
和 CountdownLatch 相似,都是通过维护计数器来实现的。但是它的计数器是递增的,每次执行 await() 方法之后,计数器会加 1,直到计数器的值和设置的值相等,等待的所有线程才会继续执行。和 CountdownLatch 的另一个区别是,CyclicBarrier 的计数器可以循环使用,所以它才叫做循环屏障。
这个是规定多少个线程,这一定数量的线程都到达 await()时才开始都唤醒,继续执行
实现原理:CyclicBarrier 内部通过 ReentrantLock 和 Condition 控制线程的阻塞与唤醒,每次有线程调用 await(),都会将 count 减 1,当最后一个线程到达时执行 barrierAction(如果有),然后唤醒所有线程;为了支持多轮使用,它通过一个叫 generation 的对象标记每一轮屏障;其设计体现了经典的“屏障”同步模式,非常适用于多线程并发阶段任务。
public class CyclicBarrierExample {
    public static void main(String[] args) throws InterruptedException {
        final int totalThread = 10;
        CyclicBarrier cyclicBarrier = new CyclicBarrier(totalThread);
        ExecutorService executorService = Executors.newCachedThreadPool();
        for (int i = 0; i < totalThread; i++) {
            executorService.execute(() -> {
                System.out.print("before..");
                try {
                    cyclicBarrier.await();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                } catch (BrokenBarrierException e) {
                    e.printStackTrace();
                }
                System.out.print("after..");
            });
        }
        executorService.shutdown();
    }
}
result:
before..before..before..before..before..before..before..before..before..before..after..after..after..after..after..after..after..after..after..after..
Exchanger
用于两个线程之间数据的同步交换,都准备好才交换
        final Exchanger<String> exchanger = new Exchanger<>();

        // Thread 1: Producer
        Thread producer = new Thread(() -> {
            try {
                String message = "Hello from producer!";
                System.out.println("Producer before exchange: " + message);
                String response = exchanger.exchange(message); // 交换数据
                System.out.println("Producer after exchange: " + response);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });

        // Thread 2: Consumer
        Thread consumer = new Thread(() -> {
            try {
                String message = "Hello from consumer!";
                System.out.println("Consumer before exchange: " + message);
                String response = exchanger.exchange(message); // 交换数据
                System.out.println("Consumer after exchange: " + response);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });
Exchanger 底层的核心结构是一个 双向链表 或 节点(Node)。每当一个线程调用 exchange() 方法时,它会创建一个节点并将自己插入链表中,表示它正等待交换数据。另一线程调用 exchange() 时,也会创建一个节点,等待与第一个线程交换数据。
一旦两个线程都准备好交换数据,它们会在这个链表中交换各自的数据。
transferer:Exchanger内部使用了Transferer接口的实现类来管理线程间的交换。Transferer实际上是用来实现数据交换的接口,它有多个实现类,用于不同的同步需求。Item: 用来存放线程交换的数据的对象。在Exchanger内部,线程会持有一个Item,每个线程传入的数据都会存储在Item中。Node:Node是一个双向链表的节点。每当一个线程调用exchange()时,线程就会在内部的双向链表中创建一个Node来等待交换。- 锁与条件变量:
ReentrantLock:用于确保对共享资源的互斥访问。Condition:用于实现线程的等待与通知机制。每个线程在exchange()调用时都会被放入一个等待队列中,直到与另一个线程交换数据。
核心流程
- 线程调用
exchange()方法
当线程调用 exchange() 时,它会创建一个节点并加入到交换的队列中。节点保存了当前线程的数据,并等待另一个线程来交换数据。
- 线程 A 调用
exchange(),并将其数据存储在节点中,等待与线程 B 交换数据。 - 线程 B 调用
exchange(),并将其数据存储在节点中,等待与线程 A 交换数据。
- 线程阻塞与等待
- 当线程 A 调用
exchange()后,它会调用lock.lock()获取锁,然后检查是否有另一个线程已经在等待交换。 - 如果线程 B 也已经在等待,
Exchanger会交换它们的数据。 - 如果线程 A 没有找到线程 B 来交换数据,它会调用
condition.await()阻塞自己,直到线程 B 准备好交换数据。
- 线程交换数据
- 一旦线程 A 和线程 B 都准备好了交换数据,
Exchanger会将它们各自的数据交换。线程 A 会从线程 B 获取数据,而线程 B 会从线程 A 获取数据。 - 交换完成后,线程会被通知继续执行。
- 通知与继续执行
- 交换完成后,
Exchanger会使用condition.signalAll()来通知所有等待的线程,让它们继续执行。
总结
Semaphore synchronized CountDownLatch 不依赖于重入锁。
FutureTask:不是用 ReentrantLock,而是 AQS 实现
其他JUC基本依赖于重入锁。
并发数据结构
| 类名 | 数据结构 | 同步机制 |
|---|---|---|
ConcurrentHashMap | 数组 + 链表/红黑树 + 分段锁/CAS | 分段锁(JDK7),CAS + synchronized(JDK8) |
ConcurrentSkipListMap | 跳表(SkipList) | CAS + volatile |
ConcurrentLinkedQueue | 链表 | CAS(无锁) |
ConcurrentLinkedDeque | 双向链表 | CAS(无锁) |
LinkedBlockingQueue | 链表 | ReentrantLock(put/take 两把锁)长度不可为0 |
ArrayBlockingQueue | 数组环形缓冲区 | ReentrantLock(put/take 两把锁) 是有界的,初始化需要提供数量 |
PriorityBlockingQueue | 最小堆 | ReentrantLock |
DelayQueue | 最小堆(内部是 PriorityQueue) | ReentrantLock |
SynchronousQueue | 无缓冲/虚拟队列 | CAS + Lock(公平时) |
LinkedTransferQueue | 链表 + 匹配节点 | CAS + 自旋 |
CopyOnWriteArrayList | 数组 | 写时复制 |
CopyOnWriteArraySet | 基于 CopyOnWriteArrayList | 写时复制 |
LinkedBlockingQueue
LinkedBlockingQueue 是基于 链表 实现的,并通过 ReentrantLock 进行同步管理。它使用两把锁:一把用于生产者线程(put 操作),一把用于消费者线程(take 操作)。这样设计保证了 put 和 take 操作可以并发执行,提高了吞吐量。
head和tail:链表的头部和尾部节点。count:队列中的当前元素数量。putLock:用于控制put操作的锁。takeLock:用于控制take操作的锁。notFull和notEmpty:分别控制当队列满时生产者线程的等待和当队列空时消费者线程的等待。
public void put(E e) throws InterruptedException {
    final ReentrantLock putLock = this.putLock;
    putLock.lockInterruptibly();
    try {
        while (count == items.length)   // 当队列满时
            notFull.await();             // 等待队列有空间
        enqueue(e);                      // 插入队列
        if (count == 1)                  // 唤醒等待的消费者
            notEmpty.signal();
    } finally {
        putLock.unlock();
    }
}
双锁机制(putLock 和 takeLock)
putLock:控制put操作,保证在插入时不会与take操作冲突。takeLock:控制take操作,保证在移除时不会与put操作冲突。
条件变量(notFull 和 notEmpty)
notFull:当队列满时,生产者线程会阻塞在该条件变量上,直到队列有空间。notEmpty:当队列为空时,消费者线程会阻塞在该条件变量上,直到队列有元素。
SynchronousQueue
底层数据结构
SynchronousQueue 的底层实现并不是传统意义上的基于 数组 或 链表 的数据结构,而是通过 双向链表 和 阻塞队列 的机制来实现元素的交换。
节点(Node):
SynchronousQueue中维护了两个节点:- 一个用于等待生产者线程
put数据的节点。 - 一个用于等待消费者线程
take数据的节点。
- 一个用于等待生产者线程
同步双向链表:
SynchronousQueue内部维护一个双向链表,这个链表只有两个节点:- 一个节点是生产者线程在
put操作时等待的数据。 - 另一个节点是消费者线程在
take操作时等待的数据。
双向链表的作用是帮助管理等待的线程。生产者和消费者线程的交换就是通过这两个节点来实现的。
- 一个节点是生产者线程在
锁与条件变量:
SynchronousQueue使用了ReentrantLock和Condition来实现线程同步和等待。生产者线程在put数据时会持有锁并等待,如果没有消费者线程take数据,生产者线程会阻塞。消费者线程在take数据时也会持有锁并等待,如果没有生产者线程put数据,消费者线程会阻塞。
核心方法
put(E e):当生产者调用put方法时,它会尝试将数据放入队列。由于SynchronousQueue是一个不存储元素的队列,生产者线程必须等待消费者线程调用take来取走这个数据。如果消费者线程没有取走数据,生产者线程会被阻塞。take():消费者线程调用take方法时,它会等待生产者线程将数据放入队列。如果生产者线程没有放入数据,消费者线程会被阻塞。
  SynchronousQueue<String> queue = new SynchronousQueue<>();

put, take
DelayQueue
DelayQueue一般用于生产者消费者模式。
它不是定时任务。
take():阻塞地获取队列中的元素。如果队列为空,或者所有元素都尚未到期,调用线程会被阻塞直到有元素可用。
DelayQueue 的核心是基于 优先级队列 来进行元素排序,具体来说,它是通过 PriorityBlockingQueue 来实现的。PriorityBlockingQueue 是一个没有容量限制的阻塞队列,能够根据元素的延迟时间来对元素进行排序。
- 阻塞机制:
take()和poll()方法会检查队列头部的元素的延迟时间。如果延迟时间未到,调用线程会被阻塞直到延迟时间到期。 - 线程阻塞与唤醒:
DelayQueue使用AQS(AbstractQueuedSynchronizer)来管理阻塞线程。当队列中的元素到期时,它会唤醒等待的线程,使得这些线程可以继续执行。
AQS原理
AQS(AbstractQueuedSynchronizer)的原理。它是 Java 并发框架中用于构建锁和同步器的一个核心框架类,比如 ReentrantLock、Semaphore、CountDownLatch 等同步器,底层都是基于 AQS 实现的。是 Java 并发包
java.util.concurrent.locks中用来构建锁和其他同步器(如信号量、读写锁、倒计时器等)的一个基础框架类。它是 J.U.C 并发框架中最核心的底层组件之一。
AQS 通过一个FIFO 队列(先进先出等待队列)来管理获取锁失败的线程,并通过一个原子变量 state 来表示同步状态,从而实现各种自定义同步器。
AQS 与 synchronized 有何不同?
| 特性 | synchronized | AQS(如 ReentrantLock) |
|---|---|---|
| 可中断 | ❌ 不支持 | ✅ 支持 |
| 可重入 | ✅ | ✅ |
| 公平性选择 | ❌ 不可选 | ✅ 只有支持公平模式 |
| 条件变量支持 | ❌ | ✅ Condition 支持更强大 |
| 性能控制 | ❌(黑盒) | ✅ 更可控 |
如果想要非FIFO,请用synchronized, 比如重入锁非公平模式。
实现
🌟 1. 核心思想:状态 + 队列
AQS 的核心是两个部分:
- state:一个
volatile int state表示当前的同步状态,比如 0 表示未加锁,1 表示已加锁。 - 等待队列(CLH 队列):线程获取锁失败后,会被封装为一个
Node节点,加入到一个 FIFO 双向队列 中,并通过LockSupport.park()挂起。
| 字段名 | 类型 | 说明 |
|---|---|---|
state | volatile int | 同步状态(0 代表未占用) |
head / tail | Node | CLH 队列的头尾指针 |
Node | 静态内部类 | 每个等待线程一个 Node |
waitStatus | int | 节点状态(SIGNAL、CANCELLED 等) |
thread | Thread | 对应线程 |
next / prev | Node | 指向前后节点,实现双向链表 |
🔁 2. 获取锁流程(以独占为例):
- 线程调用
acquire()尝试加锁,底层会调用tryAcquire()。 - 如果
tryAcquire()失败,就进入等待队列,并阻塞当前线程。 - 前一个线程释放锁时调用
release(),底层调用tryRelease()成功后唤醒下一个线程。
🧱 3. AQS 提供模板方法,子类负责实现:
protected boolean tryAcquire(int arg);
protected boolean tryRelease(int arg);
开发者通过继承 AQS 并实现这些方法,可以自定义同步器的行为。
📌 4. 支持两种模式:
- 独占模式(Exclusive):一次只允许一个线程获取资源,如 ReentrantLock。tryAcquire
- 共享模式(Shared):多个线程可以共享资源,如 Semaphore、CountDownLatch。tryAcquireShared
tryAcquire() / tryAcquireShared()
        ↓
获取失败 → addWaiter() → enq() → park()
        ↓
前驱释放锁 → unpark() → 自旋重试 → 获取成功
📚 5. 实际应用举例:
- ReentrantLock:基于 AQS 的独占模式。
- Semaphore:基于共享模式控制并发数量。
- CountDownLatch:通过共享计数控制线程等待。
| 子类 | 模式 | 实现方法 |
|---|---|---|
ReentrantLock | 独占 | tryAcquire, tryRelease |
Semaphore | 共享 | tryAcquireShared, tryReleaseShared |
CountDownLatch | 共享 | tryAcquireShared, tryReleaseShared |
ReentrantReadWriteLock.WriteLock | 独占 | 见写锁实现 |
ReentrantReadWriteLock.ReadLock | 共享 | 见读锁实现 |
ReentrantReadWriteLock 读共享,写独占
QA
为什么要使用 LockSupport.park() 而不是 wait()?
park/unpark更灵活,线程不需要先获取锁。wait/notify依赖对象锁,容易产生死锁或复杂同步。
CLH(Craig, Landin, and Hagersten)队列 是核心的数据结构之一。它是一种用于实现 自旋锁 / 阻塞锁的并发队列。
- 每个线程都对应一个节点(
Node)挂到队列尾部。 - 线程通过自旋或挂起等待其前驱节点的状态变化。
- 在 AQS 中称为 “同步队列”(sync queue)。
优点
- FIFO 保证公平性
- 非阻塞入队(CAS)
- 自旋/挂起等待前驱通知
- 可扩展性强,适合高并发场景
线程池
合理利用线程池能够带来三个好处。第一:降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗。第二:提高响应速度。当任务到达时,任务可以不需要的等到线程创建就能立即执行。第三:提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。但是要做到合理的利用线程池,必须对其原理了如指掌。
Executors.newFixedThreadPool(int nThreads):创建固定大小的线程池。Executors.newCachedThreadPool():创建一个可缓存的线程池,线程池的大小可根据需求动态调整。Executors.newSingleThreadExecutor():创建一个单线程的线程池,所有任务按照提交顺序执行。Executors.newScheduledThreadPool(int corePoolSize):创建一个定时任务线程池,支持定时任务执行。
        // 创建一个固定大小的线程池,大小为 3
        ExecutorService threadPool = Executors.newFixedThreadPool(3);

        // 提交 6 个任务
        for (int i = 0; i < 6; i++) {
            threadPool.submit(new Task("Task " + (i + 1)));
        }

        // 关闭线程池
        threadPool.shutdown();
线程池任务创建与提交
任务分为两种:一种是有返回值的( callable ),一种是没有返回值的( runnable ). Callable 与 Future 两功能是 Java 在后续版本中为了适应多并法才加入的,Callable 是类似于 Runnable 的接口,实现 Callable 接口的类和实现 Runnable 的类都是可被其他线程执行的任务。
- 无返回值的任务就是一个实现了 runnable 接口的类.使用 run 方法.
- 有返回值的任务是一个实现了 callable 接口的类.使用 call 方法.
Callable 和 Runnable 的区别如下:
- Callable 定义的方法是 call,而 Runnable 定义的方法是 run。
- Callable 的 call 方法可以有返回值,而 Runnable 的 run 方法不能有返回值。
- Callable 的 call 方法可抛出异常,而 Runnable 的 run 方法不能抛出异常。
execute 与 submit 区别:
- 接收的参数不一样
- submit 有返回值,而 execute 没有
- submit 方便 Exception 处理
- execute 是 Executor 接口中唯一定义的方法;submit 是 ExecutorService(该接口继承 Executor)中定义的方法
线程池的关闭
我们可以通过调用线程池的 shutdown 或 shutdownNow 方法来关闭线程池,但是它们的实现原理不同,shutdown 的原理是只是将线程池的状态设置成 SHUTDOWN 状态,然后中断所有没有正在执行任务的线程。shutdownNow 的原理是遍历线程池中的工作线程,然后逐个调用线程的 interrupt 方法来中断线程,所以无法响应中断的任务可能永远无法终止。shutdownNow 会首先将线程池的状态设置成 STOP,然后尝试停止所有的正在执行或暂停任务的线程,并返回等待执行任务的列表。
只要调用了这两个关闭方法的其中一个,isShutdown 方法就会返回 true。当所有的任务都已关闭后,才表示线程池关闭成功,这时调用 isTerminaed 方法会返回 true。至于我们应该调用哪一种方法来关闭线程池,应该由提交到线程池的任务特性决定,通常调用 shutdown 来关闭线程池,如果任务不一定要执行完,则可以调用 shutdownNow。
线程池的分析
创建一个线程池需要输入几个参数:
- corePoolSize(线程池的基本大小):当提交一个任务到线程池时,线程池会创建一个线程来执行任务,即使其他空闲的基本线程能够执行新任务也会创建线程,等到需要执行的任务数大于线程池基本大小时就不再创建。如果调用了线程池的 prestartAllCoreThreads 方法,线程池会提前创建并启动所有基本线程。默认情况下,在创建了线程池后,线程池中的线程数为 0,当有任务来之后,就会创建一个线程去执行任务,当线程池中的线程数目达到 corePoolSize 后,就会把到达的任务放到缓存队列当中;
- runnableTaskQueue(任务队列):用于保存等待执行的任务的阻塞队列。可以选择以下几个阻塞队列。
- ArrayBlockingQueue:是一个基于数组结构的有界阻塞队列,此队列按 FIFO(先进先出)原则对元素进行排序。
- LinkedBlockingQueue:一个基于链表结构的阻塞队列,此队列按 FIFO (先进先出) 排序元素,吞吐量通常要高于 ArrayBlockingQueue。静态工厂方法 Executors.newFixedThreadPool()使用了这个队列。
- SynchronousQueue:一个不存储元素的阻塞队列。每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于 LinkedBlockingQueue,静态工厂方法 Executors.newCachedThreadPool 使用了这个队列。
- PriorityBlockingQueue:一个具有优先级得无限阻塞队列。
- maximumPoolSize(线程池最大大小):线程池允许创建的最大线程数。如果队列满了,并且已创建的线程数小于最大线程数,则线程池会再创建新的线程执行任务。值得注意的是如果使用了无界的任务队列这个参数就没什么效果。也就是说 corePoolSize 就是线程池大小,maximumPoolSize 在我看来是线程池的一种补救措施,即任务量突然过大时的一种补救措施。
- ThreadFactory:用于设置创建线程的工厂,可以通过线程工厂给每个创建出来的线程设置更有意义的名字,Debug 和定位问题时非常又帮助。
- RejectedExecutionHandler(饱和策略):当队列和线程池都满了,说明线程池处于饱和状态,那么必须采取一种策略处理提交的新任务。这个策略默认情况下是 AbortPolicy,表示无法处理新任务时抛出异常。以下是 JDK1.5 提供的四种策略。
- AbortPolicy:直接抛出异常
- CallerRunsPolicy:只用调用者所在线程来运行任务。
- DiscardOldestPolicy:丢弃队列里最近的一个任务,并执行当前任务。
- DiscardPolicy:不处理,丢弃掉。
当然也可以根据应用场景需要来实现 RejectedExecutionHandler 接口自定义策略。如记录日志或持久化不能处理的任务。
- keepAliveTime(线程活动保持时间):线程池的工作线程空闲后,保持存活的时间。所以如果任务很多,并且每个任务执行的时间比较短,可以调大这个时间,提高线程的利用率。
- TimeUnit(线程活动保持时间的单位):可选的单位有天(DAYS),小时(HOURS),分钟(MINUTES),毫秒(MILLISECONDS),微秒(MICROSECONDS, 千分之一毫秒)和毫微秒(NANOSECONDS, 千分之一微秒)。
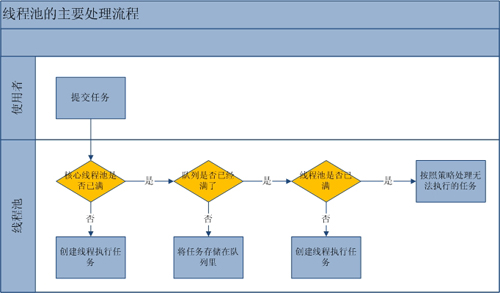
从上图我们可以看出,当提交一个新任务到线程池时,线程池的处理流程如下:
- 如果当前线程池中的线程数目小于 corePoolSize,则每来一个任务,就会创建一个线程去执行这个任务;
- 如果当前线程池中的线程数目>=corePoolSize,则每来一个任务,会尝试将其添加到任务缓存队列当中,若添加成功,则该任务会等待空闲线程将其取出去执行;若添加失败(一般来说是任务缓存队列已满),则会尝试创建新的线程去执行这个任务;
- 如果当前线程池中的线程数目达到 maximumPoolSize,则会采取任务拒绝策略进行处理;
如果线程池中的线程数量大于 corePoolSize 时,如果某线程空闲时间超过 keepAliveTime,线程将被终止,直至线程池中的线程数目不大于 corePoolSize;如果允许为核心池中的线程设置存活时间,那么核心池中的线程空闲时间超过 keepAliveTime,线程也会被终止
从它们的具体实现来看,它们实际上也是调用了 ThreadPoolExecutor,只不过参数都已配置好了。
newFixedThreadPool 创建的线程池 corePoolSize 和 maximumPoolSize 值是相等的,它使用的 LinkedBlockingQueue;
newSingleThreadExecutor 将 corePoolSize 和 maximumPoolSize 都设置为 1,也使用的 LinkedBlockingQueue;
newCachedThreadPool 将 corePoolSize 设置为 0,将 maximumPoolSize 设置为 Integer.MAX_VALUE,使用的 SynchronousQueue,也就是说来了任务就创建线程运行,当线程空闲超过 60 秒,就销毁线程。
实际中,如果 Executors 提供的三个静态方法能满足要求,就尽量使用它提供的三个方法,因为自己去手动配置 ThreadPoolExecutor 的参数有点麻烦,要根据实际任务的类型和数量来进行配置。另外,如果 ThreadPoolExecutor 达不到要求,可以自己继承 ThreadPoolExecutor 类进行重写。