NoSQL存储设计
复制
- 单主复制适用于读多写少的场景,简单且容易管理,但存在单点故障和写入扩展性差的问题。
- 架构:在单主复制中,数据库系统有一个主节点(Master)和一个或多个从节点(Slave)。所有写操作都发生在主节点,而从节点只负责读取操作。
- 单点故障:如果主节点故障,整个系统的写入操作会中断。
- 扩展性有限,特别是在写操作的负载很大的时候。
- MySQL
- 多主复制适合需要高可用、负载均衡和扩展写操作的场景,但管理复杂且需要解决数据冲突。
- 架构:在多主复制中,多个数据库节点都可以充当主节点,既可以处理写操作,也可以处理读操作。每个节点都与其他节点进行双向复制。
- 数据冲突:多个主节点同时处理写操作时,可能会出现数据冲突和一致性问题。需要更复杂的机制来处理冲突(如时间戳、版本控制等)。
- 配置和管理复杂:需要确保各主节点之间的数据一致性。
- Abase 2,DynamoDB.
- 无主复制适合分布式系统中各节点都需要进行读写操作的场景,提供高可用性,但面临更复杂的数据一致性问题。
- 架构:在无主复制中,所有节点都是平等的,既可以进行读操作,也可以进行写操作。每个节点之间都通过双向复制来保持数据一致性。
- 数据一致性问题:多个节点并发地进行写操作时,可能会导致数据冲突和一致性问题,处理起来较为复杂。
- 配置和管理较为复杂,需要在每个节点之间进行协调,确保数据的一致性和冲突解决。
- AWS曾经放弃的Dynamo就是,需要客户端连接多个节点读写,NWR配置一致性。
多主模型应用场景
单个数据中心,多主模型意义不大:复杂度超过了收益。总体而言,由于一致性等问题,多主模型应用场景较少,但有一些场景,很适合多主:
- 数据库横跨多个数据中心
- 需要离线工作的客户端
- 协同编辑
传统NoSQL代表
为了支持海量数据,能够方便扩展,在业务很简单,也不需要 SQL的场景下,NoSql类型数据库诞生了,代表 Mongodb,Hbase, Cassandra
Hbase:使用了lsm树来作为存储结构,基于Google Bigtable 论文的开源实现,底层依赖HDFS,分布式表格。
Cassandra:跟Hbase类似,无主复制,基于亚马逊 Dynamo 论文实现,国内目前使用较少。
Mongodb: 文档型数据库,使用简单方便,最大的特点是没有schema限制。
这些也有一些不足:
- 不支持sql查询,需要用特定API
- 事务支持不完善
- 复杂性的查询受限(比如关联查询)
- 技术成本:业务需要单独去开发去理解,技术架构需要去适配
OLTP和OLAP的抉择
OLTP (On-Line Transaction Processing): 联机事务处理过程,一般按行存储,对实时性要求高,关心事务等特性,平常我们最常使用的Mysql这种。
OLAP(On-Line Analytic Processing): 联机分析处理过程,一般按列存储,因为数据分析一遍只关心一个表中几列数据,按行存储读取计算性能太差,另外按列存储可以更好的压缩。代表数据库 俄罗斯ClickHouse。
业务方在使用两种类型的数据库时,经常会遇到以下问题:
- 首先在很多业务场景中,OLTP和OLAP的界限并不那么明显。
- 一般OLAP的数据是离线异步从OLTP数据库同步过去的,需要一定的时间,在有些对实时性要求高的分析场景处理会比较麻烦,比如双11活动,需要根据最新的热点调整活动策略,当然此时可以通过flink 等流式计算中间件,但引入新的组件,又增加了复杂性和成本。
- 然后如果一份数据要同时支持两种业务场景,需要通过数据异构的方式同步到另一个存储中间间中,两份存储会有资源和运维的浪费。
于是就有了HTAP的引入:
HTAP (Hybrid Transactional and Analytical Processing): 同时支持OLTP和OLAP,这方面TiDB和OceanBase 都提供了支持
关键技术
CRDT 多写冲突合并
CRDT(Conflict-free Replicated Data Types,冲突自由复制数据类型)是一种分布式数据结构,旨在支持在多个节点上并发地进行读写操作,并在最终能够确保所有节点的数据最终一致,无需集中式协调或复杂的冲突解决机制。
工作原理:
- 数据结构:CRDT设计了一些特殊的数据结构,允许并发操作(如增量修改)而不发生冲突,常见的CRDT包括:
- 计数器(Counter):支持并发增减操作,最终能够合并到一个一致的值。
- 集合(Set):支持并发的元素添加、删除操作,最终合并为一致的集合。
- 有序集合(Ordered Set):在多个节点上进行元素的并发插入,并保持合适的顺序。
- 地图(Map):支持并发的键值对更新和合并操作。
- 合并操作:CRDT通过定义合并操作来解决不同节点上的修改。例如,两个不同节点上的计数器可以分别进行加法操作,最终将它们的结果合并,不会丢失数据。CRDT的合并操作是无冲突的,即使在不同节点上同时进行修改,合并时不会发生冲突或数据丢失。
- 无锁机制:CRDT避免了传统数据库系统中的锁机制,通过合并操作使数据副本能够独立更新,并最终通过一种确定性算法达到一致。这使得CRDT在高并发和高可用性场景下非常有效。
给所有 Operation 分配全球唯一的 HLC timestamp,作为操作的全排序依据。然后合并。
反熵 Anti-entropy 多写一致性修复
反熵(Anti-entropy) 是一种用来解决分布式系统中节点之间数据不一致的技术,主要应用于实现最终一致性。在多主复制或分布式系统中,由于节点可能会在网络分区、延迟或并发写入等情况下发生数据冲突,反熵的目标就是通过某种方式,确保这些节点最终达到一致性。
DynamoDB: 反熵就是树形的hash,用于快速比较数据是否一致的。扫描引擎层构建 merkle tree
Abase2: 版本向量是一种用于追踪并发修改的技术,每个节点都会在其数据项中维护一个版本号(向量)。每当节点执行写操作时,它会增加自己的版本号(不不是时间同步算法生成版本号),并将该版本号传递给其他节点进行同步。当数据同步时,节点会比较对方的版本向量,基于向量的顺序决定哪些修改需要合并,哪些修改已经包含。
对于同一个键来说,不同副本的版本会构成版本向量(version vector)
分布式时间同步
Hybrid Logical Clock(HLC) 是一种分布式系统中的时间同步算法,用于解决在分布式环境下,节点之间如何准确且高效地排序事件或操作的问题。HLC结合了传统的逻辑时钟和物理时钟的优势,旨在提供一个既能够保证事件顺序的一致性,又能够适应物理时间的变化的时间戳系统。
传统的逻辑时钟(如Lamport时钟)仅通过递增数字来保证事件顺序,但它不反映物理时间的变化。而物理时钟(如实际的系统时间)则能够提供现实世界中的时间信息,但其并不能保证事件的顺序。
HLC通过组合物理时钟和逻辑时钟的方式来为每个事件生成一个时间戳。具体来说,每个HLC时间戳由两个部分组成:
- 物理时间(Physical Time):当前节点的系统时钟的时间。
- 逻辑时间(Logical Time):基于先前事件的逻辑时钟递增数值。
HLC的时间戳形式通常为:(physical_time, logical_time),其中:
- physical_time 是当前时刻的物理时钟时间(例如 UNIX 时间戳),
- logical_time 是节点本地的逻辑时钟,在每次事件发生时递增。
HLC时间戳的生成和更新规则:
- 初始化时:每个节点会初始化一个本地的物理时钟和逻辑时钟。物理时钟通常使用系统当前时间,而逻辑时钟从0开始。
- 事件触发时:当事件发生时,节点会检查物理时钟(
T_phy),如果当前的物理时钟值比上次记录的物理时钟大,那么更新物理时钟,并将逻辑时钟重置为1;否则,逻辑时钟会递增。 - 接收到远程事件时:当一个节点接收到另一个节点的事件(带有时间戳
(T_phy', T_logic'))时,它会比较:- 物理时钟:如果远程事件的物理时间
T_phy'大于当前物理时钟T_phy,则更新本地物理时钟为T_phy'。 - 逻辑时钟:如果物理时间相同(
T_phy' == T_phy),则根据远程节点的逻辑时钟T_logic'来更新本地逻辑时钟,使其至少为T_logic' + 1。
- 物理时钟:如果远程事件的物理时间
分布式事务
两种方式
- 悲观,更新前就加锁,阻塞其它要更新这个key的事务。
- 乐观,更新后提交时先对每个key判断版本是否没新增,然后加锁,当所有key加锁成功后提交。
事务状态记录
- 第一个事务参与者做,没有单独的事务状态记录表
- 有单独的事务状态记录表。
Percolator
TiDB的事务和多版本控制算法,是在谷歌Percolator基础上略加修改实现的,实际上,谷歌Percolator也是很多New sql 发展的基石。Percolator算法可以理解为一种二阶段提交的改进版本。
相对于两阶段提交,Percolator有以下特点
- 将第一个事务参与者当成全局事务协调者
- 使用一个全局的时间戳进行版本控制,并且不仅在修改数据时,在事务提交时也会记录时间戳(避免了产生类似mysql readview这种比较重的逻辑)。
事务执行流程分为三个阶段
- 事务执行阶段:在proxy上完成,在内存中操作,并不真正落库
- 二阶段提交中的prepare阶段,校验锁冲突,获取锁。 perpare主要是加锁,但是如果原来的列有锁或者有新的值,都会回滚。相当于Prepare阶段和其他的parpare以及新提交是互斥的
- 二阶段提交中的commit阶段,依次释放锁,更新数据
乐观事务模型:事务执行时并不校验锁,只有提交的时候才会校验,先开始的事务不一定能提交,如下图,事务A先执行,但因为锁冲突会发生回滚。

- lock 就是prepare的锁,commit阶段会去掉,并在wirte字段标记是哪个事务提交了。方便后面其他事务判断上一个事务是否失败好清理。
读时强一致性读的话,会判断最后一个锁是否需要清理。
- 如何清理的?
- 如果遇到primary锁,可能当前事务还是活跃状态,会去查询活跃事务才有的token,如果有,则是活跃事务,不会清理,如果没有,说明不是活跃事务,进行回滚处理。
- 如果遇到secondary锁,则找到他的对应primary列数据,如果锁已经提交(primary锁已经释放),则将该行数据进行提交,如果没有的话,则走上面的流程。

ByteKV
ByteKV 大致采用了以下几种技术来实现分布式事务:
- 集群提供一个全局递增的逻辑时钟,每个读写请求都通过该模块分配一个时间戳,从而给所有请求都分配一个全局的顺序。
- 一个 Key 的每次更新都在系统中产生一个新的版本,保证新的写入不会影响到旧的读的快照。
- 在写请求的流程中引入两阶段提交,保证写入可以有序、原子性的提交。
- 原子性:把事务状态持久化保存在内部一个表里,本身是KV。
- 隔离性: 先来先服务,更改前如果有没提交的新版本就等待,类似MySQL行锁。读不影响,直接读上个提交版本的数据。
Multi-Raft
ByteRaft, 参考
作为一款分布式系统,容灾能力是不可或缺的。冗余副本是最有效的容灾方式,但是它涉及到多个副本间的一致性问题。采用Raft作为底层复制算法来维护多个副本间的一致性。ByteKV采用 Range 分片,每个分片对应一个 Raft 复制组,一个集群中会存在非常多的 Raft Group。组织、协调好 Raft Group 组之间的资源利用关系,对实现一个高性能的存储系统至关重要;同时在正确实现 Raft 算法基础上,灵活地为上层提供技术支持,能够有效降低设计难度。因此我们在参考了业界优秀实现的基础上,开发了一款 C++ 的 Multi-Raft 算法库ByteRaft
日志复制是 Raft 算法的最基本能力,ByteKV 将所有用户写入操作编码成 RedoLog,并通过 Raft Leader 同步给所有副本;每个副本通过回放具有相同序列的 RedoLog,保证了一致性。有时服务 ByteKV 的机器可能因为硬件故障、掉电等原因发生宕机,只要集群中仍然有多数副本存活,Raft 算法就能在短时间内自动发起选举,选出新的 Leader 进行服务。最重要的是,动态成员变更也被 Raft 算法所支持,它为 ByteKV 的副本调度提供了基础支持。ByteKV 的 KVMaster 会对集群中不同机器的资源利用率进行统计汇总,并通过加减副本的方式,实现了数据的迁移和负载均衡;此外,KVMaster 还定期检查机器状态,将长时间宕机的副本,从原有的复制组中摘除。
SQL转KV
- 一行数据映射为一个 KV,Key 以 TableID构造前缀,以行 ID 为后缀
- 一条索引映射为一个 KV,Key 以 TableID+IndexID构造前缀,以索引值构造后缀
多版本
类似mysql版mvcc实现的不足
每次事务开启前,需要记录一个ReadView, ReadView里面是活跃的事物id, 假设大容量高并发情况下,有10000个事务并行执行,每个事务的ReadView 集合大小也自然是10000个左右。那么总共就有10000*10000 = 1亿条数据。会占用上GB内存。并且计算层往往也不是单个节点的,活跃事务的统计也要跨节点进行汇总,也是一笔很大的开销。
ReadView 还会参与各种计算,比如判断某个事务id是否在ReadView中,这块数据量大了之后,消耗也比较大。
NoSQL多版本
- key里记录版本。Abase 1.0, TODO.
存储介绍
Abase
Abase2 就是多写, 2022年字节开发。 参考
- 推出了资源池化,支持多租户、多写、CRDT 的软硬件一体化设计的新一代 NoSQL 数据库 —— Abase2。
- CRDT 支持:确保多写架构下的数据能自动解决冲突问题,达成最终一致;
数据结构
- String: 支持 Set、Append、IncrBy,是字节线上使用最为广泛的数据模型;
- Hash/Set:使用率仅次于 String,在部分更新/查询的结构化数据存取场景中广泛使用;
- ZSet: 广泛应用于榜单拉链等在线业务场景,区别于直接使用 String+Scan 方式进行包装,Abase 在 ZSet 结构中做了大量优化,从设计上避免了大量 ZIncrBy 造成的读性能退化;
- List/TTLQueue: 队列接口语义使业务在对应场景下非常方便地接入。
核心模块如下图所示,整个 Partition 为 3 层结构:
- 数据模型层:如上文提到的 String, Hash 等 Redis 生态中的各类数据结构接口。
- 一致性协议层:在多主架构下,多点写入势必会造成数据不一致,Anti-Entropy 一方面会及时合并冲突,另一方面将协调冲突合并后的数据下刷至引擎持久化层并协调 WAL GC。
- 数据引擎层:数据引擎层首先有一层轻量级数据暂存层(或称 Conflict Resolver)用于存储未达成一致的数据;下层为数据数据引擎持久化层,为满足不同用户多样性需求,Abase2 引设计上采用引擎可插拔模式。对于有顺序要求的用户可以采用 RocksDB,TerarkDB 这类 LSM 引擎,对于无顺序要求点查类用户采用延迟更稳定的 LSH 引擎。
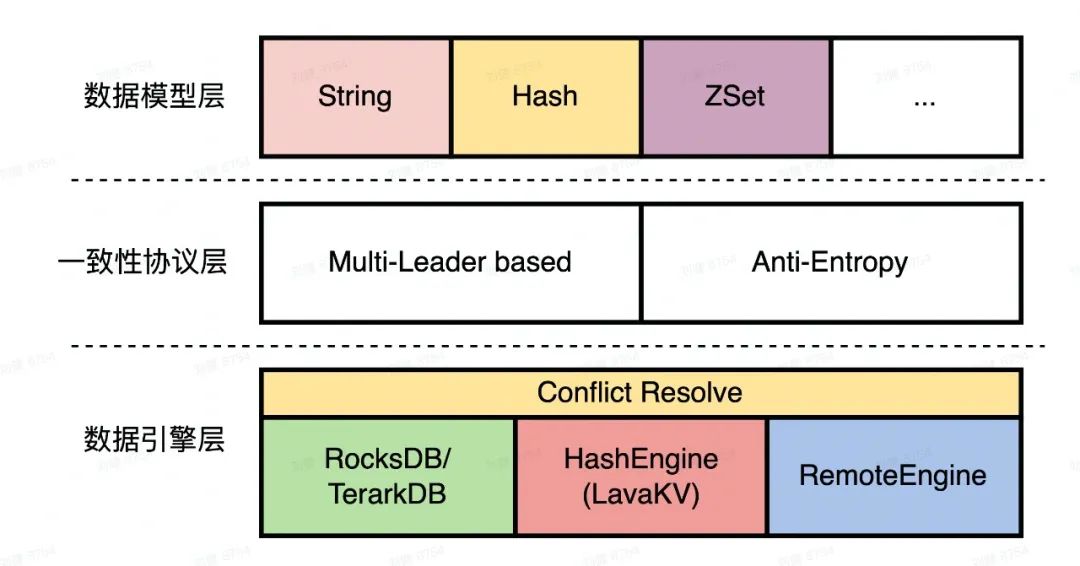
Abase2 目前支持两种同步协议来支持不同一致性的需求:
多主模式(Multi-Leader):相对于数据强一致性,Abase 的大多数使用者们则对系统可用性有着更高的需求,Abase2 主要通过多主技术实现系统高可用目标。在多主模式下,分片的任一副本都可以接受和处理读写请求,以确保分片只要有任一副本存活,即可对外提供服务。同时,为了避免多主架构按序同步带来的一些可用性降低问题, 我们结合了无主架构的优势,在网络分区、进程重启等异常恢复后,并发同步最新数据和老数据。此外,对于既要求写成功的数据要立即读到,又不能容忍主从切换带来的秒级别不可用的用户,我们提供无更新场景下的写后读一致性给用户进行选择。实现方式是通过 Client 配置 Quorum 读写(W+R>N),通常的配置为 W=3,R=3,N=5。
单主模式(Leader&Followers):Abase2 支持与一代系统一样的主从模式,并且,半同步适合于对一致性有高要求,但可以忍受一定程度上可用性降低的使用场景。与 MySQL 半同步类似。系统将选择唯一主副本,来处理用户的读写请求,保证至少 2 个副本完成同步后,才会通知用户写入成功。以保证读写请求的强一致性,并在单节点故障后,新的主节点仍然有全量数据。
Anti-Entropy
- 为了解决网络抖动等导致的数据不一致问题,Abase2采用了Anti-Entropy机制。通过比对各副本的ReplicaLog进度,异步地修复数据不一致,确保数据最终一致性。
- ReplicaLog:每个副本都维护自己的进度日志,并通过定期同步其他副本的日志来确保一致性。与类似DynamoDB、Cassandra的merkle tree方法相比,Abase2通过更高效的内存比对和数据修复机制,节省了性能开销。
冲突解决
- 多点写入的情况下可能会发生数据冲突,Abase2通过Hybrid Logical Clock (HLC) 算法生成全局唯一时间戳来标识数据版本。通过HLC时间戳,系统可以根据时间来判断哪个写操作更“新”,从而解决冲突。
- 对于幂等类命令如 Set。为了满足大部分业务需求,Abase2采用了Last Write Wins (LWW) 策略,即保留时间戳最晚的写入版本。
CRDT支持
- 为了兼容Redis的复杂数据操作,Abase2对Redis的数据结构(如
String、Hash、ZSet)进行了CRDT(Conflict-free Replicated Data Types)支持,确保在多写场景下数据冲突能够自动解决。 - 采用Operation-based CRDT,每个写操作都分配一个全局唯一的HLC时间戳,操作日志经过定期合并,保证最终一致性。
- 对于非幂等操作(如
IncrBy)的兼容,通过记录操作日志并排序合并,实现了复杂操作的最终一致性。
ByteKV
基于 Range 分区的强一致 KV 存储系统 ByteKV。
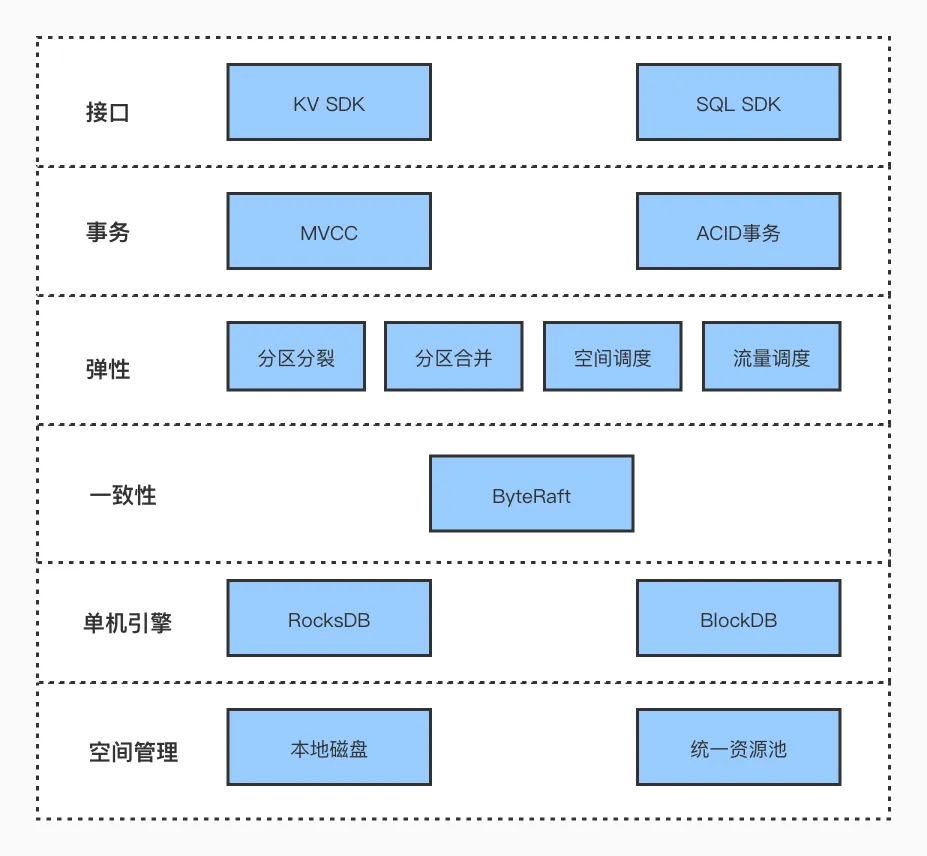
如上图所示是 ByteKV 的分层结构。
- 接口层对用户提供 KV SDK 和 SQL SDK,其中 KV SDK 提供简单的 KV 接口,SQL SDK 提供更加丰富的 SQL 接口,满足不同业务的需求。
- 事务层提供全局一致的快照隔离级别(Snapshot Isolation),通过全局时间戳和两阶段提交保证事务的 ACID 属性。
- 弹性伸缩层通过 Partition 的自动分裂合并以及 KVMaster 的多种调度策略,提供了很强的水平扩展能力,能够适应业务不同时期的资源需求。
- 一致性协议层通过自研的 ByteRaft 组件,保证数据的强一致性,并且提供多种部署方案,适应不同的资源分布情况。
- 存储引擎层采用业界成熟的解决方案 RocksDB,满足前期快速迭代的需求。并且结合系统未来的演进需要,设计了自研的专用存储引擎 BlockDB。
- 空间管理层负责管理系统的存储空间,数据既可以存储在物理机的本地磁盘,也可以接入其他的共享存储进行统一管理。
ByteKV 大致采用了以下几种技术来实现分布式事务:
- 集群提供一个全局递增的逻辑时钟,每个读写请求都通过该模块分配一个时间戳,从而给所有请求都分配一个全局的顺序。
- 一个 Key 的每次更新都在系统中产生一个新的版本,保证新的写入不会影响到旧的读的快照。
- 在写请求的流程中引入两阶段提交,保证写入可以有序、原子性的提交。
- 原子性:把事务状态持久化保存在内部一个表里,本身是KV。
- 隔离性: 先来先服务,更改前如果有没提交的新版本就等待,类似MySQL行锁。读不影响,直接读上个提交版本的数据。
Key里面会包含版本。
ByteKV 使用两阶段提交来实现分布式事务,其大致思想是整个过程分为两个阶段:第一个阶段叫做 Prepare 阶段,这个阶段里协调者负责给参与者发送 Prepare 请求,参与者响应请求并分配资源、进行预提交(预提交数据我们叫做 Write Intent);第一个阶段中的所有参与者都执行成功后,协调者开始第二个阶段即 Commit 阶段,这个阶段协调者提交事务,并给所有参与者发送提交命令,参与者响应请求后把 Write Intent 转换为真实数据。
首先是如何保证事务原子性对外可见?这个问题本质上是需要有持久化的事务状态,并且事务状态可以被原子地修改。业界有很多种解法,ByteKV 采用的方法是把事务的状态当作普通数据,单独保存在一个内部表中。我们称这张表为事务状态表,和其他业务数据一样,它也分布式地存储在多台机器上。事务状态表包括如下信息:
- 事务状态:包括事务已开始,已提交,已回滚等状态。事务状态本身就是一个 KV,很容易做到原子性。
- 事务版本号:事务提交时,从全局递增时钟拿到的时间戳,这个版本号会被编码进事务修改的所有 Key 中。
- 事务 TTL:事务的超时时间,主要为了解决事务夯死,一直占住资源的情况。其他事务访问到该事务修改的资源时,如果发现该事务已超时,可以强行杀死该事务。
在事务状态表的辅助下,第二阶段中协调者只需要简单地修改事务状态就能完成事务提交、回滚操作。一旦事务状态修改完成,即可响应客户端成功, Write Intent 的提交和清理操作则是异步地进行。
第二个问题是如何保证事务间的隔离和冲突处理?ByteKV 会对执行中的事务按照先到先得的原则进行排序,后到的事务读取到 Write Intent 后进行等待,直到之前的事务结束并清理掉 Write Intent 。Write Intent 对于读请求不可见,如果 Write Intent 指向的事务 Prepare 时间大于读事务时间,那么 Write Intent 会被忽略;否则读请求需要等待之前的事务完成或回滚,才能知道这条数据是否可读。等待事务提交可能会影响读请求的延迟,一种简单的优化方式是读请求将还未提交的事务的提交时间戳推移到读事务的时间戳之后。前面说了这么多 Write Intent,那么 Write Intent 到底是如何编码的使得处于事务运行中还没有提交的数据无法被其他事务读到?这里也比较简单,只需要把 Write Intent 的版本号设置为无穷大即可。
ByteKV 采用 Range 分区的方式提供扩展性,这种分区方式带来的一个问题是:随着业务发展,原有的分区结构不再适用于新的业务模式。比如业务写入热点变化,热点从一个分区漂移到另一个分区。为了解决这个问题,ByteKV 实现了自动分裂的功能:通过对用户写入进行采样,当数据量超过一定阈值后,从中间将 Range 切分为两个新的 Range。分裂功能配合上调度,提供了自动扩展的能力。
字节表格存储 ByteSQL
ByteSQL, 基于byteKV
在表格存储模型中,数据按照数据库(database), 表(table)两个逻辑层级来组织和存放。同一个物理集群中可以创建多个数据库,而每个数据库内也可以创建多个表。表的 Schema 定义中包含以下元素:
- 表的基本属性,包括数据库名称,表名称,数据副本数等。
- 字段定义:包含字段的名字,类型,是否允许空值,默认值等属性。一个表中须至少包含一个字段。
- 索引定义:包含索引名字,索引包含的字段列表,索引类型(Primary Key,Unique Key,Key 等)。一个表中有且仅有一个主键索引(Primary Key),用户也可以加入二级索引(Key 或 Unique Key 类型)来提高 SQL 执行性能。每个索引都可以是单字段索引或多字段联合索引。
表中的每一行都按照索引被编码成多个 KV 记录保存在 ByteKV 中,每种索引类型的编码方式各不相同。Primary Key 的行中包含表中的所有字段的值,而二级索引的行中仅仅包含定义该索引和 Primary Key 的字段。
Primary Key: pk_field1, pk_field2,... => non_pk_field1, non_pk_field2...
Unique Key: key_field1, key_field2,...=> pk_field1, pk_field2...
NonUnique Key: key_field1, key_field2,..., pk_field1, pk_field2...=> <null>
这个和TiDB实现一样。
其中 pk_field 是定义 Primary Key 的字段,non_pk_field 是表中非 Primary Key 的字段,key_field 是定义某个二级索引的字段。=> 前后的内容分别对应 KV 层的 Key 和 Value 部分。Key 部分的编码依然采用了上述提到的内存可比较编码,从而保证了字段的自然顺序与编码之后的字节顺序相同。而 Value 部分采用了与 protobuf 类似的变长编码方式,尽量减少编码后的数据大小。每个字段的编码中使用 1 byte 来标识该值是否为空值。
ByteSQL 实现了全局二级索引,将主键的数据和二级索引的数据分布在 ByteKV 的不同的分片中,只根据二级索引上的查询条件即可定位到该索引的记录,进一步定位到对应的主键记录。这种方式避免了扫描所有 Shard 做结果归并的开销,也可以通过创建 Unique Key 支持全局唯一性约束,具有很强的水平扩展性。
ByteSQL 基于 ByteKV 的多版本特性和多条记录的原子性写入(WriteBatch),实现了支持快照隔离级别(Snapshot Isolation)的读写事务,其基本实现思路如下:
- 用户发起 Start Transaction 命令时,ByteSQL 从 ByteKV Master 获取全局唯一的时间戳作为事务的开始时间戳(Start Timestamp),Start Timestamp 既用作事务内的一致性快照读版本,也用作事务提交时的冲突判断。
- 事务内的所有写操作缓存在 ByteSQL 本地的 Write Buffer 中,每个事务都有自己的 Write Buffer 实例。如果是删除操作,也要在 Write Buffer 中写入一个 Tombstone 标记。
- 事务内的所有读操作首先读 Write Buffer,如果 Write Buffer 中存在记录则直接返回(若 Write Buffer 中存在 Tombstone 返回记录不存在);否则尝试读取 ByteKV 中版本号小于 Start Timestamp 的记录。
- 用户发起 Commit Transaction 命令时,ByteSQL 调用 ByteKV 的 WriteBatch 接口将 Write Buffer 中缓存的记录提交,此时提交是有条件的:对于 Write Buffer 中的每个 Key,都必须保证提交时不能存在比 Start Timestamp 更大的版本存在。如果条件不成立,则必须 Abort 当前事务。这个条件是通过 ByteKV 的 CAS 接口来实现的。
由上述过程可知,ByteSQL 实现了乐观模式的事务冲突检测。这种模式在写入冲突率不高的场景下非常高效。如果冲突率很高,会导致事务被频繁 Abort。
这个分布式事务有点类似google的Percolater事务。也就是TiDB在用的使用。
HDFS
HDFS 全名 Hadoop Distributed File System,是业界使用最广泛的开源分布式文件系统。原理和架构与 Google 的 GFS 基本一致。它的特点主要有以下几项:
- 和本地文件系统一样的目录树视图
- Append Only 的写入(不支持随机写)
- 顺序和随机读
- 超大数据规模
- 易扩展,容错率高
支持了 EB 级别的数据量。
当前在字节跳动 HDFS 承载的主要业务:
- Hive,HBase,日志服务,Kafka 数据存储
- Yarn,Flink 的计算框架平台数据
- Spark,MapReduce 的计算相关数据存储
HBase
分布式表格存储系统在业界拥有广泛的应用场景。Google 先后发布了 Bigtable 和 Spanner 两代分布式表格存储系统,承接了其公司内部和外部云服务中的所有表格存储需求。其中 Bigtable 的开源实现 HBase 在国内外公司中都得到了广泛的使用,并且开源的图数据库 JanusGraph 、时序数据库 OpenTSDB 、地理信息数据库 GeoMesa、关系型数据库 Phoenix 等底层都是基于 HBase 进行数据存储的。
使用了lsm树来作为存储结构,基于Google Bigtable 论文的开源实现,底层依赖HDFS,分布式表格。
https://mafulong.eu.org/2021/01/09/hbase%E6%9E%B6%E6%9E%84/
range分区。
适合写多读少。
DynamoDB
多主写入。
Paxos数据复制。
读接口支持强一致性的读和最终一致性的读。
事务支持可序列化和读已提交。
DynamoDB 与 Dynamo 的区别
虽然 DynamoDB 和 Dynamo 都是基于类似的分布式系统架构设计,但它们之间有一些明显的差异:
架构和实现
- Dynamo 是一个开源的、分布式的键值存储系统,用于亚马逊内部的大规模应用。
- DynamoDB 是基于 Dynamo 的设计理念构建的托管云服务,由 Amazon 提供并作为 AWS 的一部分,面向开发者提供的商业化服务。
写入模式
- Dynamo:采用 无主写入(write-anywhere)模型,允许任何节点进行写入,写入可能发生冲突,后续通过合并机制解决冲突。
- DynamoDB:采用 多主写入(multi-master replication)模型,每个分区(副本)都有一个主节点,可以同时接收写请求,确保高可用性和容错性,并使用 最终一致性 或 强一致性 模式进行数据同步。
一致性模型
- Dynamo:采用 最终一致性 模型,这意味着写操作可能不会立即反映到所有副本上,但最终会达到一致。写操作可能会发生冲突,系统通过冲突解决机制(如版本向量)来处理冲突。
- DynamoDB:提供 最终一致性 和 强一致性(可选择)模型。用户可以选择适合应用的模式,DynamoDB 还提供了像 事务性写入 这样的高级特性,确保在多项写操作之间保持一致性。
冲突解决
- Dynamo:没有中心主节点,因此它必须依靠冲突解决策略(如版本向量和 LWW)来解决数据冲突。
- DynamoDB:虽然使用类似的冲突解决机制,但它也提供了事务支持,可以在某些场景下强制保证一致性,不依赖于最终一致性来处理冲突。
可用性和容错
- DynamoDB:通过多副本机制,确保每个分区都有冗余副本,容忍节点故障,提高了整体的容错性和可用性。DynamoDB 也会自动处理故障恢复和负载均衡。
TiDB
TiKV :负责数据的存储,一致性保证,高可用保证,底层基于RocksDb(lsm树)

主流厂商类似方案
| 厂商 | 备注 | |
|---|---|---|
| ByteSql | 字节跳动 | 对标F1进行开发。底层依赖ByteKV,ByteKV和上面介绍的TiKV比较类似。和TiDB总体比较相似 |
| OceanBase | 蚂蚁金服 | 也是业界知名的分布式数据库之一,但和TiDB 底层设计上略有些不同 |
| F1 | 去中心化分布式数据库鼻祖,底层依赖Googel Spanner(后面Spanner也独立发展,支持了sql模块) | |
| TDSQL | 腾讯云 | 有多种存储引擎,其中一种是类似于TiDB的lsm存储引擎 |

如何分区
TiKV 自动将底层数据按照 Key 的 Range 进行分片。每个 Region 是一个 Key 的范围,从 StartKey 到 EndKey 的左闭右开区间。Region 中的 Key-Value 总量超过一定值(96M),就会自动分裂。
因为对分区大小的控制比较严格,保证了读取数据时,lsm树的读取的最大延迟是可控的。
架构:
- 每个Region都是一个RocksDB, 每个Region有多个备份节点,共同组成一个RaftGroup,在同一RaftGroup组里面,通过Raft协议进行数据同步和高可用保证(故障时主从切换)。
- 架构设计层面: 一个是严格控制lsm树的容量,使其层数或容量不会过大,当容量较大时,自动进行拆分(TiDB 的单个lsm树超过96M就会自动拆分)。二是通过缓存和布隆过滤器优化读的性能。
- 另外lsm树读取速度不快,是平均而言的,大部分情况下,很多数据只关心最近创建的或者说越是最近创建的访问的概率越高,比如评论数据,下单数据,快递数据等等。这些情况下,最新的数据还没有下沉到Lsm树最下面几层,访问速度会快很多。
支持SQL和索引:
TiDB 自动将 SQL 结构映射为 KV 结构。具体的可以参考 《三篇文章了解 TiDB 技术内幕 - 说计算》 这篇文档。简单来说,TiDB 做了两件事:
- 一行数据映射为一个 KV,Key 以 TableID构造前缀,以行 ID 为后缀
- 一条索引映射为一个 KV,Key 以 TableID+IndexID构造前缀,以索引值构造后缀
- 唯一索引的value是主键, 非唯一索引的value是null, key里包含主键
TiDB 同时支持主键和二级索引(包括唯一索引和非唯一索引)。与表数据映射方案类似,TiDB 为表中每个索引分配了一个索引 ID,用 IndexID 表示。
对于主键和唯一索引,我们需要根据键值快速定位到对应的 RowID,因此,按照如下规则编码成 (Key, Value) 键值对:
Key:   tablePrefix{tableID}_indexPrefixSep{indexID}_indexedColumnsValue
Value: RowID
对于不需要满足唯一性约束的普通二级索引,一个键值可能对应多行,我们需要根据键值范围查询对应的 RowID。 因此,按照如下规则编码成 (Key, Value) 键值对:
Key:   tablePrefix{TableID}_indexPrefixSep{IndexID}_indexedColumnsValue_{RowID}
Value: null
分布式事务使用谷歌Percolator, 提交时校验,乐观模式。
选举和同步:Raft. 在数据同步方面,和mysql利用binLog同步不同,TiDB 的存储节点主从同步是依赖于Raft的数据同步协议的,能够更精准和更低的延迟。
如何支持OLAP?
- 主备库物理分离。TiDB 是计算和存储分离的架构,底层的存储是多副本机制,可以把其中一些副本转换成列式存储的副本。OLAP 的请求可以直接打到列式的副本上,也就是 TiFlash 的副本来提供高性能列式的分析服务,做到了同一份数据既可以做实时的交易又做实时的分析
OceanBase
按照Range分区
分区之间,通过 Multi-Paxos 协议来同步数据:每一个逻辑分区都会有多个副本分布在多台机器上,只有其中一个副本会成为 leader,并接受写请求。这里的架构和 PolarDB 一样了,此时,客户端的一致性读需要网关(OBProxy)来判断,主从之间的同步是有可感知的延迟的。
OceanBase 用内存 B+ 树和磁盘 LSM-Tree 共同构成了数据读写体系
为了提升缓存命中率,OceanBase 设计了很多层内存缓存,尽全力避免了对磁盘的随机读取,只让 LSM-Tree 的磁盘承担它擅长的连续读任务
OLAP和TiDB类似,有个列式存储。
VS TidB:
- TiDB是Key+Range分区, 这个只有Range
- Tidb: Raft, 这个是Paxos
- 这个主要是内存缓存支持SQL,避免随机读取。