go之QA
New, make
- make 仅用来分配及初始化类型为 slice、map、chan 的数据。
- new 可分配任意类型的数据,根据传入的类型申请一块内存,返回指向这块内存的指针,即类型 *Type。
- make 返回引用,即 Type,new 分配的空间被清零, make 分配空间后,会进行初始。
共同点: 给变量分配内存
对比:
new(T) | make(T, args...) | |
|---|---|---|
| 适用类型 | 任何类型(struct、int、float 等) | 仅适用于 slice、map、channel |
| 返回值 | 指向 T 的指针 *T | T 本身(非指针) |
| 作用 | 仅分配内存,不初始化 | 分配内存并初始化 |
| 使用方式 | p := new(int) | s := make([]int, 5) |
| 示例返回值 | *T(指针) | T(值类型) |
New
new是分配空间的,可以看做零值初始化。有初始化,但字段值都是零值。
new(T) 分配内存,返回 *T 指针,字段会变成零值,可以安全使用。
var p *T 不分配内存,p 默认是 nil,不能直接使用,否则会导致空指针错误。
p := new(Person) // 分配内存, 不是nil
p.name = "Alice" // ✅ 直接使用
Go语言函数传参是值类型还是引用类型?
- 在Go语言中只存在值传递,要么是值的副本,要么是指针的副本。无论是值类型的变量还是引用类型的变量亦或是指针类型的变量作为参数传递都会发生值拷贝,开辟新的内存空间。
- 另外值传递、引用传递和值类型、引用类型是两个不同的概念,不要混淆了。引用类型作为变量传递可以影响到函数外部是因为发生值拷贝后新旧变量指向了相同的内存地址。
为啥说go不是引用传递,如果形参和实验地址一样的,那是引用传递,但事实不是,因此和c+不通。c+ 传递的引用其实就是指针的拷贝,而 go 传递的是指针上层结构体的拷贝。
Go语言中的内存对齐了解吗?
CPU 访问内存时,并不是逐个字节访问,而是以字长(word size)为单位访问。比如 32 位的 CPU ,字长为 4 字节,那么 CPU 访问内存的单位也是 4 字节。
CPU 始终以字长访问内存,如果不进行内存对齐,很可能增加 CPU 访问内存的次数,例如:
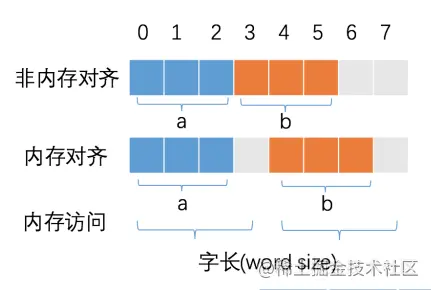
变量 a、b 各占据 3 字节的空间,内存对齐后,a、b 占据 4 字节空间,CPU 读取 b 变量的值只需要进行一次内存访问。如果不进行内存对齐,CPU 读取 b 变量的值需要进行 2 次内存访问。第一次访问得到 b 变量的第 1 个字节,第二次访问得到 b 变量的后两个字节。
也可以看到,内存对齐对实现变量的原子性操作也是有好处的,每次内存访问是原子的,如果变量的大小不超过字长,那么内存对齐后,对该变量的访问就是原子的,这个特性在并发场景下至关重要。
简言之:合理的内存对齐可以提高内存读写的性能,并且便于实现变量操作的原子性。
两个 interface 可以比较吗?
- 判断类型是否一样
reflect.TypeOf(a).Kind() == reflect.TypeOf(b).Kind()
- 判断两个interface{}是否相等
reflect.DeepEqual(a, b interface{})
其他:将一个interface{}赋值给另一个interface{}
reflect.ValueOf(a).Elem().Set(reflect.ValueOf(b))
go 打印时 %v %+v %#v 的区别?
- %v 只输出所有的值;
- %+v 先输出字段名字,再输出该字段的值;
- %#v 先输出结构体名字值,再输出结构体(字段名字+字段的值);
package main
import "fmt"

type student struct {
	id   int32
	name string
}

func main() {
	a := &student{id: 1, name: "微客鸟窝"}

	fmt.Printf("a=%v	\n", a) // a=&{1 微客鸟窝}
	fmt.Printf("a=%+v	\n", a) // a=&{id:1 name:微客鸟窝}
	fmt.Printf("a=%#v	\n", a) // a=&main.student{id:1, name:"微客鸟窝"}
}
空 struct{} 占用空间么?
可以使用 unsafe.Sizeof 计算出一个数据类型实例需要占用的字节数:
package main

import (
	"fmt"
	"unsafe"
)

func main() {
	fmt.Println(unsafe.Sizeof(struct{}{}))  //0
}
复制代码
空结构体 struct{} 实例不占据任何的内存空间。
空 struct{} 的用途?
因为空结构体不占据内存空间,因此被广泛作为各种场景下的占位符使用。
将 map 作为集合(Set)使用时,可以将值类型定义为空结构体,仅作为占位符使用即可。不发送数据的信道(channel)
使用 channel 不需要发送任何的数据,只用来通知子协程(goroutine)执行任务,或只用来控制协程并发度。
逃逸分析
「逃逸分析」就是程序运行时内存的分配位置(栈或堆),是由编译器来确定的。堆适合不可预知大小的内存分配。但是为此付出的代价是分配速度较慢,而且会形成内存碎片。
逃逸场景:
- 指针逃逸 返回局部变量指针
- 栈空间不足逃逸
- 动态类型逃逸 函数参数为 interface{},编译期间很难确定其参数的具体类型,也会发生逃逸。
- 闭包引用对象逃逸
小结:
- 栈上分配内存比在堆中分配内存效率更高
- 栈上分配的内存不需要 GC 处理,而堆需要
- 逃逸分析目的是决定内分配地址是栈还是堆
- 逃逸分析在编译阶段完成
for range读channel
for range 可以遍历通道( channel ),但是通道在遍历时,只输出一个值,即管道内的类型对应的数据。
Context
有几个方法创建Context:
WithCancel、WithTimeout、WithDeadline:传入一个父的Context类型值,返回一个新的可取消的Context和用于取消该返回Context的函数,同时保证父Context取消后该子Context也会被取消。WithTimeout、WithDeadline: 内部存在了一个定时器,到时间点后会自动帮我们调用取消函数。
有哪些方法:
type Context interface {
        Deadline() (deadline time.Time, ok bool)
        Done() <-chan struct{}
        Err() error
        Value(key interface{}) interface{}
}
Deadline:获取是否设置了到期时间以及所设置的截止时间。如果有设置过期时间的话,Context会到那个时间点时自动发起取消Context的操作。Done:返回一个通道,如果通道关闭则代表该Context已经被取消;如果返回的为nil,则代表该Context是一个永远不会被取消的Context。Err:返回该Context被取消的原因,如果只使用Context包的Context类型的话,那么只可能返回Canceled(代表被明确取消)或者DeadlineExceeded(因超时而取消)Value:你可能经常看到代码中使用该函数从ctx中获取一个string key中的值,即一个Context内部是可以携带很多kv的, 关于如何存储,可以想象成一个树中的某个节点,每个节点保存了指向父节点的指针,从当前的节点一层层向根节点寻找
如果我们把一个网络请求的处理看做是一个任务的话,使用Context帮助我们在子任务树中传递取消任务的信号,并可以根据WithXXX生成新的子Context传递到下游子任务中,整体呈现出一个树状结构。上层Context被取消后会沿着树向下递归的告知所衍生的所有Context该任务被取消。相反的,子Context被取消并不会影响到其父Context是否被取消。另外,Context还可以携带kv在任务中传递。

当超时或者取消时:会递归取消每个child,向下传入,但不会向上传递。实现上是parent记录了children集合。
context是并发安全的
在 Go 的
context.Context中,键值对(KV)是向上查找的。当你通过
ctx.Value(key)检索值时,Go 的context包会按照上下文的层级从当前上下文向其父上下文逐级查找,直到找到对应的键。如果层级较深,查找的性能可能会受到影响。context.TODO() 返回一个空的 context,常用于重构时期,没有合适的 context 可用。 todo 通常用在并不知道传递什么 context的情形。例如,调用一个需要传递 context 参数的函数,你手头并没有其他 context 可以传递,这时就可以传递 todo。
type cancelCtx struct {
    Context
    // 保护之后的字段
    mu       sync.Mutex
    done     chan struct{}
    children map[canceler]struct{}
    err      error
}
cancel函数
- 关闭
done通道,通知select { case <-ctx.Done() } - 取消所有子
cancelCtx - 递归从父
Context移除自己。- ✅ 避免内存泄露: 如果不移除
cancelCtx,父Context的children仍然会保存对cancelCtx的引用,即使cancelCtx已经取消,这会导致不必要的资源占用。 - ✅ 防止无用通知: 如果不移除,父
Context在取消时仍然会尝试通知已经被取消的cancelCtx,造成额外的 CPU 资源消耗。
- ✅ 避免内存泄露: 如果不移除
func (c *cancelCtx) cancel(removeFromParent bool, err error) {
    c.mu.Lock()
    if c.err != nil { // 已经取消过了
        c.mu.Unlock()
        return
    }
    c.err = err // 记录取消原因
    close(c.done) // 关闭 `done` 通道,通知所有等待的 Goroutine

    for child := range c.children { // 递归取消所有子 context
        child.cancel(false, err)
    }
    c.children = nil
    c.mu.Unlock()

    if removeFromParent {
        removeChild(c.Context, c) // 从父 context 中移除
    }
}
自定义M/P/G上限数量?
M默认limit 10000 可自定义,但一般不需要。
P就是GOMAXPROCS, 可自定义,默认cpu核数
G数量,无限制。不可自定义。但受内存影响,可监控。
go性能工具
Go 语言提供了多种 性能分析工具(Profiling Tools),用于检测 CPU、内存、协程等资源的使用情况,帮助优化程序性能。
- pprof(Performance Profiler)
- Go 内置的性能分析工具,可用于 CPU、内存、Goroutine、Block 等分析。
- 使用方式:
import _ "net/http/pprof" go func() { log.Println(http.ListenAndServe("localhost:6060", nil)) }() - 访问方式:
go tool pprof http://localhost:6060/debug/pprof/profile?seconds=30(CPU Profile)go tool pprof http://localhost:6060/debug/pprof/heap(Heap Profile)
- 可以使用
pprof -http=:8081生成可视化分析结果。
- trace(Go 运行时跟踪分析)
go test -trace trace.out生成 Go 执行流程跟踪日志。- 使用
go tool trace trace.out进行可视化分析。 - 适用于分析 Goroutine 调度、系统调用、垃圾回收等 问题。
- race(数据竞争检测)
go run -race main.go运行程序时检测 数据竞争(Data Race) 问题。go test -race测试代码时检测并发访问问题。
- benchmark(性能基准测试)
go test -bench运行基准测试:func BenchmarkExample(b *testing.B) { for i := 0; i < b.N; i++ { someFunction() } }- 使用
-benchmem统计内存分配情况。
- delve(Go 调试工具)
dlv debug ./main运行调试模式,可用于 断点调试、内存查看、性能分析。dlv trace进行系统调用跟踪。
- perf(Linux 性能分析)
perf record -g ./program记录 Go 进程的 CPU 使用情况。perf report分析性能热点。
- flamegraph(火焰图)
go tool pprof -http=:8080 cpu.prof可生成 火焰图(Flame Graph),可视化查看热点函数。- 也可以结合
Flamegraph工具(https://github.com/brendangregg/FlameGraph)分析perf采样数据。
- go-metrics(第三方监控工具)
- prometheus+grafana 结合
expvar进行监控。 uber-go/tally进行统计分析。
- prometheus+grafana 结合
总结
- pprof:最常用,支持 CPU、内存、协程、锁分析。
- trace:分析 Goroutine 调度、系统调用,适用于性能调优。
- race:检测 数据竞争,适用于并发程序。
- benchmark:基准测试,评估函数执行效率。
- delve:Go 调试,支持断点调试、变量查看。
- perf + flamegraph:深入分析 Linux 内核级性能瓶颈。
综合使用这些工具,可以全面优化 Go 程序的性能。
基础数据类型和语法
map和数组
- Go 语言中只要是可比较的类型都可以作为 key。除开 slice,map,functions 这几种类型,其他类型都是 OK 的。包括float
- 在 Go 中,数组是值。作为参数传进函数时,传递的是数组的原始值拷贝,此时在函数内部是无法更新该数组的
- golang 检测map是否存在某个key. 检查 key 是否存在可以用 map 直接访问,检查返回的第二个参数即可。不能通过取出来的值来判断 key 是不是在 map 中,因为会返回零值。
- 从 slice 中重新切出新 slice 时,新 slice 会引用原 slice 的底层数组。
- nil 切片和空切片指向的地址不一样。nil 空切片引用数组指针地址为 0(无指向任何实际地址)
- 空切片的引用数组指针地址是有的,且固定为一个值
go slice 和 array 区别?
大小和可变性
- 数组:固定长度
- 切片:动态数组
内部结构:
- 数组:值传递
- 切片:引用传递
使用场景:
- 数组:固定数量的元素
- 切片:更适合处理大小可变的序列
string
- string 类型的值是常量,不可更改
- 当进行 string 和 byte slice 相互转换时,参与转换的是拷贝的原始值。在 map[string] 中查找 key 时,使用了对应的 []byte,避免做 m[string(key)] 的内存分配
- string 的值不必是 UTF8 文本,可以包含任意的值。只有字符串是文字字面值时才是 UTF8 文本,字串可以通过转义来包含其他数据。
- Go 的内建函数 len() 返回的是字符串的 byte 数量,而不是像 Python 中那样是计算 Unicode 字符数。
- string 类型的变量值不能为 nil。 string手动赋值nil后不会报错但也不等于nil。 请用”“、
字符串转成byte数组,会发生内存拷贝。
switch 语句中的 case 代码块会默认带上 break
- go map value 非指针,不可更新。下面代码报错。 核心原因 Go 中 map 的元素不是 addressable(不可寻址)的,如果 value 是 struct 类型,返回的是 struct 的“副本”而非“引用”,因此不能直接修改其字段。
type Student struct {
	name string
}

func main() {
	m := map[string]Student{"people": {"zhoujielun"}}
	m["people"].name = "wuyanzu"
}
解析:
map的value本身是不可寻址的,因为map中的值会在内存中移动,并且旧的指针地址在map改变时会变得无效。故如果需要修改map值,可以将 map中的非指针类型value,修改为指针类型,比如使用map[string]*Student.
- for range
type student struct {
	Name string
	Age  int
}

func pase_student() {
	m := make(map[string]*student)
	stus := []student{
		{Name: "zhou", Age: 24},
		{Name: "li", Age: 23},
		{Name: "wang", Age: 22},
	}
	for _, stu := range stus {
		m[stu.Name] = &stu
	}
}
解析:
golang 的 for ... range 语法中,stu 变量会被复用,每次循环会将集合中的值复制给这个变量,因此,会导致最后m中的map 中储存的都是stus最后一个student的值。
- 组合没有继承
type People struct{}

func (p *People) ShowA() {
	fmt.Println("showA")
	p.ShowB()
}
func (p *People) ShowB() {
	fmt.Println("showB")
}

type Teacher struct {
	People
}

func (t *Teacher) ShowB() {
	fmt.Println("teacher showB")
}

func main() {
	t := Teacher{}
	t.ShowA()
}
解析:
输出结果为showA、showB。golang 语言中没有继承概念,只有组合,也没有虚方法,更没有重载。因此,*Teacher 的 ShowB 不会覆写被组合的 People 的方法。
go GC
Golang 1.5后,采取的是“非分代的、非移动的、并发的、三色的”标记清除垃圾回收算法。
标记-清除的过程,其它类似的还有标记复制、分代、引用计数等。
为并发而设计的,尽可能减少STW的时间。
类似Dfs, 从根对象,开始遍历,未遍历的是白色,根据对象的引用,不断遍历,遍历完的是黑色,最后把白色对象的内存进行回收。
为了避免扫描中,并发的内存操作,造成一些对象可达性丢失,造成错误回收,有两个三色不变色要求。然后引入了插入写屏障、删除写屏障。
Go 1.8更新为了混合写屏障,主要回收堆对象,对栈对象只扫描一遍,避免回收栈上指向的堆对象。混合写屏障开关需要STW。
Mark时,将扫描任务作为多个并发的goroutine立即入队给调度器,进而被CPU处理。
STW -> Mark -> Sweep -> STW
触发:
- 主动runtime.GC
- 被动:
- 定时, sysmon守护线程,2分钟一次。
- GOGC参数,堆增长比例到了就GC
影响
- CPU
- 停顿敏感
优化
- 减少goroutine数量,让CPU
- 控制内存分配,sync.Pool
- GOGC调参
内存泄露
- slice切片引用
- goroutine阻塞,内存泄露
之后版本更新?
- 1.9允许禁用GC, GOGC = off
- 1.10 允许回收未使用的goroutine栈
- 1.12 自动GC。在高负载时降低 GC 频率,在低负载时提高回收效率。
- 减少垃圾回收减少碎片
gorountine如何调度
goroutine作为用户态实现的协程。协程拥有自己的寄存器上下文和栈。协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈。
通过GMP模型实现并发的调度。
M代表线程,负责真正执行的对象,只有M才能得到cpu资源。
P,类似处理器,维护队列,存储未执行的goroutine。默认是和cpu多核数量对应
额外还有总的M队列,goroutine队列,在P本地队列满了后会用到。
M不断的找未绑定M的P, 然后执行goroutine,系统调用,就会M阻塞。goroutine调用就会切换下一个goroutine。
P没goroutine了,也会窃取来周转,保证M充分利用。
P没M了,创建新的M。
全局资源池: 空闲M, 空闲G, 空闲P.
Goroutine创建 -> 排队 -> 得到P -> 绑定M -> 阻塞超时/调度让出 -> 排队。
Json
- 不导出的 struct 字段无法被 encode。以小写字母开头的字段成员是无法被外部直接访问的,所以 struct 在进行 json、xml、gob 等格式的 encode 操作时,这些私有字段会被忽略,导出时得到零值
- 在 encode/decode JSON 数据时,Go 默认会将数值当做 float64 处理
unmarlshal要传map指针.
    var data = []byte(`{"status": 200}`)
    var result map[string]interface{}

    if err := json.Unmarshal(data, &result); err != nil {
        log.Fatalln(err)
    }
使用 struct 类型将你需要的数据映射为数值型。
omitempty:如果字段值为空,则不在 JSON 结果中输出。
// struct 中指定字段类型
func main() {
      var data = []byte(`{"status": 200}`)
      var result struct {
          Status uint64 `json:"status"`
          Email string `json:"email,omitempty"`
      }

      err := json.NewDecoder(bytes.NewReader(data)).Decode(&result)
      checkError(err)
    fmt.Printf("Result: %+v", result)
}
Go 语言的 reflect 包可以用来解析结构体标签:
- 通过
reflect.TypeOf(User{})获取结构体类型。 - 使用
t.NumField()遍历所有字段。 - 通过
field.Tag.Get("json")读取json标签,field.Tag.Get("db")读取db标签。
接口和C++的区别
C++ 定义接口的方式称为“侵入式”,而 Go 采用的是 “非侵入式”,不需要显式声明,只需要实现接口定义的函数,编译器自动会识别。
C++ 和 Go 在定义接口方式上的不同,也导致了底层实现上的不同。C++ 通过虚函数表来实现基类调用派生类的函数;而 Go 通过 itab 中的 fun 字段来实现接口变量调用实体类型的函数。C++ 中的虚函数表是在编译期生成的;而 Go 的 itab 中的 fun 字段是在运行期间动态生成的。原因在于,Go 中实体类型可能会无意中实现 N 多接口,很多接口并不是本来需要的,所以不能为类型实现的所有接口都生成一个 itab, 这也是“非侵入式”带来的影响;这在 C++ 中是不存在的,因为派生需要显示声明它继承自哪个基类。
unsafe
- Go 的指针不能进行数学运算
- Go 的指针不能进行数学运算
- 不同类型的指针不能使用 == 或 != 比较
版本更新
在 Go 1.22 中,for 循环中的迭代变量会被重新分配,每次循环迭代中都会创建一个新的变量。这种改动确保了闭包捕获的是每次迭代中独立的变量副本。
todo
go内存分配
Go语言的内存分配算法主要依赖于tcmalloc的思想,并针对自身需求进行了优化
tcmalloc(Thread-Caching Malloc)是 Google 开发的一种高效的内存分配器,其核心思想是通过减少线程间的锁争用和优化内存分配的碎片管理,来提升多线程环境下的内存分配性能。以下是其关键设计思想和机制:
- 线程本地缓存
tcmalloc 的核心特点是为每个线程维护一个本地缓存(Thread Local Cache, TCache),用于管理小对象的分配和释放。
- 避免全局锁竞争:线程在分配和释放内存时,优先从本地缓存中获取或释放,减少了访问全局堆的频率,降低了线程间的锁争用。
- 快速分配和释放:本地缓存通过简单的数据结构(如链表或数组)管理内存块,操作非常高效。
- 按大小分类的内存管理
tcmalloc 将内存块分为多个大小类别(Size Classes),并针对每个类别单独管理。
- 小对象:小于某个阈值的对象(通常为32KB以下)分配到线程本地缓存,并按固定大小的块管理。
- 大对象:大于阈值的对象直接从全局堆中分配,通常使用分页或直接映射(mmap)。
- 对齐优化:内存块大小通常是固定的对齐单位(如8字节)的倍数,减少内存碎片并提高访问效率。
- 页级管理
tcmalloc 将内存划分为页(Page),每页大小通常为 4KB 或 8KB,作为内存分配的基本单位。
- Span:多个连续的页组成一个
Span,用于管理同一大小类别的内存块。 - Span 分配与回收:当线程本地缓存需要新内存时,从全局堆中获取一个
Span;释放内存时,空闲的Span会被合并并归还到全局堆中。
- 内存回收与共享
tcmalloc 实现了高效的内存回收机制,以平衡线程本地缓存与全局堆之间的内存使用。
- 缓存溢出:当线程本地缓存中的内存超出一定阈值时,部分空闲块会被归还到全局堆。
- 全局共享:当某个线程需要分配内存且本地缓存不足时,可以从全局堆获取所需的
Span。
- 内存碎片优化
tcmalloc 的设计尽量减少内存碎片,通过以下策略实现:
- 固定大小类别:通过分类管理,减少小对象分配带来的碎片。
- 内存合并:回收空闲
Span时,尝试合并相邻的页。 - 延迟释放:小对象的内存释放延迟归还到全局堆,提高内存重用率。
- 线程安全与并发优化
tcmalloc 使用细粒度锁或无锁算法(如原子操作)来管理全局堆,保证线程安全的同时尽量减少锁的开销。
总结
tcmalloc 的主要思想是“线程本地缓存 + 按大小分类管理 + 高效的内存回收”,通过分层的内存分配与回收机制,提升了多线程环境下的性能,同时减少了内存碎片。
Go 实现面向对象编程
封装
面向对象中的 “封装” 指的是可以隐藏对象的内部属性和实现细节,仅对外提供公开接口调用,这样子用户就不需要关注你内部是怎么实现的。 在 Go 语言中的属性访问权限,通过首字母大小写来控制:
- 首字母大写,代表是公共的、可被外部访问的。
- 首字母小写,代表是私有的,不可以被外部访问。
继承
在 Go 语言中,是没有类似 extends 关键字的这种继承的方式,在语言设计上采取的是组合的方式:匿名字段
多态
面向对象中的 “多态” 指的同一个行为具有多种不同表现形式或形态的能力,具体是指一个类实例(对象)的相同方法在不同情形有不同表现形式。 多态也使得不同内部结构的对象可以共享相同的外部接口,也就是都是一套外部模板,内部实际是什么,只要符合规格就可以。 在 Go 语言中,多态是通过接口来实现的
单测
每个测试函数必须导入testing包,测试函数的基本格式(签名)如下:
func TestName(t *testing.T){
    // ...
}
文件xxx_test.go
runtime
gopark函数是当前gorountine挂起。
runtime.GC 触发 GC,此调用阻塞式地等待当前 GC 运行完毕。
Go scheduler 可以说是 Go 运行时的一个最重要的部分了。Runtime 维护所有的 goroutines,并通过 scheduler 来进行调度。Goroutines 和 threads 是独立的,但是 goroutines 要依赖 threads 才能执行。
Go 程序执行的高效和 scheduler 的调度是分不开的。
time
    timer := time.NewTimer(3 * time.Second) // 创建一个 3 秒的定时器
    <-timer.C // 等待定时器触发(阻塞)
    fmt.Println("3 秒后时间:", time.Now().Format("15:04:05"))

和 timer.After 区别就是它支持取消。


定时器重复执行

    ticker := time.NewTicker(1 * time.Second)
    defer ticker.Stop() // 避免资源泄露