架构演进过程
Redis 实现高可用主要有三种方式:主从复制、哨兵模式,以及 Redis 集群。
主从 -> 哨兵sentinel -> cluster
主从复制:允许一个 Redis 服务器(主节点)将数据复制到一个或多个 Redis 服务器(从节点)。这种方式可以实现读写分离,适合读多写少的场景。
哨兵模式:用于监控主节点和从节点的状态,实现自动故障转移。如果主节点发生故障,哨兵可以自动将一个从节点升级为新的主节点。
集群模式:Redis 集群通过分片的方式存储数据,每个节点存储数据的一部分,用户请求可以并行处理。集群模式支持自动分区、故障转移,并且可以在不停机的情况下进行节点增加或删除。
使用 Redis 主从服务的时候,会有一个问题,就是当 Redis 的主从服务器出现故障宕机时,需要手动进行恢复,为了解决这个问题,Redis 增加了哨兵模式(因为哨兵模式做到了可以监控主从服务器,并且提供自动容灾恢复的功能)。
Redis 主从架构 一主多从
单机的 redis,能够承载的 QPS 大概就在上万到几万不等。对于缓存来说,一般都是用来支撑读高并发的。因此架构做成主从(master-slave)架构,一主多从,主负责写,并且将数据复制到其它的 slave 节点,从节点负责读。所有的读请求全部走从节点。这样也可以很轻松实现水平扩容,支撑读高并发。

redis replication -> 主从架构 -> 读写分离 -> 水平扩容支撑读高并发。
如果所有的slave节点数据的复制和同步都由master节点来处理,会照成master节点压力太大,使用主从从结构来解决。即一个从复制另一个从
Redis主从复制/多机房复制过程
通过积压队列
- 全量同步: rdb dump,比如第一次用
- 部分同步: AOF, 根据offset传递积压缓存中的部分数据。
Redis Sentinel哨兵 一主多从+故障转移
一主多从的master挂了后没法自动选举master。当其发现某个节点不可达时,如果是master节点就会与其余的Sentinel节点协商。当大多数的Sentinel节点都认为master不可达时,就会选出一个Sentinel节点对master执行故障转移,并通知Redis的调用方相关的变更。
sentinel模式是建立在主从模式的基础上,如果只有一个Redis节点,sentinel就没有任何意义。sentinel是单独一个集群。
Redis-Sentinel是Redis官方推荐的高可用性(HA)解决方案,本身也是分布式的架构,包含了「多个」Sentinel节点和「多个」Redis节点。而每个Sentinel节点会对Redis节点和其余的Sentinel节点进行监控。
当主节点被确认下线后,Sentinel 之间会通过类似 Raft 的选举算法进行协商,选出一个领导者 Sentinel 来负责执行故障转移。
无法保证消息完全不丢失。
它的主要功能有以下几点
- 不时地监控redis是否按照预期良好地运行;
- 如果发现某个redis节点运行出现状况,能够通知另外一个进程(例如它的客户端);
- 能够进行自动切换。当一个master节点不可用时,能够选举出master的多个slave(如果有超过一个slave的话)中的一个来作为新的master,其它的slave节点会将它所追随的master的地址改为被提升为master的slave的新地址。
RedisCluster 分片 多主 去中心化
哨兵模式归根节点还是主从模式,在主从模式下我们可以通过增加 salve 节点来扩展读并发能力,但是没办法扩展写能力和存储能力,存储能力只能是 master 节点能够承载的上限。所以为了扩展写能力和存储能力,我们就需要引入集群模式。
是一个去中心化架构,内置了16384个哈希槽。去掉了sentinel这种有中心化的。
可以理解为n个主从架构组合在一起对外服务。Redis Cluster要求至少需要3个master才能组成一个集群,同时每个master至少需要有一个slave节点。
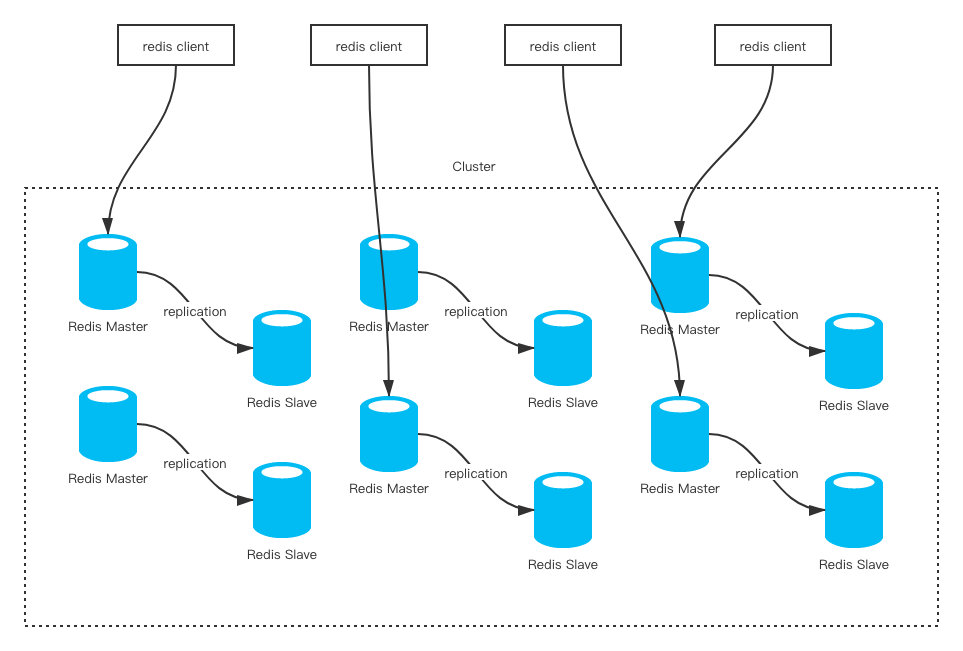
主从架构中,可以通过增加slave节点的方式来扩展读请求的并发量,当master发生了宕机,就会将对应的slave节点提拔为master,来重新对外提供服务。
key到某个server的过程是采用类一致性hash方式,即hash slot。它是在客户端sdk上设置的。
Redis把请求转发的逻辑放在了Smart Client中,要想使用Redis Cluster,必须升级Client SDK,这个SDK中内置了请求转发的逻辑,所以业务开发人员同样不需要自己编写转发规则,Redis Cluster采用16384个槽位进行路由规则的转发。
redis cluster 的 hash slot 算法
- redis cluster有固定的16384个hash slot,对每个key计算CRC16值,然后对16384取模,可以获取key对应的hash slot
- redis cluster中每个master都会持有部分slot,比如有3个master,那么可能每个master持有5000多个hash slot
- hash slot让node的增加和移除很简单,增加一个master,就将其他master的hash slot移动部分过去,减少一个master,就将它的hash slot移动到其他master上去
- 移动hash slot的成本是非常低的
- 客户端的api,可以对指定的数据,让他们走同一个hash slot,通过hash tag来实现
redis cluster 高可用保证,客观宕机则故障转移
简单来说,针对A节点,某一个节点认为A宕机了,那么此时是主观宕机。而如果集群内超过半数的节点认为A挂了, 那么此时A就会被标记为客观宕机。
一旦节点A被标记为了客观宕机,集群就会开始执行故障转移。其余正常运行的master节点会进行投票选举,从A节点的slave节点中选举出一个,将其切换成新的master对外提供服务。当某个slave获得了超过半数的master节点投票,就成功当选。
当选成功之后,新的master会执来让自己停止复制A节点,使自己成为master。然后将A节点所负责处理的slot,全部转移给自己,然后就会向集群发PONG消息来广播自己的最新状态。
按照一致性哈希的思想,如果某个节点挂了,那么就会沿着那个圆环,按照顺时针的顺序找到遇到的第一个Redis实例。
而对于Redis Cluster,某个key它其实并不关心它最终要去到哪个节点,他只关心他最终落到哪个slot上,无论你节点怎么去迁移,最终还是只需要找到对应的slot,然后再找到slot关联的节点,最终就能够找到最终的Redis实例了。
那这个PONG消息又是什么东西呢? gossip, redis cluster 节点间采用gossip协议进行通信
不同Node直接Ping-Pong, Gossip协议
gossip 广泛运用于信息扩散、故障探测等等
gossip可以在O(logN) 轮就可以将信息传播到所有的节点,为什么是O(logN)呢?因为每次ping,当前节点会带上自己的信息外加整个Cluster的1/10数量的节点信息,一起发送出去。你可以简单的把这个模型抽象为:
你转发了一个特别有意思的文章到朋友圈,然后你的朋友们都觉得还不错,于是就一传十、十传百这样的散播出去了,这就是朋友圈的裂变传播。
Redis集群化方案对比
主从和sentinel和cluster架构关系
主从是降低读压力,从节点提供读。
sentinel是HA 高可用架构,master挂了,sentinel节点就从slave里选举新master。
cluster重在大数据量,进行分片。可以说是sentinel和主从模式的结合体,通过cluster可以实现主从和master重选功能。
cluster架构延伸
gossip协议有网络风暴问题,节点数过多比如超过1000时就有性能问题,因此可能需要一种新的架构。
设想
可以不用gossip, 使用sentinel来故障转移。
配置集中化。
集群化方案
业界主流的Redis集群化方案主要包括以下几个:
客户端分片。缺点是业务开发人员使用Redis的成本较高,需要编写路由规则的代码来使用多个节点,而且如果事先对业务的数据量评估不准确,后期的扩容和迁移成本非常高
代理器分片
Codis。加个代理层。
Codis的Proxy就是负责请求转发的组件,它内部维护了请求转发的具体规则,Codis把整个集群划分为1024个槽位,在处理读写请求时,采用
crc32Hash算法计算key的Hash值,然后再根据Hash值对1024个槽位取模,最终找到具体的Redis节点。Twemproxy。加个代理层,功能比较单一,只实现了请求路由转发,没有像Codis那么全面有在线扩容的功能,它解决的重点就是把客户端分片的逻辑统一放到了Proxy层而已,其他功能没有做任何处理。
Redis Cluster
它们还可以用是否中心化来划分,其中客户端分片、Redis Cluster属于无中心化的集群方案,Codis、Tweproxy属于中心化的集群方案。
是否中心化是指客户端访问多个Redis节点时,是直接访问还是通过一个中间层Proxy来进行操作,直接访问的就属于无中心化的方案,通过中间层Proxy访问的就属于中心化。
基于代理服务器分片

简介
客户端发送请求到一个代理组件,代理解析客户端的数据,并将请求转发至正确的节点,最后将结果回复给客户端
特征
- 透明接入,业务程序不用关心后端Redis实例,切换成本低
- Proxy 的逻辑和存储的逻辑是隔离的
- 代理层多了一次转发,性能有所损耗
业界开源方案
- Twitter开源的Twemproxy
- 豌豆荚开源的Codis
Redis Cluster容错failover
- Redis Cluster 采用 主从架构,只有主节点提供服务,从节点进行热备份。
- Failover(主从切换) 是核心的容错机制:当主节点失效时,从节点会选举一个新的主节点。
- Failover 机制包括 自动 Failover 和 手动 Failover(Manual Failover)。
自动恢复
失效检测 -> 整个主节点选举的过程可分为申请、授权、升级、同步四个阶段
- 主节点失效检测
- 集群节点会定期 PING-PONG 交互,检测彼此状态:
- 超过
node timeout未响应,则标记为 PFAIL(可能失败)。 - 当大多数主节点(n/2+1)都认为该节点失效,则标记为 FAIL,并广播给整个集群。
- 超过
- 集群节点会定期 PING-PONG 交互,检测彼此状态:
- 从节点选举新的主节点
- 从节点会判断是否符合选举资格:
- 必须是失效主节点的从节点。
- 该主节点管理的哈希槽不为空。
- 复制连接断线时间未超限。
- 偏差小的从节点优先申请选举,向其他主节点发送授权请求。
- 从节点会判断是否符合选举资格:
- 主节点授权
- 其他主节点会检查:
- 申请者是故障主节点的从节点。
currentEpoch较新,并且configEpoch合理。- 申请者自身状态正常(无 FAIL/PFAIL)。
- 如果通过,主节点向申请者发送 CLUSTERMSG_TYPE_FAILOVER_AUTH_ACK 授权。
- 其他主节点会检查:
- 新主节点升级
- 获得多数授权后,从节点:
- 接管原主节点的哈希槽。
- 广播
PONG消息,宣告自己成为 新的主节点。 - 其他从节点更新配置,并同步新主节点数据。
- 获得多数授权后,从节点:
- 原主节点恢复
- 如果原主节点恢复:
- 它的
configEpoch低于新的主节点,会自动变为其 从节点。 - 如果它恢复 早于 Failover 完成,则不会发生主从切换。
- 它的
- 如果原主节点恢复:
手动 Failover(Manual Failover)
- 运维功能,允许手动将从节点提升为主节点,即使主节点仍存活。
- 主要区别:
- 触发方式:手动执行
CLUSTER FAILOVER命令,仅作用于从节点。 - 申请条件:
- 无需主节点失效。
- 固定 5 秒超时时间,仅命令目标从节点会发起申请。
- 触发方式:手动执行
- 手动 Failover 方式:
- 普通模式(默认):等待数据完全同步后进行切换,期间主节点暂停写操作。
- Force 模式:不等待数据同步,直接强制切换。