分页查询效率
B+树
Btree父节点会记录多个子节点的Range。查询o(logn)
对于有条件>=查询后就到了叶子节点,那此时在limit 10000, 10, 就需要拿出来10010条再截断,性能退化。
跳表
每个节点记录个span,记录下一层有多少个节点。查询o(logn)
深分页问题
链接: https://database.51cto.com/art/202109/683765.htm
update_time建了索引后,
执行以下语句
select id,name,balance from account where update_time> '2020-09-19' limit 100000,10;
这个SQL的执行流程:
通过普通二级索引树idx_update_time,过滤update_time条件,找到满足条件的记录ID。
通过ID,回到主键索引树,找到满足记录的行,然后取出展示的列(回表)
扫描满足条件的100010行,然后扔掉前100000行,返回。
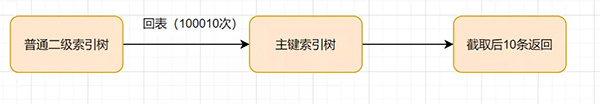
SQL变慢原因有两个:
- limit语句会先扫描offset+n行,然后再丢弃掉前offset行,返回后n行数据。也就是说limit 100000,10,就会扫描100010行,而limit 0,10,只扫描10行。
- limit 100000,10 扫描更多的行数,也意味着回表更多的次数。
通过子查询优化
因为以上的SQL,回表了100010次,实际上,我们只需要10条数据,也就是我们只需要10次回表其实就够了。因此,我们可以通过减少回表次数来优化。
select id,name,balance FROM account where id >= (select a.id from account a where a.update_time >= '2020-09-19' limit 100000, 1) LIMIT 10;
标签记录法
limit 深分页问题的本质原因就是:偏移量(offset)越大,mysql就会扫描越多的行,然后再抛弃掉。这样就导致查询性能的下降。
其实我们可以采用标签记录法,就是标记一下上次查询到哪一条了,下次再来查的时候,从该条开始往下扫描。就好像看书一样,上次看到哪里了,你就折叠一下或者夹个书签,下次来看的时候,直接就翻到啦。
假设上一次记录到100000,则SQL可以修改为:
select id,name,balance FROM account where id > 100000 order by id limit 10;
这样的话,后面无论翻多少页,性能都会不错的,因为命中了id索引。但是这种方式有局限性:需要一种类似连续自增的字段。