图数据库设计
以ByteGraph为例, 参考链接
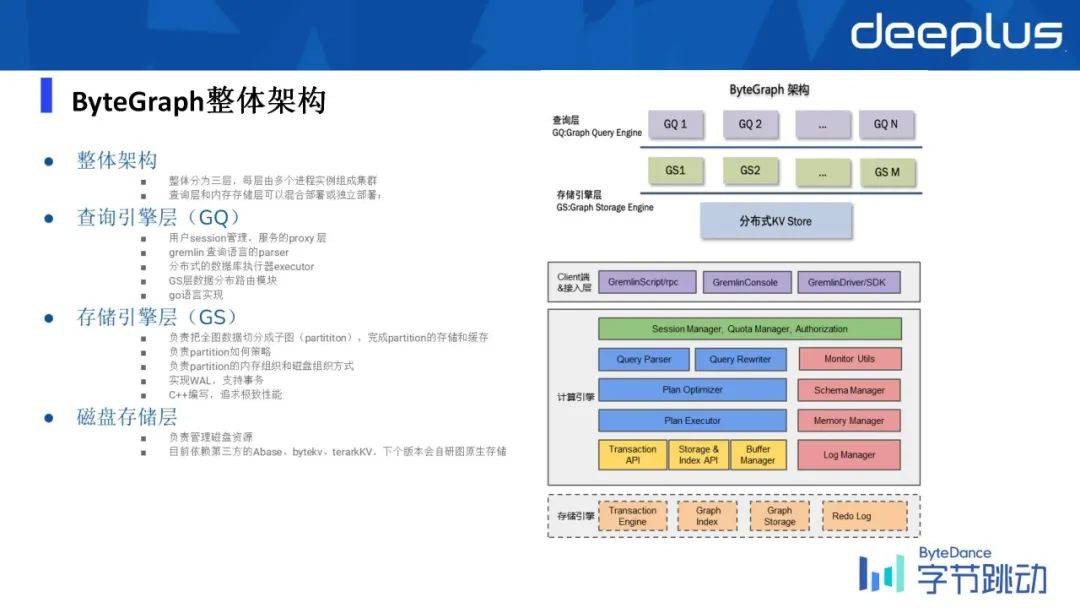
支持能力
百万级QPS, 亿级粉丝

底层存储设计
底层基于分布式KV

简单讲一下如何机遇KV系统能够构建一个图结构?

用一个类似于B树的结构来建模Graph,对某一个点来说,一个点同一个边type的所有的终点是一个存储单元,也就是说我们把一个起点ID、起点type和边type,基于它去group by,具有相同值的所有边集合,我们会认为它是逻辑上属于一个分区的。
就是个B+Tree, 插入删除查找都是o(logn),会动态调整树高度,进行分裂合并等。
同时父节点会记录底层range, 因此limit 10000, 10等这种也是o(logn),类似跳表的span。
如果这个分区依然涉及到很多点怎么办呢?我们会把它作为一个二级的拆分,所以因此会涉及到 b树的多层级。

第一层的page就叫Meta page,它其实只是去简单记录了一个映射,这1000万个邻居当中,我们基于每2000为一片,每一片我们把它称作为一个Edge page ,每一个Edge page又存储了2000个Edge,所以用这样一个多级拆分的这样的方式去降低了读写放大的问题,同时起到了一个非常平衡的设计。
总结下来就是单起点和某一种固定的边类型组成了一个B树,然后B树的每一个节点是一个KV队,然后这里涉及到完整性上的话,我们会限制每一个B树的写者只能是唯一的,以防止并发的写入导致 B树逻辑上的破坏。
刚才说到写放大的问题,我们具体在当前 B树的建模上,依然其实会存在写放大的问题。
热点读写怎么办
