一致性hash
一致性hash
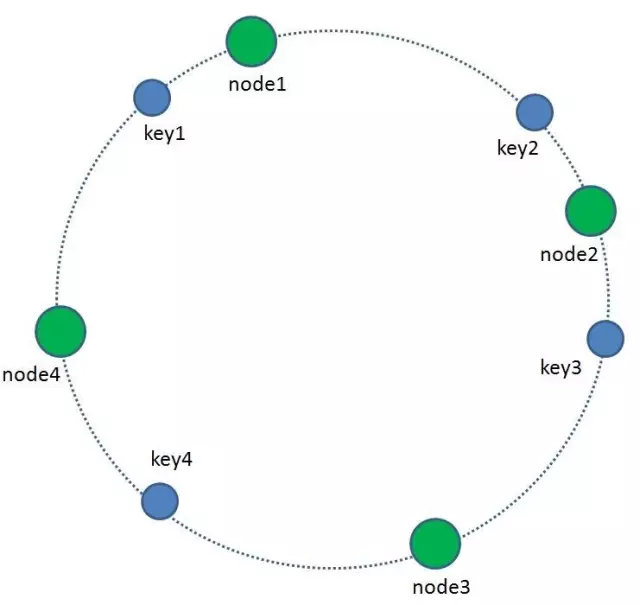
- 首先,我们将hash算法的值域映射成一个具有232 次方个桶的空间中,即0~(232)-1的数字空间。现在我们可以将这些数字头尾相连,组合成一个闭合的环形。
- 每一个缓存key都可以通过Hash算法转化为一个32位的二进制数,也就对应着环形空间的某一个缓存区。我们把所有的缓存key映射到环形空间的不同位置。
- 我们的每一个缓存节点也遵循同样的Hash算法,比如利用IP或者主机名做Hash,映射到环形空间当中,如下图
虚拟节点解决数据倾斜
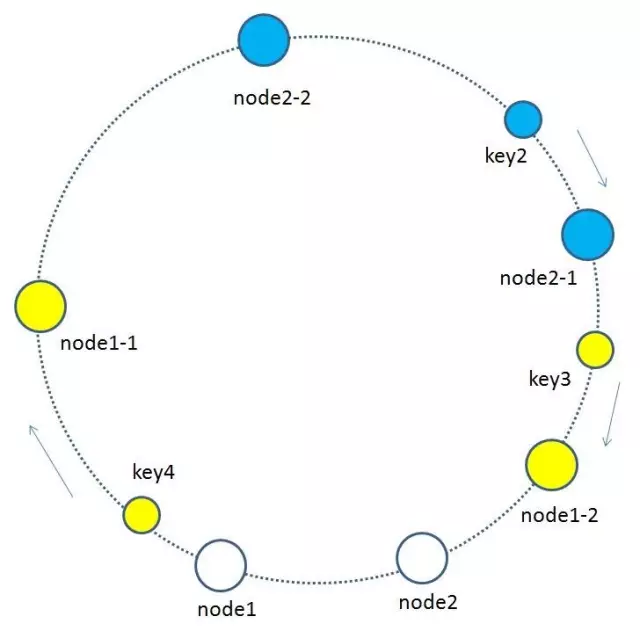
当节点太少时,容易出现数据倾斜,有的节点数据特别多。
为了优化这种节点太少而产生的不均衡情况。一致性哈希算法引入了虚拟节点的概念。 所谓虚拟节点,就是基于原来的物理节点映射出N个子节点,最后把所有的子节点映射到环形空间上。注意是随机映射。
一致性hash实现
数据结构的选择
根据算法原理,我们的算法有几个要求:
- 要能根据hash值排序存储
- 排序存储要被快速查找 (List不行)
- 排序查找还要能方便变更 (Array不行)
另外,由于二叉树可能极度不平衡。所以采用红黑树是最稳妥的实现方法。Java中直接使用TreeMap即可。
红黑树是o(logn),对于o(1)的算法,可以使用map缓存下,但增加了存储。
简单版本可以使用数组存储,变更复杂度o(n),但我们实际上只需要存储node列表即可,node上提供缓存set/get能力。
那我们每次找Node就是数组上二分查找。
python实现 数组维护+二分查找
下面的addserver和deleteserver可以把数据放到下一个server上。
#/bin/python
# -*- coding: utf-8 -*-
import bisect
import hashlib

def get_hash(raw_str):
    """将字符串映射到2^32的数字中"""
    md5_str = hashlib.md5(raw_str).hexdigest()
    return long(md5_str, 16)


class CacheNode(object):
    """缓存节点类,负责记录缓存服务器信息,以及发送缓存服务器方法"""
    def __init__(self, ip):
        self.ip = ip

    def send(self, request):
        """发送到对应的cache
        Args:
            request:需要转发的request信息
        """
        # 假装有内容的亚子
        pass


class HashSeverMgr(object):
    """server管理类,给定ip,返回对应的server"""
    def __init__(self):
        self.cache_list = []
        self.cache_node = dict()

    def add_server(self, node):
        """添加缓存节点
        Args:
            node: 缓存节点类CacheNode,记录缓存server的香港信息。
        """
        node_hash = get_hash(node.ip)
        bisect.insort(self.cache_list, node_hash)
        self.cache_node[node_hash] = node

    def del_server(self, node):
        """删除缓存节点"""
        node_hash = get_hash(node.ip)
        self.cache_list.remove(node_hash)
        del self.cache_node[node_hash]

    def get_server(self, source_key):
        """获取目标缓存节点,确定待转发的目标缓存server"""
        key_hash = get_hash(source_key)
        index = bisect.bisect_left(self.cache_list, key_hash)
        index = index % len(self.cache_list)  # 若比最大的node hash还大,分发给第一个node
        return self.cache_node[self.cache_list[index]]
参考
补充
增加节点/删除节点都需要先执行挪数据这个操作,如果没这个操作,可能会读空,但读空范围因为一致性hash的存在,导致影响有限,对于缓存应该是没关系的,如果是持久化的就需要备份,不能让读空。
hash slot
集群: 是一个提供多个Redis(分布式)节点间共享数据的程序集。 集群部署 Redis 集群的键空间被分割为 16384 hash个槽(slot), 集群的最大节点数量也是 16384 个
分片: Redis Cluster在设计中没有使用一致性哈希(Consistency Hashing),而是使用数据分片引入哈希槽(hash slot)来实现;
一个 Redis Cluster包含16384(0~16383)即2^14个哈希槽,存储在Redis Cluster中的所有键都会被映射到这些slot中,集群中的每个键都属于这16384个哈希槽中的一个,集群使用公式slot=CRC16(key)/16384来计算key属于哪个槽,其中CRC16(key)语句用于计算key的CRC16 校验和。
这种结构很容易添加或者删除节点. 比如如果我想新添加个节点D, 我需要从节点 A, B, C中得部分槽到D上. 如果我像移除节点A,需要将A中得槽移到B和C节点上,然后将没有任何槽的A节点从集群中移除即可. 由于从一个节点将哈希槽移动到另一个节点并不会停止服务, 所以无论添加删除或者改变某个节点的哈希槽的数量都不会造成集群不可用的状态.
数据迁移 数据迁移可以理解为slot(槽)和key的迁移,这个功能很重要,极大地方便了集群做线性扩展,以及实现平滑的扩容或缩容。
和一致性哈希相比
- 它并不是闭合的,key的定位规则是根据CRC-16(key)%16384的值来判断属于哪个槽区,从而判断该key属于哪个节点,而一致性哈希是根据hash(key)的值来顺时针找第一个hash(ip)的节点,从而确定key存储在哪个节点。
- 一致性哈希是创建虚拟节点来实现节点宕机后的数据转移并保证数据的安全性和集群的可用性的, 当节点不可用时,分摊给多个其他节点,因为虚节点的存在。redis cluster是采用master节点有多个slave节点机制来保证数据的完整性的,master节点写入数据,slave节点同步数据。当master节点挂机后,slave节点会通过选举机制选举出一个节点变成master节点,实现高可用。但是这里有一点需要考虑,如果master节点存在热点缓存,某一个时刻某个key的访问急剧增高,这时该mater节点可能操劳过度而死,随后从节点选举为主节点后,同样宕机,一次类推,造成缓存雪崩即热点缓存问题。
两者都是要挪数据的!