保障服务稳定的三大利器:熔断降级、服务限流和故障模拟。今天和大家谈谈限流算法的几种实现方式,本文所说的限流并非是Nginx层面的限流,而是业务代码中的逻辑限流。
为什么需要限流
按照服务的调用方,可以分为以下几种类型服务
1、与用户打交道的服务
比如web服务、对外API,这种类型的服务有以下几种可能导致机器被拖垮:
- 用户增长过快(这是好事)
- 因为某个热点事件(微博热搜)
- 竞争对象爬虫
- 恶意的刷单
这些情况都是无法预知的,不知道什么时候会有10倍甚至20倍的流量打进来,如果真碰上这种情况,扩容是根本来不及的(弹性扩容都是虚谈,一秒钟你给我扩一下试试)
2、对内的RPC服务
一个服务A的接口可能被BCDE多个服务进行调用,在B服务发生突发流量时,直接把A服务给调用挂了,导致A服务对CDE也无法提供服务。 这种情况时有发生,解决方案有两种: 1、每个调用方采用线程池进行资源隔离 2、使用限流手段对每个调用方进行限流
服务限流:
流量控制本质上是减小访问量,而服务处理能力不变;而服务降级本质上是降低了部分服务的处理能力,增强另一部分服务处理能力,而访问量不变。
以下主要介绍几种常见的服务限流算法和优缺点,以及单机限流和分布式限流。没有哪种算法是最好的或者是最差的,具体要根据实际业务场景决定使用哪种实现方式,本质都是提高功能的性价比,利用尽可能小的开发成本,产生尽可能大的收益。常见的限流算法包含:计数器法,滑动窗口算法,令牌桶算法以及漏桶算法(队列限流)。
计数器法
计数器法是限流算法里最简单也是最容易实现的一种算法。假设我们规定接口A的qps是100, 即每分钟的访问次数不能超过100。那么我们可以这么做:在一开始的时候,我们可以设置一个计数器counter,初始化为0, 过期时间为1秒,即1秒后计数器失效。每当一个请求过来的时候,counter值加1,判断当前counter的值是否大于100,如果大于100则说明请求数过多,直接拒绝请求。如果请求counter计数器不存在,则重置计数器,开始新的一秒的接口限流。注意并发情况下访问计数器需要加锁。
缺点:限制粒度太低,存在临界问题。
例如:假设有一个恶意用户,他在0:59时,瞬间发送了100个请求,并且1:00又瞬间发送了100个请求,那么其实这个用户在1秒内,瞬间发送了200个请求。用户通过在时间窗口的重置节点处突发请求,可以瞬间超过我们的速率限制。用户有可能通过算法的这个漏洞,瞬间压垮我们的应用。解决这个问题的办法就是提高限流的粒度,即滑动窗口算法。
滑动窗口(rolling window)
滑动窗口的概念源于计算机网络,它的限流思想描述如下:假设一个时间窗口就是一分钟。然后我们将时间窗口进行划分,比如我们将滑动窗口划成了6格,所以每格代表的是10秒钟。每过10秒钟,我们的时间窗口就会往右滑动一格。每一个格子都有自己独立的计数器counter,比如当一个请求在0:35秒的时候到达,那么0:30~0:39对应的counter就会加1。滑动窗口能够很好的解决计数器法所存在的临界问题,并且窗口划分粒度越细,窗口滑动就越平滑,控制效果越好。滑动窗口实现较复杂,临界问题只是某种极端案例,比如恶意攻击,是否采用这种限流方式,还需取决于具体业务的要求。
漏桶算法
为了消除”突刺现象”,可以采用漏桶算法实现限流,漏桶算法这个名字就很形象,算法内部有一个容器,类似生活用到的漏斗,当请求进来时,相当于水倒入漏斗,然后从下端小口慢慢匀速的流出。不管上面流量多大,下面流出的速度始终保持不变。
不管服务调用方多么不稳定,通过漏桶算法进行限流,每10毫秒处理一次请求。因为处理的速度是固定的,请求进来的速度是未知的,可能突然进来很多请求,没来得及处理的请求就先放在桶里,既然是个桶,肯定是有容量上限,如果桶满了,那么新进来的请求就丢弃。
在算法实现方面,可以准备一个队列,用来保存请求,另外通过一个线程池定期从队列中获取请求并执行,可以一次性获取多个并发执行。
这种算法,在使用过后也存在弊端:无法应对短时间的突发流量。这个指和令牌桶比较而言,突发指令牌桶可以每秒100qps的条件下,支持每10ms支持100qps, 而漏桶只能每10ms支持1qps,可以理解为漏桶只能平均。
令牌桶法
从某种意义上讲,令牌桶算法是对漏桶算法的一种改进,桶算法能够限制请求调用的速率,而令牌桶算法能够在限制调用的平均速率的同时还允许一定程度的突发调用。
思想描述:系统按照恒定的时间间隔(通常是1/QPS)往桶里加入Token,每个Token代表一次接口访问权限,如果桶已经满了丢弃令牌。新请求来临时,会请求从桶中拿走一个Token,如果没有Token可拿了就阻塞或者拒绝服务请求。放入Token的时间间隔取决于限制的qps,假设接口的qps是100,则按照1/qps的速率放令牌,即每10ms放入一个令牌,令牌桶算法不存在瞬间的流量高峰,它能严格控制接口在qps内访问。
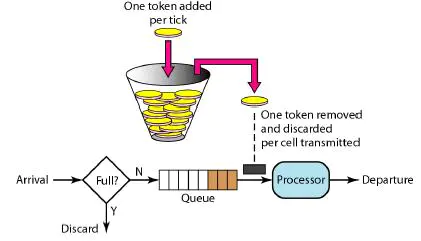
放令牌这个动作是持续不断的进行,如果桶中令牌数达到上限,就丢弃令牌,所以就存在这种情况,桶中一直有大量的可用令牌,这时进来的请求就可以直接拿到令牌执行,比如设置qps为100,那么限流器初始化完成一秒后,桶中就已经有100个令牌了,这时服务还没完全启动好,等启动完成对外提供服务时,该限流器可以抵挡瞬时的100个请求。所以,只有桶中没有令牌时,请求才会进行等待,最后相当于以一定的速率执行。
实现思路:可以准备一个队列,用来保存令牌,另外通过一个线程池定期生成令牌放到队列中,每来一个请求,就从队列中获取一个令牌,并继续执行。
单机限流器使用场景
两种算法的区别
两者主要区别在于“漏桶算法”能够强行限制数据的传输速率,而“令牌桶算法”在能够限制数据的平均传输速率外,还允许某种程度的突发传输。在“令牌桶算法”中,只要令牌桶中存在令牌,那么就允许突发地传输数据直到达到用户配置的门限,所以它适合于具有突发特性的流量。
对于很多应用场景来说,除了要求能够限制数据的平均传输速率外,还要求允许某种程度的突发传输。这时候漏桶算法可能就不合适了,令牌桶算法更为适合。令牌桶也是最适用的。
并不能说明令牌桶一定比漏洞好,她们使用场景不一样。令牌桶可以用来保护自己,主要用来对调用者频率进行限流,为的是让自己不被打垮。所以如果自己本身有处理能力的时候,如果流量突发(实际消费能力强于配置的流量限制),那么实际处理速率可以超过配置的限制。而漏桶算法,这是用来保护他人,也就是保护他所调用的系统。主要场景是,当调用的第三方系统本身没有保护机制,或者有流量限制的时候,我们的调用速度不能超过他的限制,由于我们不能更改第三方系统,所以只有在主调方控制。这个时候,即使流量突发,也必须舍弃。因为消费能力是第三方决定的。
总结起来:如果要让自己的系统不被打垮,用令牌桶。如果保证被别人的系统不被打垮,用漏桶算法。
集群式限流
相比上面的单机限流,也可以分布式集群限流。
需要额外的存储,比如redis等。
限流器实现
固定窗口
每开启一个新的窗口,在窗口时间大小内,可以通过窗口请求上限个请求。
该算法主要是会存在临界问题,如果流量都集中在两个窗口的交界处,那么突发流量会是设置上限的两倍。
- 每个窗口一个计数器
   limit    int           // 窗口请求上限
   window   time.Duration // 窗口时间大小
   counter  int           // 计数器
   lastTime time.Time     // 上一次请求的时间
   mutex    sync.Mutex    // 避免并发问题
滑动窗口
- 滑动窗口类似于固定窗口,它只是把大窗口切分成多个小窗口,每次向右移动一个小窗口,不是一下子全移过去,它可以
避免两倍的突发流量。 - 多个窗口,map记录每个小窗口计数器。
- 记录当前总窗口的访问总数。
- 限流是限制了总窗口,小窗口只是用来统计的。
// SlidingWindowLimiter 滑动窗口限流器
type SlidingWindowLimiter struct {
   limit        int           // 窗口请求上限
   window       int64         // 窗口时间大小
   smallWindow  int64         // 小窗口时间大小
   smallWindows int64         // 小窗口数量
   counters     map[int64]int // 小窗口计数器
   mutex        sync.Mutex    // 避免并发问题
}

// NewSlidingWindowLimiter 创建滑动窗口限流器
func NewSlidingWindowLimiter(limit int, window, smallWindow time.Duration) (*SlidingWindowLimiter, error) {
   // 窗口时间必须能够被小窗口时间整除
   if window%smallWindow != 0 {
      return nil, errors.New("window cannot be split by integers")
   }

   return &SlidingWindowLimiter{
      limit:        limit,
      window:       int64(window),
      smallWindow:  int64(smallWindow),
      smallWindows: int64(window / smallWindow),
      counters:     make(map[int64]int),
   }, nil
}

func (l *SlidingWindowLimiter) TryAcquire() bool {
   l.mutex.Lock()
   defer l.mutex.Unlock()

   // 获取当前小窗口值
   currentSmallWindow := time.Now().UnixNano() / l.smallWindow * l.smallWindow
   // 获取起始小窗口值
   startSmallWindow := currentSmallWindow - l.smallWindow*(l.smallWindows-1)

   // 计算当前窗口的请求总数
   var count int
   for smallWindow, counter := range l.counters {
      if smallWindow < startSmallWindow {
         delete(l.counters, smallWindow)
      } else {
         count += counter
      }
   }

   // 若到达窗口请求上限,请求失败
   if count >= l.limit {
      return false
   }
   // 若没到窗口请求上限,当前小窗口计数器+1,请求成功
   l.counters[currentSmallWindow]++
   return true
}
golang实现令牌桶
初始化qps上线limit, 间隔时间internal(单位ms)
- 使用int32当做桶的数量,token,操作使用atomic.LoadInt32, AddInt32进行操作,防止并发问题。性能足够好: 性能参考
- 使用time.Ticker每隔internal ms,原子操作token+=1。实际上是个定时任务。
- 判断能否限流规则, token>0则不限流,原子判断token是否大于0
以上实现不对,因为atomic不支持先比较再减一,还是需要用mutex来保护变量访问。
golang实现令牌桶 + 阻塞FIFO
- 用channel是不好实现FIFO的, 尤其是qps每次取的1个而是多个时,用channel取出来就没法还回去了。只能获取qps时不停轮训看满没满足。
- 另一种更合理的方式是定时任务,每次获取qps不够时就按时间扣减成负数。然后定时器来唤醒。这样后续获取qps都在之前基础上继续扣减、算一个时间来唤醒当前goroutine。
一个goroutine定时增加qps, 扣减时,如果是负数则根据时间计算来sleep等待下。
- 对应的源码 link
// reserveN is a helper method for AllowN, ReserveN, and WaitN.
// maxFutureReserve specifies the maximum reservation wait duration allowed.
// reserveN returns Reservation, not *Reservation, to avoid allocation in AllowN and WaitN.
//
// @param n 要消费的token数量
// @param maxFutureReserve 愿意等待的最长时间
func (lim *Limiter) reserveN(now time.Time, n int, maxFutureReserve time.Duration) Reservation {
	lim.mu.Lock()

	// 如果没有限制
	if lim.limit == Inf {
		lim.mu.Unlock()
		return Reservation{
			ok:        true,
			lim:       lim,
			tokens:    n,
			timeToAct: now,
		}
	}

	now, last, tokens := lim.advance(now)

	// Calculate the remaining number of tokens resulting from the request.
	// 看下取完之后,桶还能剩能下多少token
	tokens -= float64(n)

	// Calculate the wait duration
	// 如果token < 0, 说明目前的token不够,需要等待一段时间
	var waitDuration time.Duration
	if tokens < 0 {
		waitDuration = lim.limit.durationFromTokens(-tokens)
	}

	// Decide result
	ok := n <= lim.burst && waitDuration <= maxFutureReserve

	// Prepare reservation
	r := Reservation{
		ok:    ok,
		lim:   lim,
		limit: lim.limit,
	}

	// timeToAct表示当桶中满足token数目等于n的时间
	if ok {
		r.tokens = n
		r.timeToAct = now.Add(waitDuration)
	}

	// Update state
	// 更新桶里面的token数目
	// 更新last时间
	// lastEvent
	if ok {
		lim.last = now
		lim.tokens = tokens
		lim.lastEvent = r.timeToAct
	} else {
		lim.last = last
	}

	lim.mu.Unlock()
	return r
}

// advance calculates and returns an updated state for lim resulting from the passage of time.
// lim is not changed.
// @param now
// @return newNow 似乎还是这个now,没变
// @return newLast 如果 last > now, 则last为now
// @return newTokens 当前桶中应有的数目
func (lim *Limiter) advance(now time.Time) (newNow time.Time, newLast time.Time, newTokens float64) {
	// last代表上一个取的时候的时间
	last := lim.last
	if now.Before(last) {
		last = now
	}

	// Avoid making delta overflow below when last is very old.
	// maxElapsed表示,将Token桶填满需要多久
	// 为什么要拆分两步做,是为了防止后面的delta溢出
	// 因为默认情况下,last为0,此时delta算出来的,会非常大
	maxElapsed := lim.limit.durationFromTokens(float64(lim.burst) - lim.tokens)

	// elapsed 表示从当前到上次一共过去了多久
	// 当然了,elapsed不能大于将桶填满的时间
	elapsed := now.Sub(last)
	if elapsed > maxElapsed {
		elapsed = maxElapsed
	}

	// Calculate the new number of tokens, due to time that passed.
	// 计算下过去这段时间,一共产生了多少token
	delta := lim.limit.tokensFromDuration(elapsed)

	// token取burst最大值,因为显然token数不能大于桶容量
	tokens := lim.tokens + delta
	if burst := float64(lim.burst); tokens > burst {
		tokens = burst
	}

	return now, last, tokens
}
golang实现漏桶
- 该算法主要的属性字段有以下三个:
- 处理请求的速率rate。该值代表多久处理一个请求。实际上就是指处理完该请求后,要等待多久才能处理下一个请求。 比如我们初始化时指定服务每100ms处理一个请求,也就是每处理1个请求,需要等待100ms才能处理下一个请求。
- 桶的最大容量capacity。该值代表我们最多允许多少个请求排队,超过该值,就直接返回,不用等待了。这个在生活中有很多类似场景:有一次我们去公园排队坐游船,排了很长的队伍。管理员过来告诉我们,只有前20个人能排上号,20号后面的就可以不用排了。
- 桶中最后一个排队请求被处理的时间last, 该值有两个作用:
- 第一个作用是当有新请求进来的时候,就可以计算出新请求需要被处理的时间:last+rate
- 第二个作用是根据last、当前时间t以及速率rate计算当前还有多少个请求等待被处理:
type LeakyBucket struct {
	rate int64 //处理请求的速率
	capacity int64 //桶的最大容量
  last time.Time //桶中最后一个排队请求被处理的时间
  mu sync.Mutex
}

func (t *LeakyBucket) Limit(ctx context.Context) (time.Duration, error) {
	//这里进行加锁,保证每个请求按顺序依次处理
  t.mu.Lock()
	defer t.mu.Unlock()

  now := time.Now().UnixNano() //当前时间的纳秒数
	if now < t.last {
		// 说明已经有请求在排队了,那么新请求进来排队后被处理的时间就是rate后
		t.last += t.rate
	} else {
		// 说明为桶为空,也许是初始状态,也许是所有的请求都被处理完了.

    var offset int64 //代表等待处理该请求的时间需要等待多久
		delta := now - state.Last // 代表当前时间距离上次处理请求的时间过了多久
		if delta < t.rate {
      //说明还没有到下次处理请求的时间,则需要等待offset后才能到
			offset = t.rate - delta
		}
    //如果delta > t.rate 说明当前时间距离上次处理请求的时间已经超过了rate,offset为0,新的请求就应该被马上处理
		t.last = now + offset //更新该请求应该被处理的时间
	}

	wait := t.last - now //计算桶是否已经满了
	if wait/t.rate > t.capacity {
    //桶满了,返回error,调用者根据需要是直接丢弃还是等待wait长的时间。一般是直接丢弃。

    t.last = now - offset //因为这里要丢弃该请求,所有要保持新请求排队前的状态
		return time.Duration(wait), ErrLimitExhausted
	}

  //排队成功,返回要等待的时间给调用者,让调用者sleep进行阻塞就能实现按rate的速率处理请求了
	return time.Duration(wait), nil
}
分布式限流器
要求非单机,因此可以使用redis实现,
方案1. redis kv, v是当前访问数,可以通过lua脚本保证原子性。这是限制访问量的做法。不是限流限制qps。使用时+1,用完-1。
方案2. 如果是限制qps,可以利用redis做令牌桶,一个线程每秒添加令牌,每次使用都取1个,用完也不会归还,用lua脚本保证原子性。
方案3. 如果不想用单独线程每秒添加令牌,可以记录上次的访问时间,然后访问时和上次访问时间diff,看应该增加多少令牌。
推荐方案
分布式环境下,可以考虑用 Redis+Lua 脚本实现令牌桶。大于0则扣除。
如果请求量太大了,Redis 也撑不住怎么办?我觉得可以类似于分布式 ID 的处理方式,Redis 前面在增加预处理,比如每台及其预先申请一部分令牌,只有令牌用完之后才去 Redis。如果还是太大,是否可以垂直切分?按照流量的来源,比如地理位置、IP 之类的再拆开。

小结: 令牌桶,定时分发令牌存到redis,每次机器load一堆令牌到本地。一次性取一批,大幅降低获取令牌桶的请求数量。