定时器
一般都有个延迟队列,延迟队列一定有个锁避免并发问题,然后肯定有个线程或者携程异步监听延迟队列头部时间到没到。
延迟队列实现包括:基于排序链表实现、基于小根堆实现、基于红黑树实现、基于时间轮实现等。
延迟队列方案:
方案一:优先队列+轮询。 缺点:轮询通常有个很大的缺点,就是时间间隔不好设置,间隔太长,任务无法及时处理,间隔太短,会很耗CPU。
方案二:优先队列+时间差,没到时间点就time.Sleep()下。缺点:假设当前堆顶的任务在100秒后执行,消费者线程peek()偷看到了后,开始sleep 100秒,这时候一个新的任务插了进来,该任务在10秒后应该执行,但是由于消费者线程要睡眠100秒,这个新任务无法及时处理。但这个可以通过增加任务时,给信号给异步线程,告知重新计算time.Sleep()时间。
方案三:[推荐] 时间轮实现。当任务数量非常大时,堆(PriorityQueue)维护任务的新增、删除必然会导致性能下降,性能o(nlogn)。而HashedWheelTimer使用tick管理,不受任务数量的限制, 添加任务是o(1)。
时间轮
是一个存储定时任务的环形队列,底层采用数组实现,数组中的每个元素可以存放一个定时任务列表(TimerTaskList), 是一个双向链表,为了插入删除o(1), 链表中的每一项表示的都是定时任务项(TimerTaskEntry),其中封装了真正的定时任务TimerTask。
分层时间轮实现就类似钟表一样, 是 hour <-> minute <-> second, 每当最后一秒结束时,把上一层minute的第一个slot展开放到second这层,minute到底了就拿hour这层。
然后每层都有个cursor, 新建任务会和cursor算出的(hour, minute, second)比较,如果差了hour以上就在hour那层,差了minute就在minute那层,反正只会插入某一层的一个slot上。
时间轮time wheel, 可以解决优先队列插入删除o(logn)的问题,时间轮插入删除可以o(1)
时间轮定时器最大的优点:
- 是任务的添加与移除,都是O(1)级的复杂度;
- 不会占用大量的资源;
- 只需要有一个线程去推进时间轮就可以工作了。
参考
python多层时间轮实现及分析:
总体调度代码

调度过程: 不停移动cursor,对于cursor到当前时间前的任务都可以进行调度。调度后cursor设为当前时间。然后time.sleep下,又再次移动cursor。 如果是最后一个slot,把上层slot下移。
新建任务: 新建任务会和cursor算出的(hour, minute, second)比较,如果差了hour以上就在hour那层,差了minute就在minute那层,反正只会插入某一层的一个slot上。
对于重复任务:调度后发现是重复任务,就再执行一次插入。
golang定时器实现-四叉堆
比如golang定时器实现, 参考
全局最小四叉堆
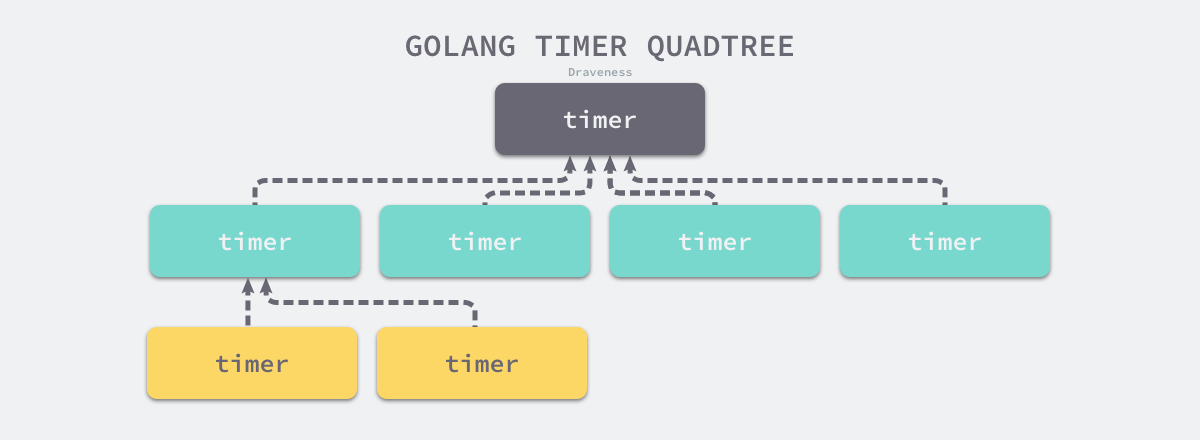
最开始 ,是全局一个最小四叉堆,运行时创建的所有计时器都会加入到四叉堆中。Goroutine 会运行时间驱动的事件,运行时会在发生以下事件时唤醒计时器:
- 四叉堆中的计时器到期;
- 四叉堆中加入了触发时间更早的新计时器;
!
分片四叉堆
然而全局四叉堆共用的互斥锁对计时器的影响非常大,计时器的各种操作都需要获取全局唯一的互斥锁,这会严重影响计时器的性能。
Go 1.10 将全局的四叉堆分割成了 64 个更小的四叉堆5。在理想情况下,四叉堆的数量应该等于处理器的数量,但是这需要实现动态的分配过程,所以经过权衡最终选择初始化 64 个四叉堆,以牺牲内存占用的代价换取性能的提升。
如果当前机器上的处理器 P 的个数超过了 64,多个处理器上的计时器就可能存储在同一个桶中。每一个计时器桶都由一个运行 runtime.timerproc:76f4fd8 函数的 Goroutine 处理。
网络轮询器
将全局计时器分片的方式,虽然能够降低锁的粒度,提高计时器的性能,但是 runtime.timerproc:76f4fd8 造成的处理器和线程之间频繁的上下文切换却成为了影响计时器性能的首要因素6。
在最新版本的实现中,计时器桶已经被移除7,所有的计时器都以最小四叉堆的形式存储在处理器 runtime.p 中。

分布式定时器
RocksDB/LevelDB
丢到自建的rocketmq broker作为缓冲层,到期后再投递到业务里,实现定时/延迟的功能
对于任务分发,最核心一点的是对执行时间的排序,用rocksdb代替mysql的好处就是rocksdb中缓存层,SST file对key进行了排序,所以对范围且排序的查询效率十分高
为什么同样是数据库RocksDB会比Mysql更加合适呢?因为RocksDB的特性是LSM树,其使用场景适用于大量写入,和消息队列的场景更加契合,所以这个也是滴滴和美团选择其作为延时消息封装的存储介质。
时间轮+磁盘存储
用分层时间轮,但持久化到磁盘上。
个人猜测:分布式集群的话可以用zk保证只有一个master。
Redis zset分片方案
主要是redis比较快,用zset做优先队列,用zset优点是容易做shard。
1000个分片,当前时间mod size后就可以分到某个分片上。
每个分片上有zset存了这个对应时间的任务列表id.
假如每个分片是1s,那这支持的就1000s以内的,假如是1000w个分片,就很多天了。
为了不遗漏,可以再用个kv存储处理的当前时间,类似滑动窗口移动这个当前时间。每次取出来和当前时间比较,如果小于等于则处理时间对应的shard的任务列表。
需要有个deamon thread去跑,为了保证每次只有1个跑。
- 可以使用分布式锁,多个实例,谁抢到谁跑
- 可以多实例,互相通信,比如用zk注册路径,然后定时探活,ping-pong,保证只有一个master.
为了解决空转空跑的问题,kafka定时器用了java delayqueue就是优先队列。
所以这里也可以用个优先队列保存不为空的shard.