递归和分治
递归(英语:Recursion),在数学和计算机科学中是指在函数的定义中使用函数自身的方法,在计算机科学中还额外指一种通过重复将问题分解为同类的子问题而解决问题的方法。
分治(英语:Divide and Conquer),字面上的解释是“分而治之”,就是把一个复杂的问题分成两个或更多的相同或相似的子问题,直到最后子问题可以简单的直接求解,原问题的解即子问题的解的合并。
递归
递归优化
比较初级的递归实现可能递归次数太多,容易超时。这时需要对递归进行优化
汉诺塔
汉诺塔:汉诺塔(又称河内塔)问题是源于印度一个古老传说的益智玩具。大梵天创造世界的时候做了三根金刚石柱子,在一根柱子上从下往上按照大小顺序摞着64片黄金圆盘。大梵天命令婆罗门把圆盘从下面开始按大小顺序重新摆放在另一根柱子上。并且规定,在小圆盘上不能放大圆盘,在三根柱子之间一次只能移动一个圆盘。
用递归解决问题,一个关键点是要有递归结束的条件
当只有一个盘子的时候,直接就是A->C,这也是递归结束的条件
当有两个盘子的时候,我们知道需要这样移动,A->B, A->C, B->C。
当有三个或三个以上的盘子的时候,我们这样来考虑把最下面的盘子当做一块,其他盘子当做一块,那么,就简化成了上一步。A柱子是源,B柱子是当做临时转换用的源,C是目的
需要注意的是,当经过上一步后,除了最下面的盘子其他的已经到了B柱子上了,这个时候,A柱子就是当做临时转换用的了,B柱子是源,C是目的。所以当n不等于1的时候,会回调两次函数,第一次参数的顺序是n,a,c,b。第二次是n,b,a,c
//cpp:
#include<iostream>
using namespace std;
void move(int n, char a, char b, char c) {
	if (n == 1) {
		printf("%c --> %c\n", a, c);
	}
	else {
		move(n - 1, a, c, b);
		printf("%c --> %c\n", a, c);
		move(n - 1, b, a, c);
	}
}
int main() {
	move(4, 'a','b','c');
	int x;
	cin >> x;
	return 0;
}
尾递归
如果一个函数中所有递归形式的调用都出现在函数的末尾,我们称这个递归函数是尾递归的。当递归调用是整个函数体中最后执行的语句且它的返回值不属于表达式的一部分时,这个递归调用就是尾递归。尾递归函数的特点是在回归过程中不用做任何操作,这个特性很重要,因为大多数现代的编译器会利用这种特点自动生成优化的代码。
线性递归:
long Rescuvie(long n) {

    return (n == 1) ? 1 : n * Rescuvie(n - 1);

}
尾递归:
long TailRescuvie(long n, long a) {

    return (n == 1) ? a : TailRescuvie(n - 1, a * n);

}


long TailRescuvie(long n) {//封装用的

    return (n == 0) ? 1 : TailRescuvie(n, 1);

}
递归转非递归
我们来看一个真实的递归例子,后序优先遍历(leetcode-145)
void dfs(TreeNode* root) {
    if (root == NULL) {
        return;
    }
    dfs(root->left);
    dfs(root->right);
    visit(root); //前中后序的代码就区别于visit(root)的位置,放在两个dfs前面就是前序,放在两个dfs之间就是中序,本质上没什么区别
}
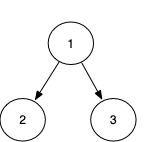
我们从代码层面上来解释上图的代码执行过程:
- 执行节点1,需要先执行左节点,挂起,节点2进入待执行栈
- 执行节点2,需要先执行左节点,挂起,节点2的左节点进入待执行栈
- 栈顶元素是个null,弹出
- 继续执行节点2,先前执行到左节点那个地方,继续,需要先执行右节点,挂起,节点2的右节点进入待执行栈
- 栈顶元素是个null,弹出
- 继续执行节点2,先前执行到右节点那个地方,继续,访问节点2,结束,弹出
- 继续执行节点1,先前执行到左节点那个地方,继续,需要先执行右节点,挂起,节点3进入待执行栈
- 执行节点3,需要先执行左节点,挂起,节点3的左节点进入待执行栈
- 栈顶元素是个null,弹出
- 执行执行节点3,先前执行到左节点那个地方,继续,需要先执行右节点,挂起,节点3的右节点进入待执行栈
- 栈顶元素是个null,弹出
- 继续执行节点3,先前执行到右节点那个地方,继续,访问节点3,结束,弹出
- 继续执行节点1,先前执行到右节点那个地方,继续,访问节点1,结束,弹出
- 栈为空,执行完毕
理解完这个递归的过程后,我们的非递归代码就呼之欲出了
- 定义一个数据类型,用来保存递归过程中的上下文,比如,各种临时变量,在递归的过程中,这些变量语言层面上帮我们解决了上下文保留,非递归版本我们需要自己保存
- 分解递归函数代码,将需要递归调用函数的部分分开,变成步骤1,步骤2,。。。例如,上面的后续优先遍历,就分成3个步骤,1是从开头到递归调用左节点之前,2是调用左节点后,调用右节点之前,3是调用右节点之后。
于是非递归版本的代码就是这样的:
struct Context {
    TreeNode* root;
    int step;
    Process(TreeNode* _root) {
        root = _root;
        step = 0;
    }
};

void artidfs(TreeNode* root) {
    vector<Context> stack;
    stack.push_back(Context(root));
    while (!stack.empty()) {
        int last = stack.size() - 1;
        if (stack[last].root == NULL) {
            //对标dfs函数中第一行,root为空,直接返回
            stack.pop_back();
        } else if (stack[last].step == 0) {
            //处于第一个阶段中
            stack[last].step++;
            stack.push_back(Context(stack[last].root->left));
        } else if (stack[last].step == 1) {
            //处于第二个阶段
            stack[last].step++;
            stack.push_back(Context(stack[last].root->right));
        } else {
            //处于第三个阶段
            visit(Context(stack[last].root));
            stack.pop_back();
        }
    }
}
这个代码基本上是通用的,大家可以尝试着改写其他递归代码,可以加深对递归的理解。
大家理解完这个代码后,再思考下为啥语言中有递归栈层数和递归中内存使用的限制。
阶段划分技巧: 开始、结束、每次递归调用func这,以上间隔划分阶段。
函数A里调用A两次,就划分3断,调用5次就划分6段
returnVal可以公共变量也可以栈的下一个位置直接更新。
index = 0


def BuildTree(data: List[int]) -> TreeNode:
    global index
    # 0
    if index >= len(data) or data[index] == 0:
        return None
    res = TreeNode(data[index])
    index += 1
    res.left = BuildTree(data)
    # 1
    index += 1
    res.right = BuildTree(data)
    # 2
    return res


class Context(object):
    res = None
    step = 0

    def __init__(self):
        step = 0


returnVal = None


def BuildTreeWithoutRecursion(data: List[int]) -> TreeNode:
    global index
    global returnVal
    stack = []
    stack.append(Context())
    while len(stack) > 0:
        if stack[-1].step == 0:
            if index >= len(data) or data[index] == 0:
                returnVal = None
                stack.pop()
            else:
                stack[-1].step += 1
                stack[-1].res = TreeNode(data[index])
                index += 1
                stack.append(Context())
        elif stack[-1].step == 1:
            stack[-1].step += 1
            stack[-1].res.left = returnVal
            index += 1
            stack.append(Context())
        elif stack[-1].step == 2:
            stack[-1].res.right = returnVal
            returnVal = stack[-1].res
            stack.pop()
    return returnVal
快速排序变非递归
仿造vlr的写法。
    def partition(data, left, right):
        if left >= right:
            return data
        p = data[left]
        while left < right:
            while left < right and data[right] > p:
                right -= 1
            if left < right:
                data[left] = data[right]
                left += 1
            while left < right and data[left] <= p:
                left += 1
            if left < right:
                data[right] = data[left]
                right -= 1
        data[left] = p
        # print(data)
        return left

    def quicksort(data, left, right):
        if left >= right:
            return data
        p = partition(data, left, right)
        quicksort(data, left, p - 1)
        quicksort(data, p + 1, right)
        return data

    def quicksortWithoutRecursion(data):
        left, right = 0, len(data) -1
        stack = list()
        stack.append((left, right))
        while len(stack) > 0:
            left, right = stack.pop()
            if left >= right:
                continue
            p = partition(data, left, right)
            # 先处理L,因此栈里后放L
            stack.append((p + 1, right))
            stack.append((left, p - 1))
        print(data)
        return data