分布式事务
2PC, 3PC性能比较差,都是刚性事务。
2PC的协议成本比较高,又有全局锁的问题,性能会比较差。 现在大家基本上不会采用这种强一致解决方案。
柔性事务: BASE理论。 对于柔性事务来常见的实现方式有TCC,和Saga
与两阶段提交相比,TCC位于业务服务层, 没有单独的准备阶段,Try操作可以灵活选择业务资源锁的粒度。TCC是通过最终一致性来解决系统性能问题的这个设计,对我们设计抉择有很大的启发。 有些时候系统的技术问题是可以通过业务建模的方式来解决的。
刚性事务在隔离性方面,主要是通过资源锁定的方式实现资源隔离的,在数据库层面自身就提供了这种隔离实现,不需要业务实现。而柔性事务则一般不用锁,而是通过资源预留(比如冻结金额)的方式实现隔离,且这种资源预留的隔离方式,是需要业务自己去实现并保证隔离性的。
柔性事务的解决方案主要分为补偿型和通知型两大类,补偿型的方案主要有 TCC 和 Saga 两种模式,通知型的方案则又分为事务消息型和最大努力通知型。补偿型事务一般是同步的,通知型事务则是异步的,所以也有同步事务和异步事务的划分。
2pc, 3pc
2pc: 投票, 事务提交 (协调者有超时,参与者网络问题会询问其他参与者)
有单点、同步阻塞比较慢,数据不一致
3pc: 预询盘、投票,事务提交 3pc主要是减少2pc的同步阻塞时间,
这两个都无法避免数据不一致的情况
两阶段提交协议(2PC:Two-Phase Commit)
两阶段提交协议的目标在于为分布式系统保证数据的一致性,许多分布式系统采用该协议提供对分布式事务的支持。顾名思义,该协议将一个分布式的事务过程拆分成两个阶段: 投票 和 事务提交 。为了让整个数据库集群能够正常的运行,该协议指定了一个 协调者 单点,用于协调整个数据库集群各节点的运行。为了简化描述,我们将数据库集群中的各个节点称为 参与者 ,三阶段提交协议中同样包含协调者和参与者这两个角色定义。
第一阶段:投票
该阶段的主要目的在于打探数据库集群中的各个参与者是否能够正常的执行事务,具体步骤如下:
- 协调者向所有的参与者发送事务执行请求,并等待参与者反馈事务执行结果;
- 事务参与者收到请求之后,执行事务但不提交,并记录事务日志;
- 参与者将自己事务执行情况反馈给协调者,同时阻塞等待协调者的后续指令。
第二阶段:事务提交
在经过第一阶段协调者的询盘之后,各个参与者会回复自己事务的执行情况,这时候存在 3 种可能性:
- 所有的参与者都回复能够正常执行事务。
- 一个或多个参与者回复事务执行失败。
- 协调者等待超时。
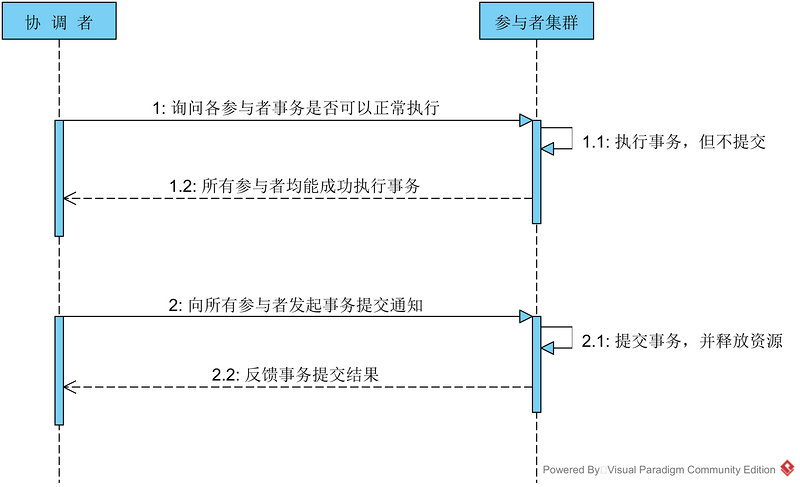
对于第 1 种情况,协调者将向所有的参与者发出提交事务的通知,具体步骤如下:
- 协调者向各个参与者发送 commit 通知,请求提交事务;
- 参与者收到事务提交通知之后执行 commit 操作,然后释放占有的资源;
- 参与者向协调者返回事务 commit 结果信息。
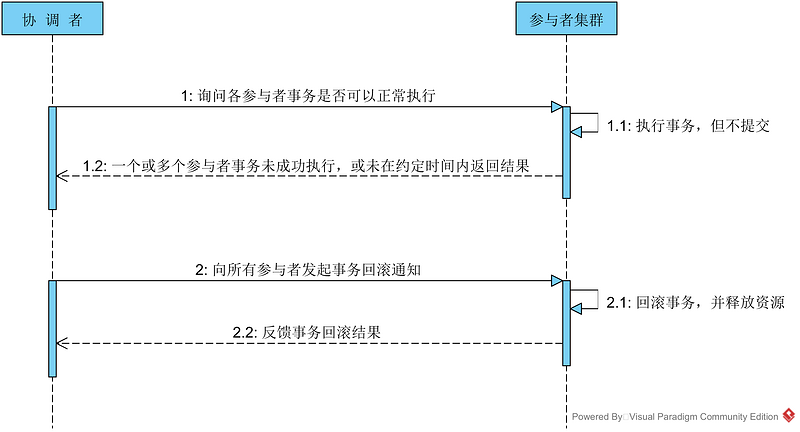
对于第 2 和第 3 种情况,协调者均认为参与者无法成功执行事务,为了整个集群数据的一致性,所以要向各个参与者发送事务回滚通知,具体步骤如下:
- 协调者向各个参与者发送事务 rollback 通知,请求回滚事务;
- 参与者收到事务回滚通知之后执行 rollback 操作,然后释放占有的资源;
- 参与者向协调者返回事务 rollback 结果信息。
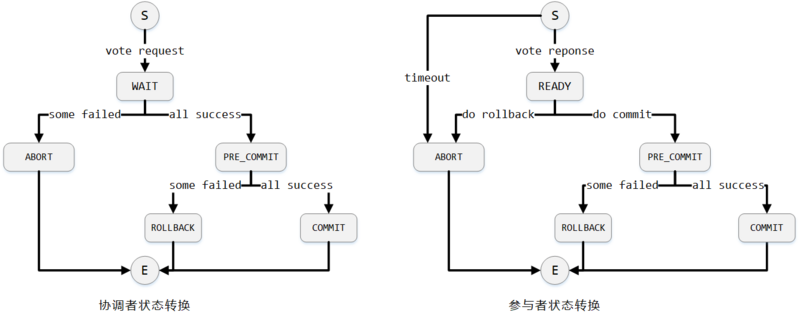
两阶段提交协议解决的是分布式数据库数据强一致性问题,实际应用中更多的是用来解决事务操作的原子性,下图描绘了协调者与参与者的状态转换。

站在协调者的角度,在发起投票之后就进入了 WAIT 状态,等待所有参与者回复各自事务执行状态,并在收到所有参与者的回复后决策下一步是发送 commit 或 rollback 信息。站在参与者的角度,当回复完协调者的投票请求之后便进入 READY 状态(能够正常执行事务),接下去就是等待协调者最终的决策通知,一旦收到通知便可依据决策执行 commit 或 rollback 操作。
两阶段提交协议原理简单、易于实现,但是缺点也是显而易见的,包含如下:
- 单点问题
协调者在整个两阶段提交过程中扮演着举足轻重的作用,一旦协调者所在服务器宕机,就会影响整个数据库集群的正常运行。比如在第二阶段中,如果协调者因为故障不能正常发送事务提交或回滚通知,那么参与者们将一直处于阻塞状态,整个数据库集群将无法提供服务。
- 同步阻塞
两阶段提交执行过程中,所有的参与者都需要听从协调者的统一调度,期间处于阻塞状态而不能从事其他操作,这样效率极其低下。
- 数据不一致性
两阶段提交协议虽然是分布式数据强一致性所设计,但仍然存在数据不一致性的可能性。比如在第二阶段中,假设协调者发出了事务 commit 通知,但是因为网络问题该通知仅被一部分参与者所收到并执行了commit 操作,其余的参与者则因为没有收到通知一直处于阻塞状态,这时候就产生了数据的不一致性。
针对上述问题可以引入 超时机制 和 互询机制 在很大程度上予以解决。
对于协调者来说如果在指定时间内没有收到所有参与者的应答,则可以自动退出 WAIT 状态,并向所有参与者发送 rollback 通知。对于参与者来说如果位于 READY 状态,但是在指定时间内没有收到协调者的第二阶段通知,则不能武断地执行 rollback 操作,因为协调者可能发送的是 commit 通知,这个时候执行 rollback 就会导致数据不一致。
此时,我们可以介入互询机制,让参与者 A 去询问其他参与者 B 的执行情况。如果 B 执行了 rollback 或 commit 操作,则 A 可以大胆的与 B 执行相同的操作;如果 B 此时还没有到达 READY 状态,则可以推断出协调者发出的肯定是 rollback 通知;如果 B 同样位于 READY 状态,则 A 可以继续询问另外的参与者。只有当所有的参与者都位于 READY 状态时,此时两阶段提交协议无法处理,将陷入长时间的阻塞状态。
三阶段提交协议(3PC:Three-Phase Commit)
针对两阶段提交存在的问题,三阶段提交协议通过引入一个 预询盘 阶段,以及超时策略来减少整个集群的阻塞时间,提升系统性能。三阶段提交的三个阶段分别为:预询盘(can_commit)、预提交(pre_commit),以及事务提交(do_commit)。
- 引入canCommit阶段减少同步阻塞。
- 引入超时减少单点故障,没有协调者消息并超时了,直接 commit
第一阶段:预询盘
该阶段协调者会去询问各个参与者是否能够正常执行事务,参与者根据自身情况回复一个预估值,相对于真正的执行事务,这个过程是轻量的,具体步骤如下:
- 协调者向各个参与者发送事务询问通知,询问是否可以执行事务操作,并等待回复;
- 各个参与者依据自身状况回复一个预估值,如果预估自己能够正常执行事务就返回确定信息,并进入预备状态,否则返回否定信息。
第二阶段:预提交
本阶段协调者会根据第一阶段的询盘结果采取相应操作,询盘结果主要有 3 种:
- 所有的参与者都返回确定信息。
- 一个或多个参与者返回否定信息。
- 协调者等待超时。
针对第 1 种情况,协调者会向所有参与者发送事务执行请求,具体步骤如下:
- 协调者向所有的事务参与者发送事务执行通知;
- 参与者收到通知后执行事务但不提交;
- 参与者将事务执行情况返回给客户端。
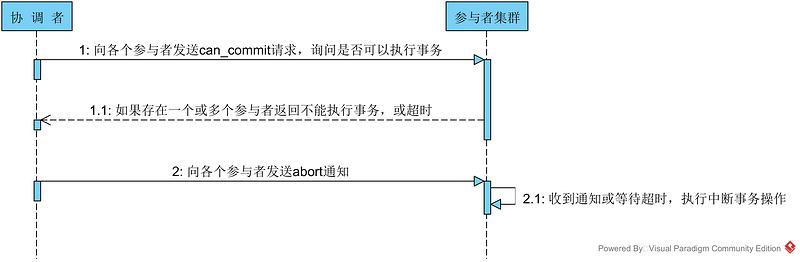
在上述步骤中,如果参与者等待超时,则会中断事务。 针对第 2 和第 3 种情况,协调者认为事务无法正常执行,于是向各个参与者发出 abort 通知,请求退出预备状态,具体步骤如下:
- 协调者向所有事务参与者发送 abort 通知;
- 参与者收到通知后中断事务。
第三阶段:事务提交
如果第二阶段事务未中断,那么本阶段协调者将会依据事务执行返回的结果来决定提交或回滚事务,分为 3 种情况:
- 所有的参与者都能正常执行事务。
- 一个或多个参与者执行事务失败。
- 协调者等待超时。
针对第 1 种情况,协调者向各个参与者发起事务提交请求,具体步骤如下:
- 协调者向所有参与者发送事务 commit 通知;
- 所有参与者在收到通知之后执行 commit 操作,并释放占有的资源;
- 参与者向协调者反馈事务提交结果。

针对第 2 和第 3 种情况,协调者认为事务无法成功执行,于是向各个参与者发送事务回滚请求,具体步骤如下:
- 协调者向所有参与者发送事务 rollback 通知;
- 所有参与者在收到通知之后执行 rollback 操作,并释放占有的资源;
- 参与者向协调者反馈事务回滚结果。

在本阶段如果因为协调者或网络问题,导致参与者迟迟不能收到来自协调者的 commit 或 rollback 请求,那么参与者将不会如两阶段提交中那样陷入阻塞,而是等待超时后继续 commit,相对于两阶段提交虽然降低了同步阻塞,但仍然无法完全避免数据的不一致。
两阶段提交协议中所存在的长时间阻塞状态发生的几率还是非常低的,所以虽然三阶段提交协议相对于两阶段提交协议对于数据强一致性更有保障,但是因为效率问题,两阶段提交协议在实际系统中反而更加受宠。
XA协议
XA是资源层面的分布式事务,强一致性,在两阶段提交的整个过程中,一直会持有资源的锁。基于数据库锁实现。 TCC是业务层面的分布式事务,最终一致性,不会一直持有资源的锁。(第一阶段的事务就已经提交了,第二阶段执行确认操作或取消第一阶段的操作) 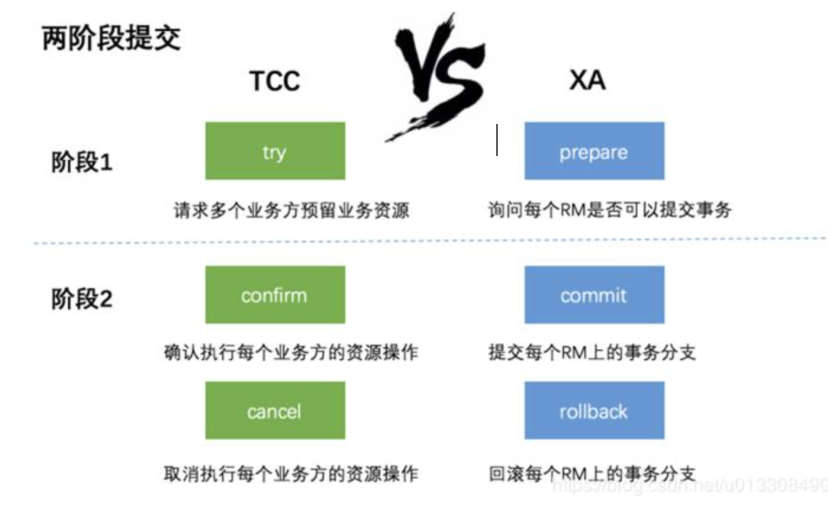
TCC
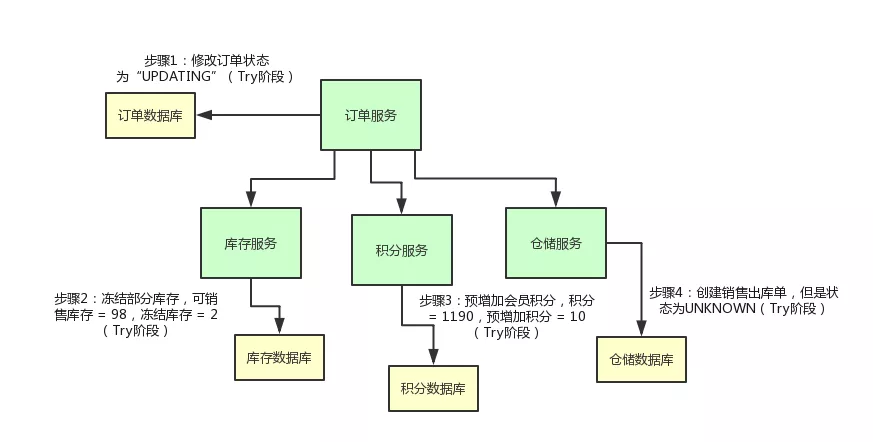
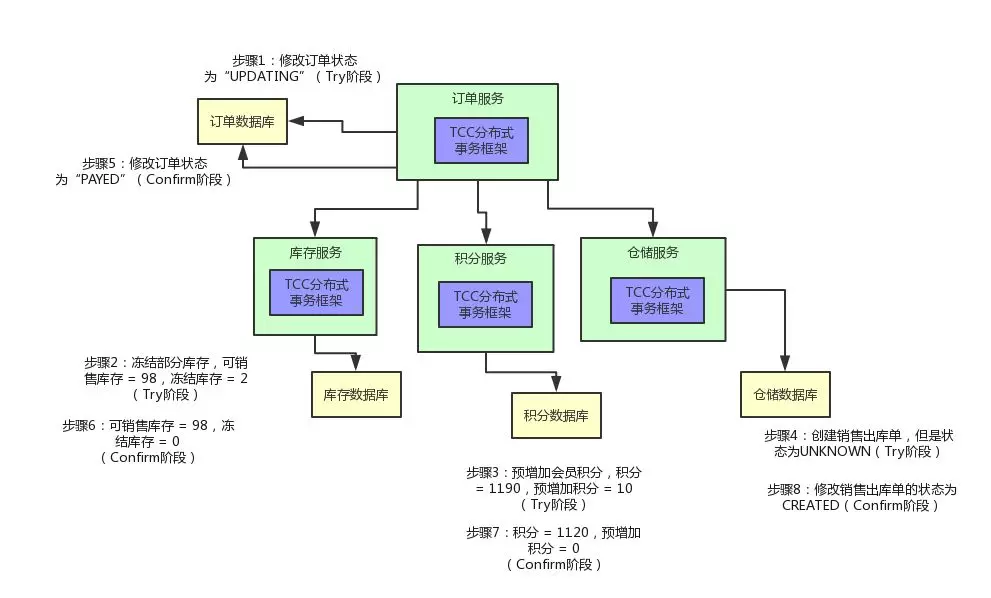
TCC也需要一个事务协调中心。它需要不断查询下游状态判断是否回滚或者向前恢复。
TCC 实现阶段一:Try
TCC 实现阶段二:Confirm
TCC 实现阶段三:Cancel

Saga 柔性事务
Saga 的核心思想就是将一个长事务分解为多个短事务(也叫子事务),每个子事务都是能保证自身一致性的本地事务,且每个子事务都有相应的执行模块和补偿模块。当其中任意一个子事务出错了,就可以通过调用相关的补偿方法恢复到事务的初始状态,从而达到事务的最终一致性。
总的来说,Saga 的组成包含两部分:
- 每个 saga 事务由一系列子事务 Ti 所组成
- 每个 Ti 都有对应的补偿动作 Ci,用于撤销 Ti 造成的结果
Saga 本身并不保证隔离性,需要业务自己控制并发,即在业务层自己实现对资源的加锁或预留。
最佳情况就是整个子事务序列 T1, T2, …, Tn 全部都执行成功,整个 Saga 事务也就执行成功了。
如果执行到某一子事务失败了,那有两种恢复方式:向前恢复和向后恢复。
- 向前恢复:重试失败的事务,假设每个子事务最终都会成功
- 向后恢复:补偿所有已完成的事务,本质就是所有已完成的本地事务进行回滚操作
目前业界提供了两类Saga的实现方式。 一个是集中式协调器的实现方式,一个分布式的实现方式。
- 集中式的Saga实现一般是通过一个Saga对象来追踪所有的Saga子任务的调用情况, 根据调用情况来决定是否需要调用对应的补偿方面,协调器和调用方是在一个进程中的。Saga任务会根据执行的情况向Saga log中记录对应的Saga事务的关键事件,同时我们的事件查看器查看到Saga事务相关的执行情况。
- 事件驱动。 采用事件源的方式降低系统复杂程度,提升系统扩展性, 处理模块通过订阅事件的方式降低系统的耦合程度。当然这也的实现也有一些问题: saga系统会涉及大量的业务事件,这样会对编码和调试会带来一些问题;还有就是相关的业务逻辑处理是基于事件,相关事件处理模块可能会有循环依赖的问题。
事务消息型 柔性事务
事务消息型,也称异步确保型,核心思路就是:用消息队列(MQ)来保证最终一致性。相比同步的补偿型方案,引入 MQ 的异步方案
引入 MQ 之后,最核心的问题在于如何解决服务本地事务处理成功与消息发送成功两者的一致性问题。即 MQ 消息的上游服务处理完本地事务之后,如何才能保证消息可靠地传递给到下游服务。而目前业界解决该问题的方案有两种:
- 基于 MQ 自身的事务消息。目前只有 RocketMQ 提供了支持,其他主流的 MQ 都还不支持,所以我们对该方案的解说都是基于 RocketMQ 的。MQ的Broker当做事务一部分,支持撤销和事务写入。
- 事务消息:消息队列 MQ 提供类似 X/Open XA 的分布式事务功能,通过 MQ 事务消息能达到分布式事务的最终一致。
- 半事务消息:暂不能投递的消息,发送方已经成功地将消息发送到了 MQ 服务端,但是服务端未收到生产者对该消息的二次确认,此时该消息被标记成“暂不能投递”状态,处于该种状态下的消息即半事务消息。
- 消息回查:由于网络闪断、生产者应用重启等原因,导致某条事务消息的二次确认丢失,MQ 服务端通过扫描发现某条消息长期处于“半事务消息”时,需要主动向消息生产者询问该消息的最终状态(Commit或是Rollback),该询问过程即消息回查。
- 基于 DB 的本地消息表。consumer接收到消息回查DB看事务状态。性能不好。
主要是RocketMQ这种形式。