mysql原理-锁
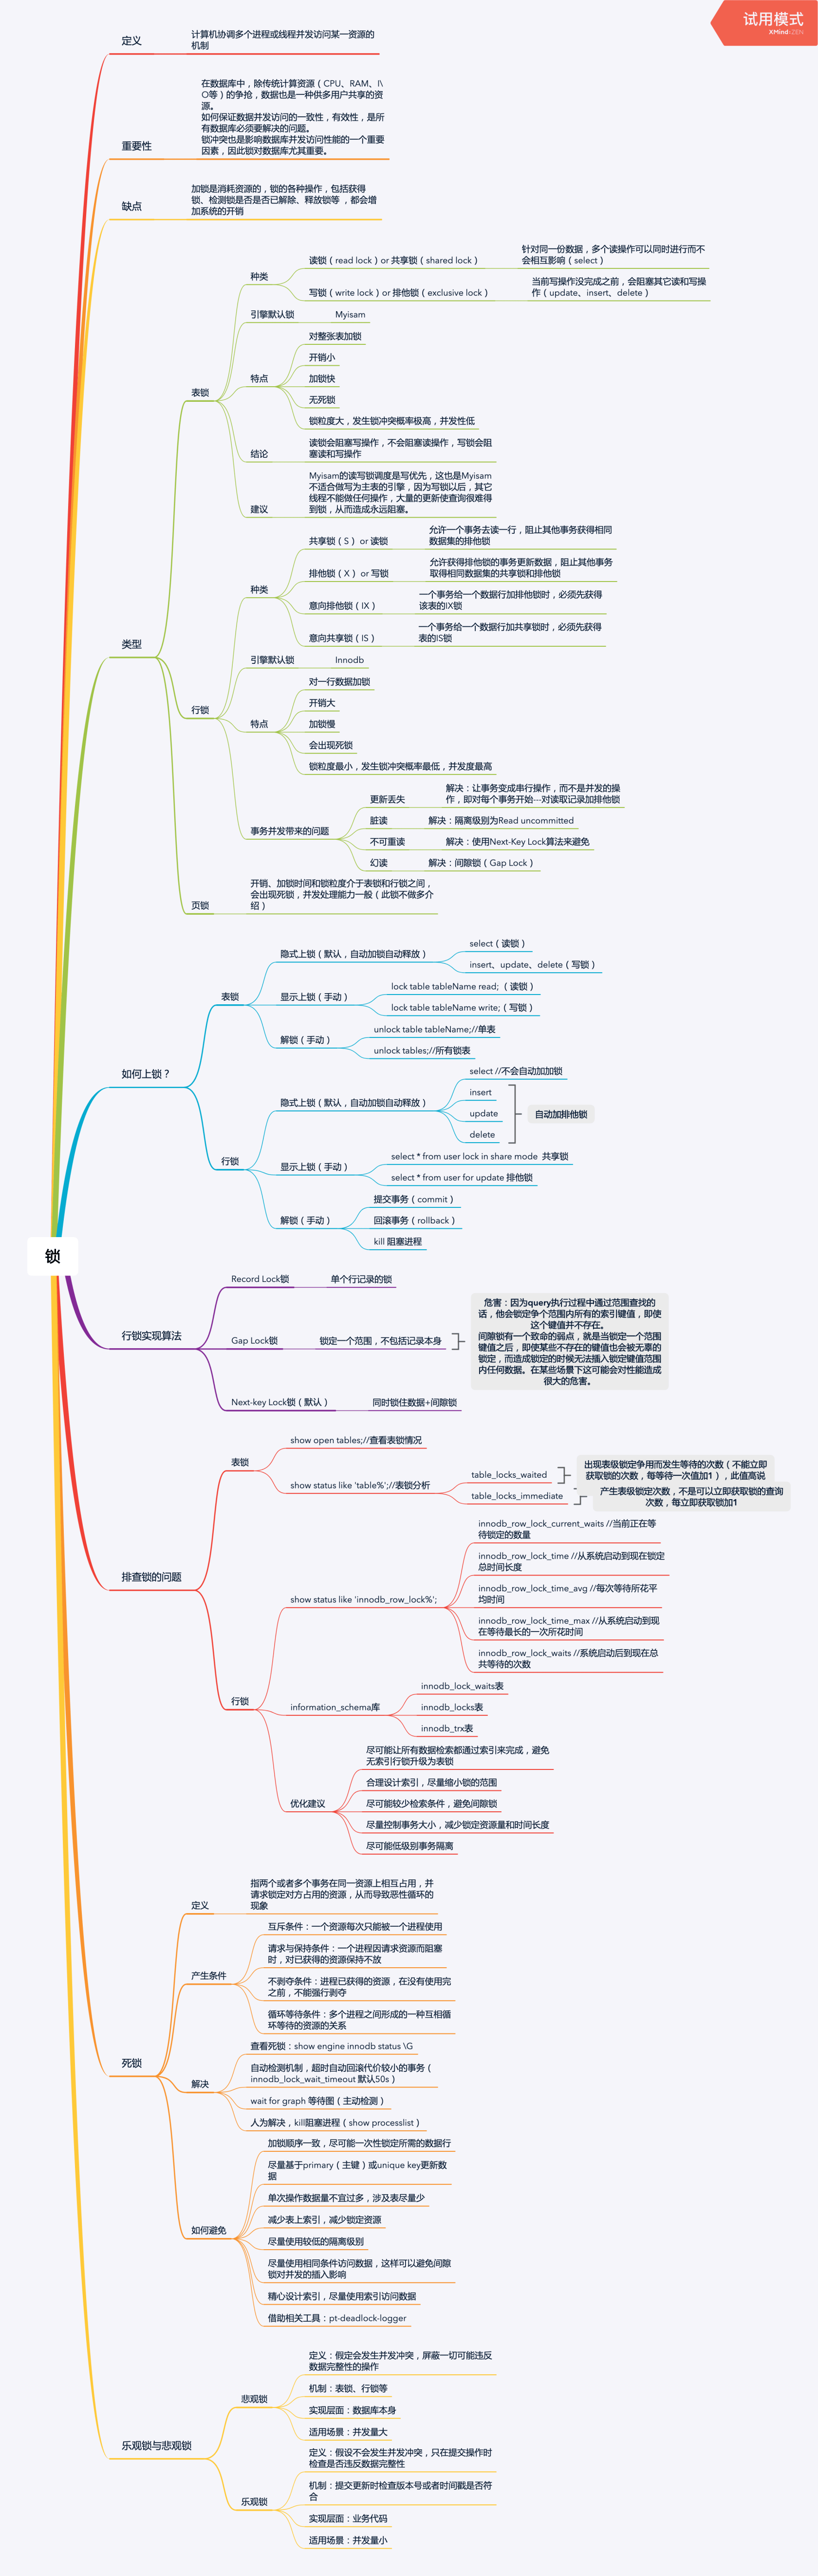
锁介绍
myisam只有表锁
innodb有表锁,行锁,页锁等。
行锁:
行锁分为共享锁(读锁,S)和排他锁(写锁,X)
insert、update、delete,innodb会自动给那一行加行级排他锁
RR下,select默认无锁,通过MVCC实现,除非自己select语句上加锁。
主动加共享锁:select * from table where id=1 lock in share mode
主动加排他锁:select * from table where id=1 for update
innodb存储引擎的默认锁模式: 一行数据,同一个时刻只能一个人在修改,但是别人修改,你可以随便读,读是读某个版本的,走mvcc机制。
行锁获取和释放时机:
- 需要时加锁
- 事务提交时释放锁,因此如果你的事务中需要锁多个行,要把最可能造成锁冲突、最可能影响并发度的锁尽量往后放。
表锁和意向共享锁:
表锁里除了表排他锁和表共享锁还有意向共享锁: 用于更新全表时不用检查每行的行锁。所以需要加行锁前先加意向共享锁。分为意向共享锁和意向排他锁: 加共享行锁的时候,必须先加这个共享表锁;还有一个意向排他锁,就是说,给某行加排他锁的时候,必须先给表加排他锁。这个表锁,是innodb引擎自动加的。
锁类别:
- Record lock:单个行记录上的锁
- Gap lock:间隙锁,锁定一个范围,不包括记录本身
- Next-key lock:record+gap 锁定一个范围,包含记录本身
通过锁实现隔离级别
注意是用锁实现隔离级别,实际上是通过mvcc以及间隙锁实现的。
在Read Uncommitted级别下,读取数据不需要加共享锁,这样就不会跟被修改的数据上的排他锁冲突
在Read Committed级别下,读操作需要加共享锁,但是在语句执行完以后释放共享锁;解决脏读问题,不会读编辑一半的。
在Repeatable Read级别下,读操作需要加共享锁,但是在事务提交之前并不释放共享锁,也就是必须等待事务执行完毕以后才释放共享锁。解决不可重复读问题。
SERIALIZABLE 是限制性最强的隔离级别,因为该级别锁定整个范围的键,并一直持有锁,直到事务完成。
InnoDB存储引擎的锁的算法有三种
相关知识点:
- todo
快照读和当前读
快照读
快照读也叫非阻塞读,即所谓快照读就是不加锁的非阻塞读,就是我们最简单的 select操作
当然了,这里不加锁的非阻塞读是以事务隔离级别不为最高级别的前提下成立,因为在最高隔离级别下,快照读也会变成当前读,在其后自动加lock in share mode
当前读: 需要共享锁或者排他锁
诸如select ... lock in share mode、select ... for update、update、delete、insert均为当前读;当前读本质上是加了锁的增删该查语句,无论上的是共享锁还是排他锁均为当前读.
当前读会读最新版本,如果有正在加锁的事务,会等待锁释放才进行。
这些语句被称为当前读的根本原因是因为它读取的是记录的最新版本,并且在读取之后,还需保证其他事务不能修改当前记录,对读取的记录加锁;上面的除 select 语句加的是共享锁外,其他的都是排他锁,那为什么 update、delete、insert也被称为当前读呢?
我们在执行 update语句更新某几行数据时,每次都需要先读取相应数据行,然后在更新,这个时候在读取的时候需要读取最新行,所以需要使用当前读
实现原理
之所以出现快照读,是基于提升并发访问性能考虑的;快照读的实现是基于多版本的并发控制,即 MVCC,可以认为 MVCC 是行级锁的一个变种,但是它在很多情况下避免了加锁的操作,因此开销更低. 既然基于多版本实现,那么快照读有可能读到的并不是数据的最新版本,可能是之前的历史版本。
在RR级别下,快照读是通过MVCC(多版本控制)和undo log来实现的,当前读是通过加record lock(记录锁)和gap lock(间隙锁)来实现的。
当前读这种情况下都会开启间隙锁。间隙锁不分共享锁和排它锁。
MVCC只在读提交可重复读两种隔离级别下工作
意向锁
首先意向锁是表级别的锁,是InnoDB存储引擎自己维护的,用户无法手动添加意向锁。
当我们要对某个page中的一行记录进行锁定时,需要对上层的table加意向锁——IS/IX,意为该事务中有意向对表中的某些行加X、S锁。
主要是方便检查 表级别锁和行级别锁的冲突
IX,IS是表级锁,不会和行级的X,S锁发生冲突。只会和表级的X,S发生冲突
再来回答意向锁的作用。意向锁是在添加行锁之前添加。
当再向一个表添加表级X锁的时候
- 如果没有意向锁的话,则需要遍历所有整个表判断是否有行锁的存在,以免发生冲突
- 如果有了意向锁,只需要判断该意向锁与即将添加的表级锁是否兼容即可。因为意向锁的存在代表了,有行级锁的存在或者即将有行级锁的存在。因而无需遍历整个表,即可获取结果
意向锁间相互兼容,对行级锁不生效,
注意:这里的排他 / 共享锁指的都是表锁!!!意向锁不会与行级的共享 / 排他锁互斥!!!

InnoDB 行锁实现方式:
行锁是加在索引上的
Innodb中的索引数据结构是 B+ 树,数据是有序排列的,从根节点到叶子节点一层层找到对应的数据。
普通索引,也叫做辅助索引,叶子节点存放的是主键值。主键上的索引叫做聚集索引,表里的每一条记录都存放在主键的叶子节点上。当通过辅助索引select 查询数据的时候,会先在辅助索引中找到对应的主键值,然后用主键值在聚集索引中找到该条记录。
举个例子,用name=Alice来查询的时候,会先找到对应的主键值是18 ,然后用18在下面的聚集索引中找到name=Alice的记录内容是 77 和 Alice。
表中每一行的数据,是组织存放在聚集索引中的,所以叫做索引组织表。
- InnoDB 行锁是通过给索引上的索引项加锁来实现的,这一点 MySQL 与 Oracle 不同,后者是通过在数据块中对相应数据行加锁来实现的。InnoDB 这种行锁实现特点意味着:只有通过索引条件检索数据,InnoDB 才使用行级锁,否则,InnoDB 将使用表锁!也就是说加锁读的时候,没有命中索引的话就全锁了
- 不论是使用主键索引、唯一索引或普通索引,InnoDB 都会使用行锁来对数据加锁。
- 只有执行计划真正使用了索引,才能使用行锁:即便在条件中使用了索引字段,但是否使用索引来检索数据是由 MySQL 通过判断不同执行计划的代价来决定的,如果 MySQL 认为全表扫描效率更高,比如对一些很小的表,它就不会使用索引,这种情况下 InnoDB 将使用表锁,而不是行锁。因此,在分析锁冲突时,别忘了检查 SQL 的执行计划(可以通过 explain 检查 SQL 的执行计划),以确认是否真正使用了索引。(更多阅读:MySQL索引总结)
- 由于 MySQL 的行锁是针对索引加的锁,不是针对记录加的锁,所以虽然多个session是访问不同行的记录, 但是如果是使用相同的索引键, 是会出现锁冲突的(后使用这些索引的session需要等待先使用索引的session释放锁后,才能获取锁)。 应用设计的时候要注意这一点。
select * from user where name=‘d’ for update
这里的name上加了唯一索引,唯一索引本质上是辅助索引,加了唯一约束。所以会先在辅助索引上找到name为d的索引记录,在辅助索引中加锁,然后查找聚集索引,锁住对应索引记录。
为什么聚簇索引上的记录也要加锁?
试想一下,如果有并发的另外一个SQL,是直接通过主键索引id=30来更新,会先在聚集索引中请求加锁。如果只在辅助索引中加锁的话,两个并发SQL之间是互相感知不到的。
锁优化原则
相关知识
- innodb对于行的查询使用next-key lock, 如果用了锁就是这种锁定范围
- Next-locking keying为了解决Phantom Problem幻读问题
- 当查询的索引含有唯一属性时,将next-key lock降级为record key
- Gap锁设计的目的是为了阻止多个事务将记录插入到同一范围内,而这会导致幻读问题的产生
- 要禁止间隙锁的话,可以A. 将事务隔离级别设置为RC B. 将参数innodb_locks_unsafe_for_binlog设置为1
因为间隙锁在可重复读隔离级别下才有效,所以本篇文章接下来的描述,若没有特殊说明,默认是可重复读隔离级别。RR下
加锁规则里面,包含了两个“原则”、两个“优化”和一个“bug”。
原则 1:加锁的基本单位是 next-key lock。希望你还记得,next-key lock 是前开后闭区间。
原则 2:查找过程中访问到的对象才会加锁。
优化 1:索引上的等值查询,给唯一索引加锁的时候,next-key lock 退化为行锁。比如INSERT INTO users (id, name, age) VALUES (2, 'Bob', 30);
优化 2:索引上的等值查询,向右遍历时且最后一个值不满足等值条件的时候,next-key lock 退化为间隙锁。
一个 bug:唯一索引上的范围查询会访问到不满足条件的第一个值为止。
死锁
事务A:
select * from table where id=1 for update
事务B:
select * from table where id=2 for update
事务A:
select * from table where id=2 for update
事务B:
select * from table where id=1 for update
常见的死锁就是类似上面那种,分别都持有一个锁,结果还去请求别人持有的那把锁,结果就是谁也出不来,死锁了。
封锁协议
1. 三级封锁协议
一级封锁协议 类似读未提交
事务 T 要修改数据 A 时必须加 X 锁,直到 T 结束才释放锁。
可以解决丢失修改问题,因为不能同时有两个事务对同一个数据进行修改,那么事务的修改就不会被覆盖。
二级封锁协议 类似读已提交
在一级的基础上,要求读取数据 A 时必须加 S 锁,读取完马上释放 S 锁。
可以解决读脏数据问题,因为如果一个事务在对数据 A 进行修改,根据 1 级封锁协议,会加 X 锁,那么就不能再加 S 锁了,也就是不会读入数据。
三级封锁协议 类似可重复读 解决不可重复读
在二级的基础上,要求读取数据 A 时必须加 S 锁,直到事务结束了才能释放 S 锁。
可以解决不可重复读的问题,因为读 A 时,其它事务不能对 A 加 X 锁,从而避免了在读的期间数据发生改变。
2. 两段锁协议
加锁和解锁分为两个阶段进行。
可串行化调度是指,通过并发控制,使得并发执行的事务结果与某个串行执行的事务结果相同。串行执行的事务互不干扰,不会出现并发一致性问题。
事务遵循两段锁协议是保证可串行化调度的充分条件。例如以下操作满足两段锁协议,它是可串行化调度。
lock-x(A)...lock-s(B)...lock-s(C)...unlock(A)...unlock(C)...unlock(B)
但不是必要条件,例如以下操作不满足两段锁协议,但它还是可串行化调度。
lock-x(A)...unlock(A)...lock-s(B)...unlock(B)...lock-s(C)...unlock(C)
事务里咋用锁
锁何时加的
insert、update、delete,innodb会自动给那一行加行级排他锁
RR下,select默认无锁,通过MVCC实现,除非自己select语句上加锁。
主动加共享锁:select * from table where id=1 lock in share mode
主动加排他锁:select * from table where id=1 for update
innodb存储引擎的默认锁模式: 一行数据,同一个时刻只能一个人在修改,但是别人修改,你可以随便读,读是读某个版本的,走mvcc机制。
锁何时释放的
- RR下。 事务提交时释放锁,因此如果你的事务中需要锁多个行,要把最可能造成锁冲突、最可能影响并发度的锁尽量往后放。
其他隔离级别的见上文。
先读再更新正确用法
因此RR下,如果事务里是先读A,再更新A为xx数据,读A是不加锁的普通select,更新A前有可能A已经被更新了。这种情况最好就是事务开始时就写锁锁住,之后再更新。
否则正常情况下,RR用了MVCC普通select没用锁
如果是读锁,然后同时有人先读锁,再写锁更新,可能会有问题。所以应该先写锁。