mysql原理-日志存储系统
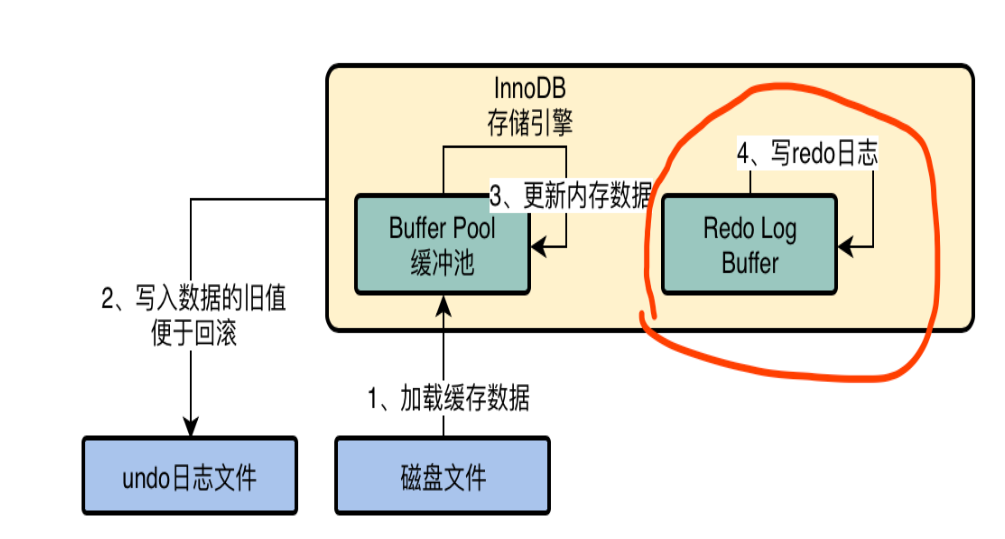
各个log的作用
binlog 主要用于数据恢复和主从复制。它记录了所有对数据库执行的修改操作(如 INSERT、UPDATE、DELETE),以逻辑日志的形式保存。binlog 是 MySQL Server 层提供的日志,独立于存储引擎。
redo log 主要用于数据持久化和崩溃恢复。redo log 是 InnoDB 存储引擎特有的日志,用于记录数据的物理修改,确保数据库在崩溃或异常宕机后能够恢复到一致状态。
undo log 主要用于支持事务回滚和多版本并发控制(MVCC)。undo log 是 InnoDB 存储引擎提供的逻辑日志,用于记录数据的逻辑操作,如删除、更新前的数据快照。
1:重做日志(redo log)
作用:确保事务的持久性。防止在发生故障的时间点,尚有脏页未写入磁盘,在重启mysql服务的时候,根据redo log进行重做,从而达到事务的持久性这一特性。
- Innodb 特有的。
- redolog其实是类似于一个环形队列的概念,是可以重复利用的。像下面这个图,绿色的部分就是可以写入区的大小,如果写满了,那么这个时候就需要根据redolog,将内存中的数据,同步到磁盘里面去,这样才可以继续利用redolog记录数据变更。redolog其实记录的是针对具体数据页的操作,而不是记录的执行的sql。
- WAL技术,write ahead log
- 一次事务,redolog至少更新两次,一次是update操作,一次是标记提交状态。
redo log 是一种二进制日志文件,记录了物理层面的页修改操作。 不是sql, 例子
- Page #: 数据页编号,表明修改的是哪个数据页。
- Change Data: 对该页的具体修改内容。
+----------------+----------------+------------------+-------------+
| Log Sequence # | Transaction ID | Page #           | Change Data |
+----------------+----------------+------------------+-------------+
产生与释放:事务开始之后就产生redo log;当对应事务的脏页写入到磁盘之后,redo log的使命也就完成了。
2:回滚日志(undo log)
作用:保证数据的原子性,保存了事务发生之前的数据的一个版本,可以用于回滚。 产生与释放:事务开始之前,将当前版本生成undo log;当事务提交之后,undo log并不能立马被删除,而是放入待清理的链表,最后决定是否可以清理undo log的日志空间。
undo日志用于记录事务开始前的状态,用于事务失败时的回滚操作;redo日志记录事务执行后的状态,用来恢复未写入data file的已成功事务更新的数据。例如某一事务的事务序号为T1,其对数据X进行修改,设X的原值是5,修改后的值为15,那么Undo日志为<T1, X, 5>,Redo日志为<T1, X, 15>。
和redolog一样其实也是存储引擎层维护的,undolog是回退日志,提供回滚操作。undo log 用来回滚行记录到某个版本。undo log 一般是逻辑日志,根据每行记录进行记录。保证事务的原子性,innodb使用它来实现MVCC.Undo 记录某 数据 被修改 前 的值,可以用来在事务失败时进行 rollback。Redo 记录某 数据块 被修改 后 的值,可以用来恢复未写入 data file 的已成功事务更新的数据。
3:二进制日志(binlog)
作用:在主从复制中,从库利用主库上的binlog进行重播,实现主从同步。用于数据库的基于时间点的还原。 产生与释放:事务提交的时候,一次性将事务中的sql语句按照一定的格式记录到binlog中;超过配置的天数之后会被自动删除(默认永久不删除
binlog 是 mysql server 层维护的,跟采用何种引擎没有关系,记录的是所有引擎的更新操作的日志记录。最开始没有第三方存储引擎开发的时候其实mysql只有binglog,这个历史原因导致了binlog其实只是逻辑层面的。redo/undo 记录的是 每个页/每个数据 的修改情况,属于物理日志+逻辑日志结合的方式(redo log 是物理日志,undo log 是逻辑日志)。binlog 记录的都是事务操作内容,
binlog 有三种模式:
Statement(基于 SQL 语句的复制)、Row(基于行的复制,修改前后的数据) 以及 Mixed(混合模式)。不管采用的是什么模式,当然格式是二进制的。redo/undo 在 事务执行过程中 会不断的写入,而 binlog 是在 事务最终提交前 写入的。也就是二阶段提交。
row级别下,不记录sql语句上下文相关信息,仅保存哪条记录被修改。记录单元为每一行的改动,基本是可以全部记下来但是由于很多操作,会导致大量行的改动(比如alter table),因此这种模式的文件保存的信息太多,日志量太大。
- 在这种格式下,binlog 记录的是每一行的具体变化,而不是 SQL 语句本身。
mixed,一种折中的方案,普通操作使用statement记录,当无法使用statement的时候使用row。 此外,新版的MySQL中对row级别也做了一些优化,当表结构发生变化的时候,会记录语句而不是逐行记录。
- 结合了 STATEMENT 和 ROW 格式的优点,MySQL 会根据 SQL 语句的类型自动选择最合适的格式
Buffer pool vs change buffer
| 特点 | Buffer Pool | Change Buffer |
|---|---|---|
| 作用对象 | 数据页、索引页、Undo log 页 | 二级索引(非唯一索引) |
| 工作目的 | 提升整体查询性能,减少读取 I/O | 延迟二级索引的磁盘更新,减少随机写 I/O |
| 更新机制 | 修改后标记为脏页,异步刷盘 | 修改写入 Change Buffer,后续合并 |
| 配置参数 | innodb_buffer_pool_size | innodb_change_buffer_max_size |
| 主要优化场景 | 缓存常用数据,提升查询性能 | 写操作较多、二级索引较多的场景 |
| 兼容性限制 | 支持所有类型的数据 | 仅支持二级索引,且必须是非唯一索引 |
Buffer Pool
- 定义: Buffer Pool 是 InnoDB 存储引擎用于缓存数据页的主要内存区域。 它是一个缓存层,用来存储表和索引的数据页,以减少磁盘 I/O。
- 功能:
- 缓存经常访问的表数据和索引。
- 提高读取性能,因为数据可以直接从内存中读取,而不需要每次都从磁盘加载。
- 对数据页的修改先在 Buffer Pool 中完成,之后再异步刷新到磁盘。
- 作用对象:
- 数据页(table data pages)
- 索引页(index pages)
- Undo log 页等
- 工作流程:
- 当需要读取或修改数据时,InnoDB 首先尝试从 Buffer Pool 中获取。
- 如果数据不在 Buffer Pool 中,则从磁盘加载到 Buffer Pool。
- 数据修改后,标记为脏页(Dirty Pages),稍后再通过刷盘(flush)写入磁盘。
- 特点:
- 大小可以通过
innodb_buffer_pool_size配置。 - 用于提升整体的查询和写入性能。
- 大小可以通过
Change Buffer
定义: Change Buffer 是 InnoDB 存储引擎中专门为二级索引的写操作(
INSERT、DELETE和UPDATE)设计的缓存区域,用于延迟写入磁盘。功能:
- 延迟对二级索引的非唯一键的磁盘更新,减少随机 I/O。
- 将多个写操作合并,优化磁盘写入性能。
作用对象:
- 仅用于二级索引,且必须是非唯一索引。
- 不涉及主键和唯一索引。
- 适合批量插入、更新、删除,减少磁盘 I/O,如:
- 批量
INSERT(索引页不在内存中时提升效率) - 批量
UPDATE(只修改索引,不涉及数据) - 批量
DELETE(不立即修改索引页)
- 批量
工作流程:
当对非唯一二级索引进行
INSERT、UPDATE或DELETE时:- 如果索引页在 Buffer Pool(内存)中,直接修改内存页,并标记为脏页(Dirty Page),后续写入磁盘(Flush)。
- 如果索引页不在 Buffer Pool
- 正常情况:需要从磁盘读取索引页到 Buffer Pool,然后修改后再写回磁盘(随机 I/O,性能低)。
- 使用 Change Buffer:先将变更写入 Change Buffer(内存),不立即访问磁盘,后续通过合并(Merge)批量更新磁盘,减少 I/O 开销。
特点:
- 大小可以通过
innodb_change_buffer_max_size(默认是 Buffer Pool 的 25%)来配置。 - 改变的是磁盘 I/O 的时机,提升了写入性能。
- 大小可以通过
插入一条数据的过程
插入一条数据: insert into t(id,k) values(id1,k1),(id2,k2); 假设当前 k 索引树的状态,查找到位置后,k1 所在的数据页在内存 (InnoDB buffer pool) 中,k2 所在的数据页不在内存中
分析这条更新语句,你会发现它涉及了四个部分:内存、redo log(ib_log_fileX)、 数据表空间(t.ibd)、系统表空间(ibdata1)。 这条更新语句做了如下的操作(按照图中的数字顺序): 1、Page 1 在内存中,直接更新内存。 2、Page 2 没有在内存中,就在内存的 change buffer 区域,记录下“我要往 Page 2 插入一行”这个信息。 3、将上述两个动作记入 redo log 中(图中 3 和 4)。 做完上面这些,事务就可以完成了。所以,你会看到,执行这条更新语句的成本很低,就是写了两处内存,然后写了一处磁盘(两次操作合在一起写了一次磁盘),而且还是顺序写的。
查询一条语句的过程
1、读 Page 1 的时候,直接从内存返回。WAL 之后如果读数据,是不是一定要读盘,是不是一定要从 redo log 里面把数据更新以后才可以返回?其实是不用的。你可以看一下图 3 的这个状态,虽然磁盘上还是之前的数据,但是这里直接从内存返回结果,结果是正确的。 2、要读 Page 2 的时候,需要把 Page 2 从磁盘读入内存中,然后应用 change buffer 里面的操作日志,生成一个正确的版本并返回结果。 可以看到,直到需要读 Page 2 的时候,这个数据页才会被读入内存。 所以,如果要简单地对比这两个机制在提升更新性能上的收益的话,redo log 主要节省的是随机写磁盘的 IO 消耗(转成顺序写),而 change buffer 主要节省的则是随机读磁盘的 IO 消耗。
QA
为什么不能只用redolog或者undolog?
- Redo Log 保证事务的持久性
- Undo Log 保证事务的原子性
比如某一时刻数据库DOWN机了,有两个事务,一个事务已经提交,另一个事务正在处理。数据库重启的时候就要根据日志进行前滚及回滚,把已提交事务的更改写到数据文件,未提交事务的更改恢复到事务开始前的状态。即,当数据库 crash-recovery 时,通过 redo log将所有已经在存储引擎内部提交的事务应用 redo log 恢复,所有已经 prepared 但是没有 commit 的 transactions 将会应用 undo log 做 roll back。
- 假设只有 undo-log:那么就必须保证提交前刷脏完成,否则宕机时有些修改就在内存中丢失了,破坏了持久性。(这样带来了一个问题,那就是前面提到的性能差)
- 假设只有 redo-log:那么就不能随心所欲地在事务提交前刷脏,即无法支持大事务。(假如、某张表有 100 亿的 8 字节整数数据,就算不考虑其他东西带来的损耗,光 update 整张表至少要消耗 80G 的内存。如前所述,有了 undo-log,就可以随便刷脏。)
redo log和binlog区别
- redo log 是 InnoDB 引擎特有的;binlog 是 MySQL 的 Server 层实现的,所有引擎都可以使用。
- redo log 是物理日志,记录的是“在某个数据页上做了什么修改”;binlog 是逻辑日志,记录的是这个语句的原始逻辑,比如“给 ID=2 这一行的 c 字段加 1 ”。
- redo log 是循环写的,空间固定会用完;binlog 是可以追加写入的。“追加写”是指 binlog 文件写到一定大小后会切换到下一个,并不会覆盖以前的日志。
Mysql抖动
第一种是“redo log 写满了,要 flush 脏页”,这种情况是 InnoDB 要尽量避免的。因为出现这种情况的时候,整个系统就不能再接受更新了,所有的更新都必须堵住。如果你从监控上看,这时候更新数会跌为 0。
第二种是“内存不够用了,要先将脏页写到磁盘”,这种情况其实是常态。InnoDB 用缓冲池(buffer pool)管理内存,缓冲池中的内存页有三种状态:第一种是,还没有使用的;第二种是,使用了并且是干净页;第三种是,使用了并且是脏页。
InnoDB 的策略是尽量使用内存,因此对于一个长时间运行的库来说,未被使用的页面很少。而当要读入的数据页没有在内存的时候,就必须到缓冲池中申请一个数据页。这时候只能把最久不使用的数据页从内存中淘汰掉:如果要淘汰的是一个干净页,就直接释放出来复用;但如果是脏页呢,就必须将脏页先刷到磁盘,变成干净页后才能复用。所以,刷脏页虽然是常态,但是出现以下这两种情况,都是会明显影响性能的:一个查询要淘汰的脏页个数太多,会导致查询的响应时间明显变长;日志写满,更新全部堵住,写性能跌为 0,这种情况对敏感业务来说,是不能接受的。所以,InnoDB 需要有控制脏页比例的机制,来尽量避免上面的这两种情况。