B+ Tree原理
1. 数据结构
B Tree 指的是 Balance Tree,也就是平衡树。平衡树是一颗查找树,并且所有叶子节点位于同一层。
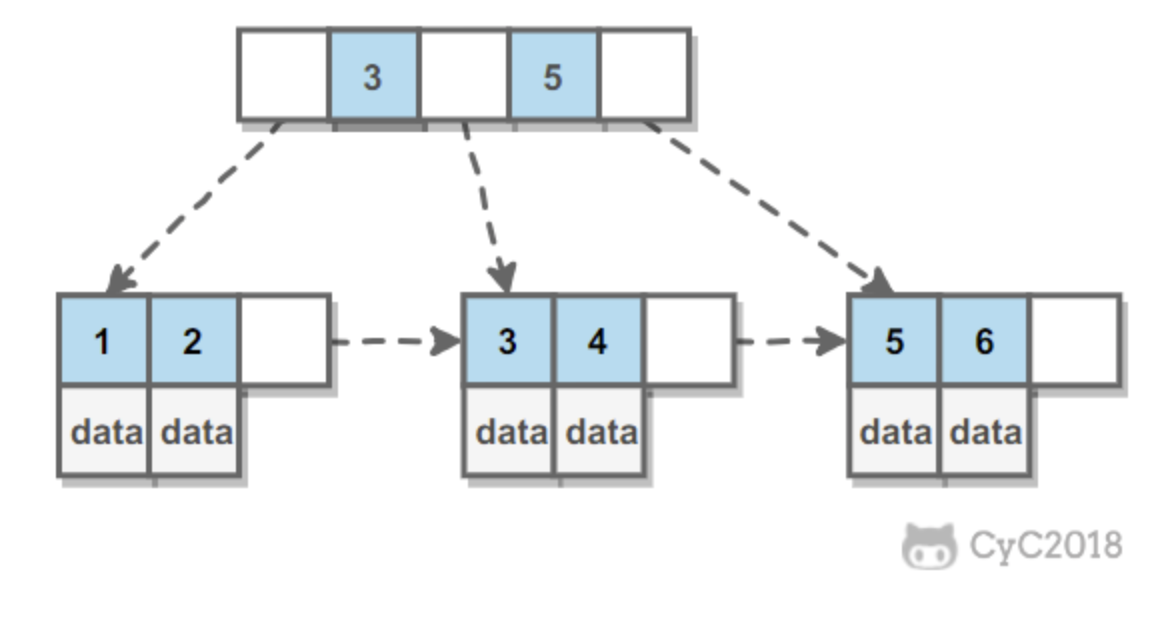
B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具有 B Tree 的平衡性,并且通过顺序访问指针来提高区间查询的性能。
在 B+ Tree 中,一个节点中的 key 从左到右非递减排列,如果某个指针的左右相邻 key 分别是 keyi 和 keyi+1,且不为 null,则该指针指向节点的所有 key 大于等于 keyi 且小于等于 keyi+1。
2. 操作
进行查找操作时,首先在根节点进行二分查找,找到一个 key 所在的指针,然后递归地在指针所指向的节点进行查找。直到查找到叶子节点,然后在叶子节点上进行二分查找,找出 key 所对应的 data。
插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对树进行分裂、合并、旋转等操作来维护平衡性。
3. 与红黑树的比较
红黑树等平衡树也可以用来实现索引,但是文件系统及数据库系统普遍采用 B+ Tree 作为索引结构,这是因为使用 B+ 树访问磁盘数据有更高的性能。
(一)B+ 树有更低的树高
平衡树的树高 O(h)=O(logdN),其中 d 为每个节点的出度。红黑树的出度为 2,而 B+ Tree 的出度一般都非常大,所以红黑树的树高 h 很明显比 B+ Tree 大非常多。
(二)磁盘访问原理
操作系统一般将内存和磁盘分割成固定大小的块,每一块称为一页,内存与磁盘以页为单位交换数据。数据库系统将索引的一个节点的大小设置为页的大小,使得一次 I/O 就能完全载入一个节点。
如果数据不在同一个磁盘块上,那么通常需要移动制动手臂进行寻道,而制动手臂因为其物理结构导致了移动效率低下,从而增加磁盘数据读取时间。B+ 树相对于红黑树有更低的树高,进行寻道的次数与树高成正比,在同一个磁盘块上进行访问只需要很短的磁盘旋转时间,所以 B+ 树更适合磁盘数据的读取。
(三)磁盘预读特性
为了减少磁盘 I/O 操作,磁盘往往不是严格按需读取,而是每次都会预读。预读过程中,磁盘进行顺序读取,顺序读取不需要进行磁盘寻道,并且只需要很短的磁盘旋转时间,速度会非常快。并且可以利用预读特性,相邻的节点也能够被预先载入。
4. B+tree性质:
1.)n棵子tree的节点包含n个关键字,不用来保存数据而是保存数据的索引。
2.)所有的叶子结点中包含了全部关键字的信息,及指向含这些关键字记录的指针,且叶子结点本身依关键字的大小自小而大顺序链接。
3.)所有的非终端结点可以看成是索引部分,结点中仅含其子树中的最大(或最小)关键字。
4.)B+ 树中,数据对象的插入和删除仅在叶节点上进行。
5.)B+树有2个头指针,一个是树的根节点,一个是最小关键码的叶节点。
5. B树和B+树的区别
- 在B树中,你可以将键和值存放在内部节点和叶子节点;但在B+树中,内部节点都是键,没有值,叶子节点同时存放键和值。
- B+树的叶子节点有一条链相连,而B树的叶子节点各自独立。

6. 数据库为什么使用B+树而不是B树
B树只适合随机检索,而B+树同时支持随机检索和顺序检索;
B+树空间利用率更高,非叶子节点占用空间小,可减少I/O次数,磁盘读写代价更低。一般来说,索引本身也很大,不可能全部存储在内存中,因此索引往往以索引文件的形式存储的磁盘上。这样的话,索引查找过程中就要产生磁盘I/O消耗。B+树的内部结点并没有指向关键字具体信息的指针,只是作为索引使用,其内部结点比B树小,盘块能容纳的结点中关键字数量更多,一次性读入内存中可以查找的关键字也就越多,相对的,IO读写次数也就降低了。而IO读写次数是影响索引检索效率的最大因素;
B+树的查询效率更加稳定。B树搜索有可能会在非叶子结点结束,越靠近根节点的记录查找时间越短,只要找到关键字即可确定记录的存在,其性能等价于在关键字全集内做一次二分查找。而在B+树中,顺序检索比较明显,随机检索时,任何关键字的查找都必须走一条从根节点到叶节点的路,所有关键字的查找路径长度相同,导致每一个关键字的查询效率相当。
B-树在提高了磁盘IO性能的同时并没有解决元素遍历的效率低下的问题。B+树的叶子节点使用指针顺序连接在一起,只要遍历叶子节点就可以实现整棵树的遍历。而且在数据库中基于范围的查询是非常频繁的,而B树不支持这样的操作。
增删文件(节点)时,效率更高。因为B+树的叶子节点包含所有关键字,并以有序的链表结构存储,这样可很好提高增删效率。
MySQL 索引
索引是在存储引擎层实现的,而不是在服务器层实现的,所以不同存储引擎具有不同的索引类型和实现。
1. B+Tree 索引
是大多数 MySQL 存储引擎的默认索引类型。
因为不再需要进行全表扫描,只需要对树进行搜索即可,所以查找速度快很多。
因为 B+ Tree 的有序性,所以除了用于查找,还可以用于排序和分组。
可以指定多个列作为索引列,多个索引列共同组成键。
适用于全键值、键值范围和键前缀查找,其中键前缀查找只适用于最左前缀查找。如果不是按照索引列的顺序进行查找,则无法使用索引。
B+ 树的非叶子节点存 m-1 个 key,叶子节点存 m-1 个 key-value。
B+ 树的 m 取决于磁盘页大小、key 大小、指针大小,m = (磁盘页大小) / (指针大小 + key 大小)。 数据库常见 m ≈ 100~200。
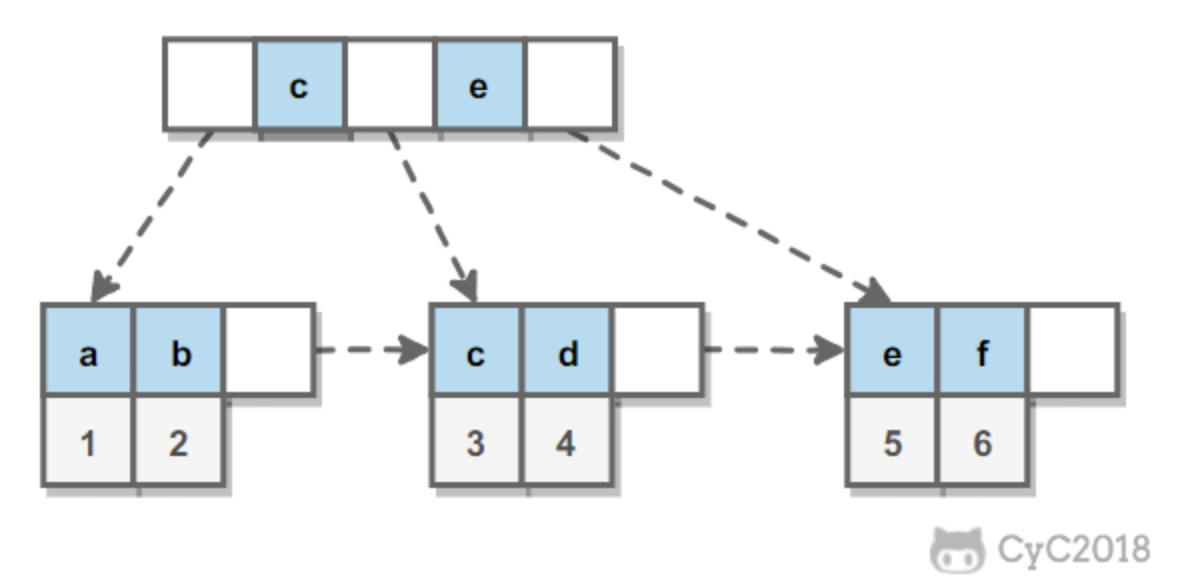
InnoDB 的 B+Tree 索引分为主索引和辅助索引。主索引的叶子节点 data 域记录着完整的数据记录,这种索引方式被称为聚簇索引。因为无法把数据行存放在两个不同的地方,所以一个表只能有一个聚簇索引。

辅助索引的叶子节点的 data 域记录着主键的值,因此在使用辅助索引进行查找时,需要先查找到主键值,然后再到主索引中进行查找。
2. 哈希索引
哈希索引能以 O(1) 时间进行查找,但是失去了有序性:
- 无法用于排序与分组;
- 只支持精确查找,无法用于部分查找和范围查找。
InnoDB 存储引擎有一个特殊的功能叫“自适应哈希索引”,当某个索引值被使用的非常频繁时,会在 B+Tree 索引之上再创建一个哈希索引,这样就让 B+Tree 索引具有哈希索引的一些优点,比如快速的哈希查找。
3. 全文索引
MyISAM 存储引擎支持全文索引,用于查找文本中的关键词,而不是直接比较是否相等。
查找条件使用 MATCH AGAINST,而不是普通的 WHERE。
全文索引使用倒排索引实现,它记录着关键词到其所在文档的映射。
InnoDB 存储引擎在 MySQL 5.6.4 版本中也开始支持全文索引。
4. 空间数据索引
MyISAM 存储引擎支持空间数据索引(R-Tree),可以用于地理数据存储。空间数据索引会从所有维度来索引数据,可以有效地使用任意维度来进行组合查询。
必须使用 GIS 相关的函数来维护数据。
联合索引原理
比如联合索引(a, b)
叶子节点拥有联合索引中的所有字段以及主键字段,且叶子节点数据局部有序
索引类型 非叶子节点存储内容 叶子节点存储内容 单列索引 ( a)仅存 aa+ 主键(如果是二级索引)联合索引 ( a, b)存储 (a, b)(a, b)+ 主键(如果是二级索引)📌 重点区别
- 联合索引 (
a, b) 的非叶子节点 **可能不完整存储b - 在大多数情况下,非叶子节点只存
a,但在a不是唯一键时,可能存储部分b以优化查找效率。MySQL 不会让非叶子节点存储过多额外数据,否则会影响查询性能和索引大小。 - 单列索引 (
a) 的非叶子节点 只存a,结构更简单。 - 在 B+ 树的非叶子节点中,存储的键值用于索引查找,它不需要存储所有的列值,只需要保证可以正确分区查找。
- 联合索引 (
什么时候不会新增非叶子节点?
叶子节点未满时,直接插入。假设 每个叶子节点最多能存储 4 条数据,4以内都可以不新增
- 仅在叶子节点分裂时,才会更新非叶子节点!类似红黑树,向上传递分裂。只有当非叶子节点也满时,才会新增非叶子层级!
- 删除时,数据量低于一半,会和兄弟借一个kv或节点合并
索引设计及优化
索引设计的原则
索引虽好,但也不是无限制的使用,最好符合一下几个原则
1) 最左前缀匹配原则,组合索引非常重要的原则,mysql会一直向右匹配直到遇到范围查询(>、<、between、like)就停止匹配,比如a = 1 and b = 2 and c > 3 and d = 4 如果建立(a,b,c,d)顺序的索引,d是用不到索引的,如果建立(a,b,d,c)的索引则都可以用到,a,b,d的顺序可以任意调整。
2)较频繁作为查询条件的字段才去创建索引
3)更新频繁字段不适合创建索引
4)若是不能有效区分数据的列不适合做索引列(如性别,男女未知,最多也就三种,区分度实在太低)
5)尽量的扩展索引,不要新建索引。比如表中已经有a的索引,现在要加(a,b)的索引,那么只需要修改原来的索引即可。
7)对于那些查询中很少涉及的列,重复值比较多的列不要建立索引。
8)对于定义为text、image和bit的数据类型的列不要建立索引。对于 BLOB、TEXT 和 VARCHAR 类型的列,必须使用前缀索引,只索引开始的部分字符。
9) 基数大的索引在前。
10) 如果对长字符串列进行索引,应该指定一个前缀长度,这样能够节省大量索引空间
索引失效情况
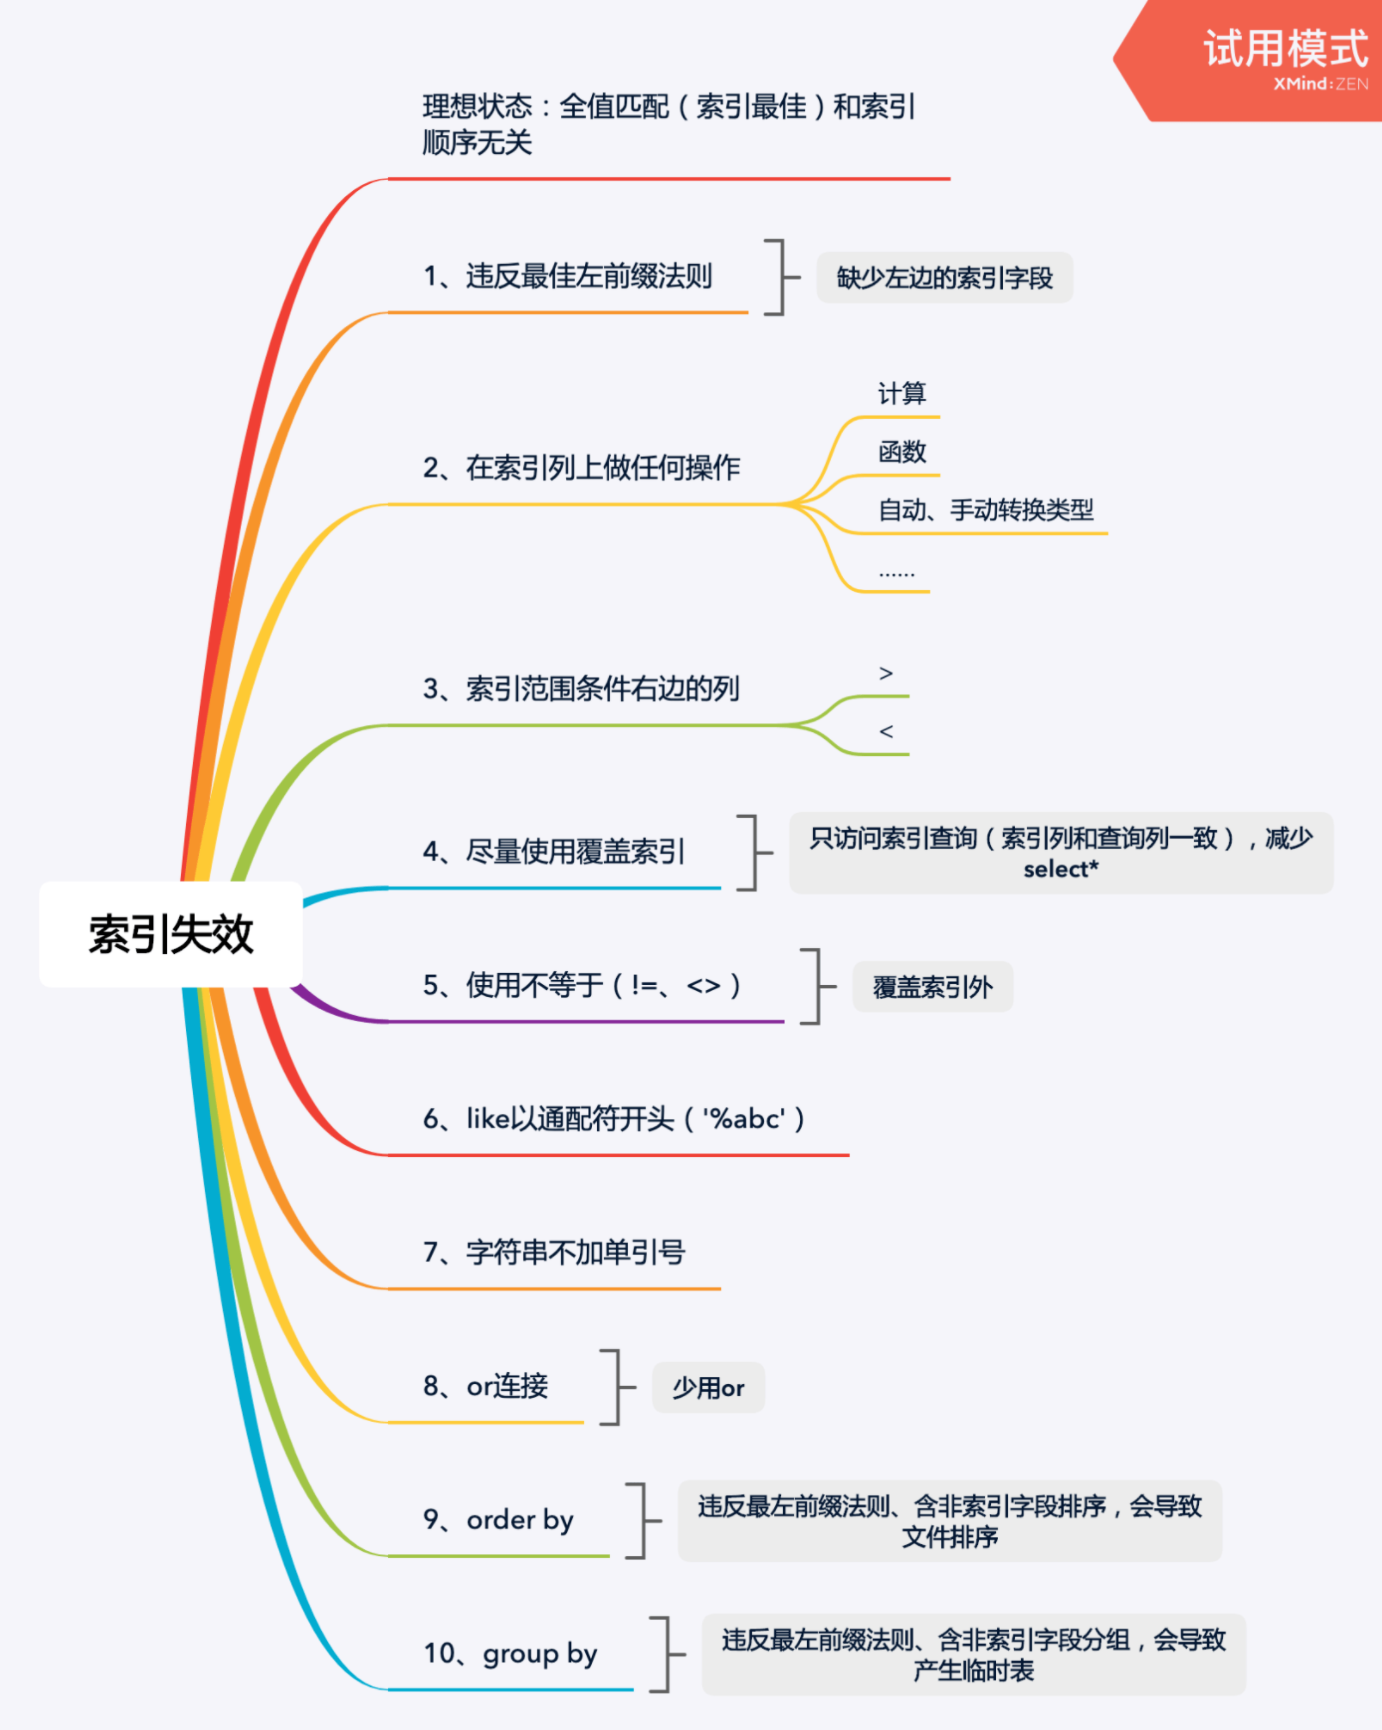
和索引顺序无关,MySQL底层的优化器会进行优化,调整索引的顺序。
索引失效情况:
违反最左前缀法则会索引失效: 如果索引有多列,要遵守最左前缀法则, 即查询从索引的最左前列开始并且不跳过索引中的列
在索引列上做任何操作会索引失效: 如计算、函数、(自动or手动)类型转换等操作,会导致索引失效从而全表扫描
索引范围条件右边的索引列会失效
select * from myTest  where a=3 and b>7 and c=3;     ---- b范围值,断点,阻塞了c的索引
a用到了,b也用到了,c没有用到,这个地方b是范围值,也算断点,只不过自身用到了索引


salary > 5000 AND salary < 50000 或者between算一个范围,有效的。 只有右边的索引会失效。


SELECT * FROM users WHERE age = 30 AND salary LIKE '%5000%' AND city = 'Beijing';
salary是范围查询,city索引会失效。

也就是说一个sql里最多只能有一个范围查询,还需要这个范围查询在最后才行。
在使用不等于(!=)的时候无法使用索引会导致全表扫描(除覆盖索引外)
like以通配符开头(’%abc’)会索引失效。因为是字典序排序的。 但前缀索引是有效的,可以当范围索引使用
字符串不加单引号索引失效 会索引失效。类型转换导致索引失效
or连接 会索引失效。如果
OR两侧的列分别有索引,可以使用UNION ALL分开查询。MySQL 5.6+ 支持INDEX MERGE优化,允许OR语句分别使用索引,然后union合并结果order by会索引失效,正常(索引参与了排序)备注:索引有两个作用:排序和查找。实际上是先order by然后order by用索引进行了排序。
group by会索引失效, 正常(索引参与了排序)备注:分组之前必排序(排序同order by)
null不在索引树上,但在叶子节点上。NULL 值通常排在最前面,但它不会影响索引的查询。唯一索引允许多个 NULL。NULL 不是一个具体值,不能进行比较。where xx is null 可能利用索引,但性能差,仅扫描叶子结点。 所以基本可以认为null是全表扫描,索引失效。具体看mysql优化情况。
覆盖索引
索引包含所有需要查询的字段的值。对于 InnoDB 引擎,若辅助索引能够覆盖查询,则无需访问主索引。
如果执行的语句是 select ID from T where k between 3 and 5,这时只需要查 ID 的值,而 ID 的值已经在 k 索引树上了,因此可以直接提供查询结果,不需要回表。也就是说,在这个查询里面,索引 k 已经“覆盖了”我们的查询需求,我们称为覆盖索引。
由于覆盖索引可以减少树的搜索次数,显著提升查询性能,所以使用覆盖索引是一个常用的性能优化手段。
索引下推
索引下推优化(index condition pushdown), 可以在索引遍历过程中,对索引中包含的字段先做判断,直接过滤掉不满足条件的记录,减少回表次数。
查询性能优化
使用 Explain 进行分析
Explain 用来分析 SELECT 查询语句,开发人员可以通过分析 Explain 结果来优化查询语句。
比较重要的字段有:
- select_type : 查询类型,有简单查询、联合查询、子查询等
- key : 使用的索引
- rows : 扫描的行数
优化数据访问
1. 减少请求的数据量
- 只返回必要的列:最好不要使用 SELECT * 语句。
- 只返回必要的行:使用 LIMIT 语句来限制返回的数据。
- 缓存重复查询的数据:使用缓存可以避免在数据库中进行查询,特别在要查询的数据经常被重复查询时,缓存带来的查询性能提升将会是非常明显的。
2. 减少服务器端扫描的行数
最有效的方式是使用索引来覆盖查询。
索引实现
Innodb 引擎和 Myisam 引擎的实现
两者都是B+树索引
MyISAM:索引存储的是数据的物理地址,查询快,但不支持事务。
InnoDB:主键索引存储整行数据,辅助索引存储主键值,可能需要二次回表,但支持事务,适合高并发场景。
| 对比项 | MyISAM | InnoDB |
|---|---|---|
| 存储文件 | frm(表结构)MYD(数据)MYI(索引) | frm(表结构)idb(数据 + 索引) |
| 索引存储 | 非聚簇索引(数据和索引分离) | 聚簇索引(数据和索引一起存储) |
| 主键索引 | 主索引 B+ 树,叶子节点存的是数据物理地址 | 主键索引 B+ 树,叶子节点存的是整行数据 |
| 辅助索引 | 存储的是数据物理地址 | 存储的是主键值,需要回表查询 |
| 查询效率 | 索引叶子节点直接存数据地址 | 主键查询快,但辅助索引查询需要二次回表(若无索引覆盖) |
| 适用场景 | 读多写少,对 SELECT 查询友好 | 事务处理、并发、更新操作多的场景 |
聚簇索引的叶子节点存储的就是完整的行数据,而非仅仅是指向数据的指针。
这样,索引本身就是数据,数据就是索引,自然存储在同一个文件中。
多个索引都会存储在同一个 .ibd 文件中,但它们的 B+ 树结构是分开的。
Innodb 关键特性
- 主键索引(聚簇索引)
- 叶子节点存储整行数据。
- 一个表只能有一个聚簇索引(通常是
PRIMARY KEY)。 - 如果没有主键,InnoDB 会自动创建隐藏主键。
- 辅助索引(二级索引)
- 叶子节点存储的是主键值,查询时可能需要回表查询数据。
- 主键索引(聚簇索引)
MyISAM 关键特性
- 非聚簇索引
- 索引叶子节点存的是数据的物理地址,索引和数据文件是分开的。
- 查询效率高(索引直接定位物理位置)。
- 索引存储
- 主索引和辅助索引存储结构相同,都存储数据的物理地址。需要再寻址一次才能得到数据。
- 非聚簇索引
为什么使用辅助索引
因为 InnoDB 需要节省存储空间。一个表里可能有很多个索引,InnoDB 都会给每个加了索引的字段生成索引树,如果每个字段的索引树都存储了具体数据,那么这个表的索引数据文件就变得非常巨大(数据极度冗余了)
查询性能比较,myisam查询更快
MyISAM 直接找到物理地址后就可以直接定位到数据记录,但是 InnoDB 查询到叶子节点后,还需要再查询一次主键索引树,才可以定位到具体数据。等于 MyISAM 一步就查到了数据,但是 InnoDB 要两步,那当然 MyISAM 查询性能更高。
Innodb聚簇索引实现
索引里的指针都是文件偏移量。实际上就是个链表。
文件通过页面缓存,都是按页读的,比如一页4KB.
因此聚簇索引是按主键id有序存的,但不会改动其他数据偏移位置。本质上是个链表,每条数据指向了下条数据以及上条数据偏移量也就是指针。
聚簇索引具有唯一性,由于聚簇索引是将数据跟索引结构放到一块,因此一个表仅有一个聚簇索引。
表中行的物理顺序和索引中行的物理顺序是相同的,在创建任何非聚簇索引之前创建聚簇索引,这是因为聚簇索引改变了表中行的物理顺序,数据行 按照一定的顺序排列,并且自动维护这个顺序;
聚簇索引默认是主键