搜索引擎
搜索引擎需要解决的三个问题:
- 建立资料库(爬虫技术)
- 建立一种数据结构,这种数据结构能够通过keyword找到链接,倒排索引。
- 对检索到的文档进行排序。
搜索引擎整体架构图如下图所示,大致可以分为 搜集 , 预处理 , 索引 , 查询 这四步
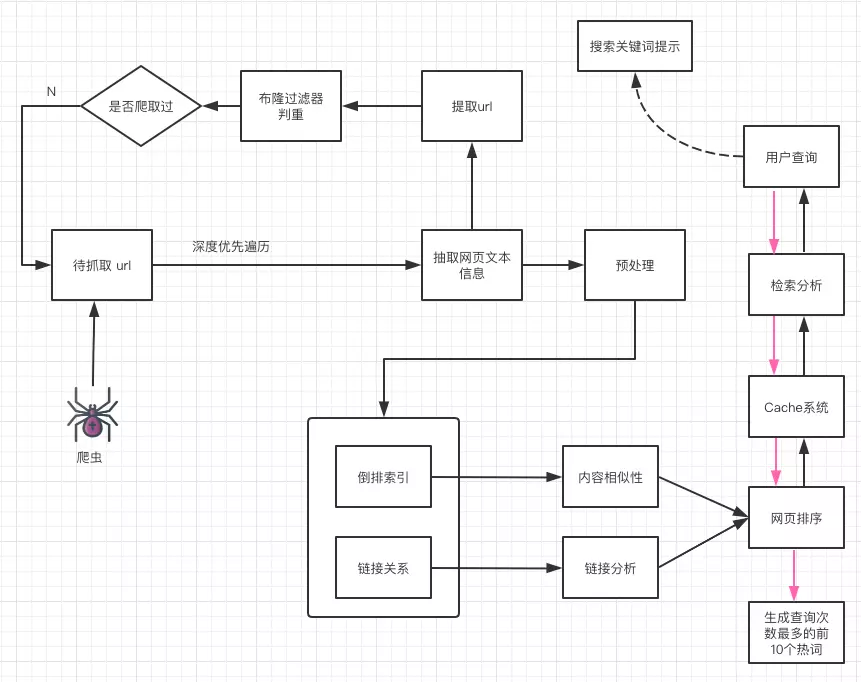
爬取
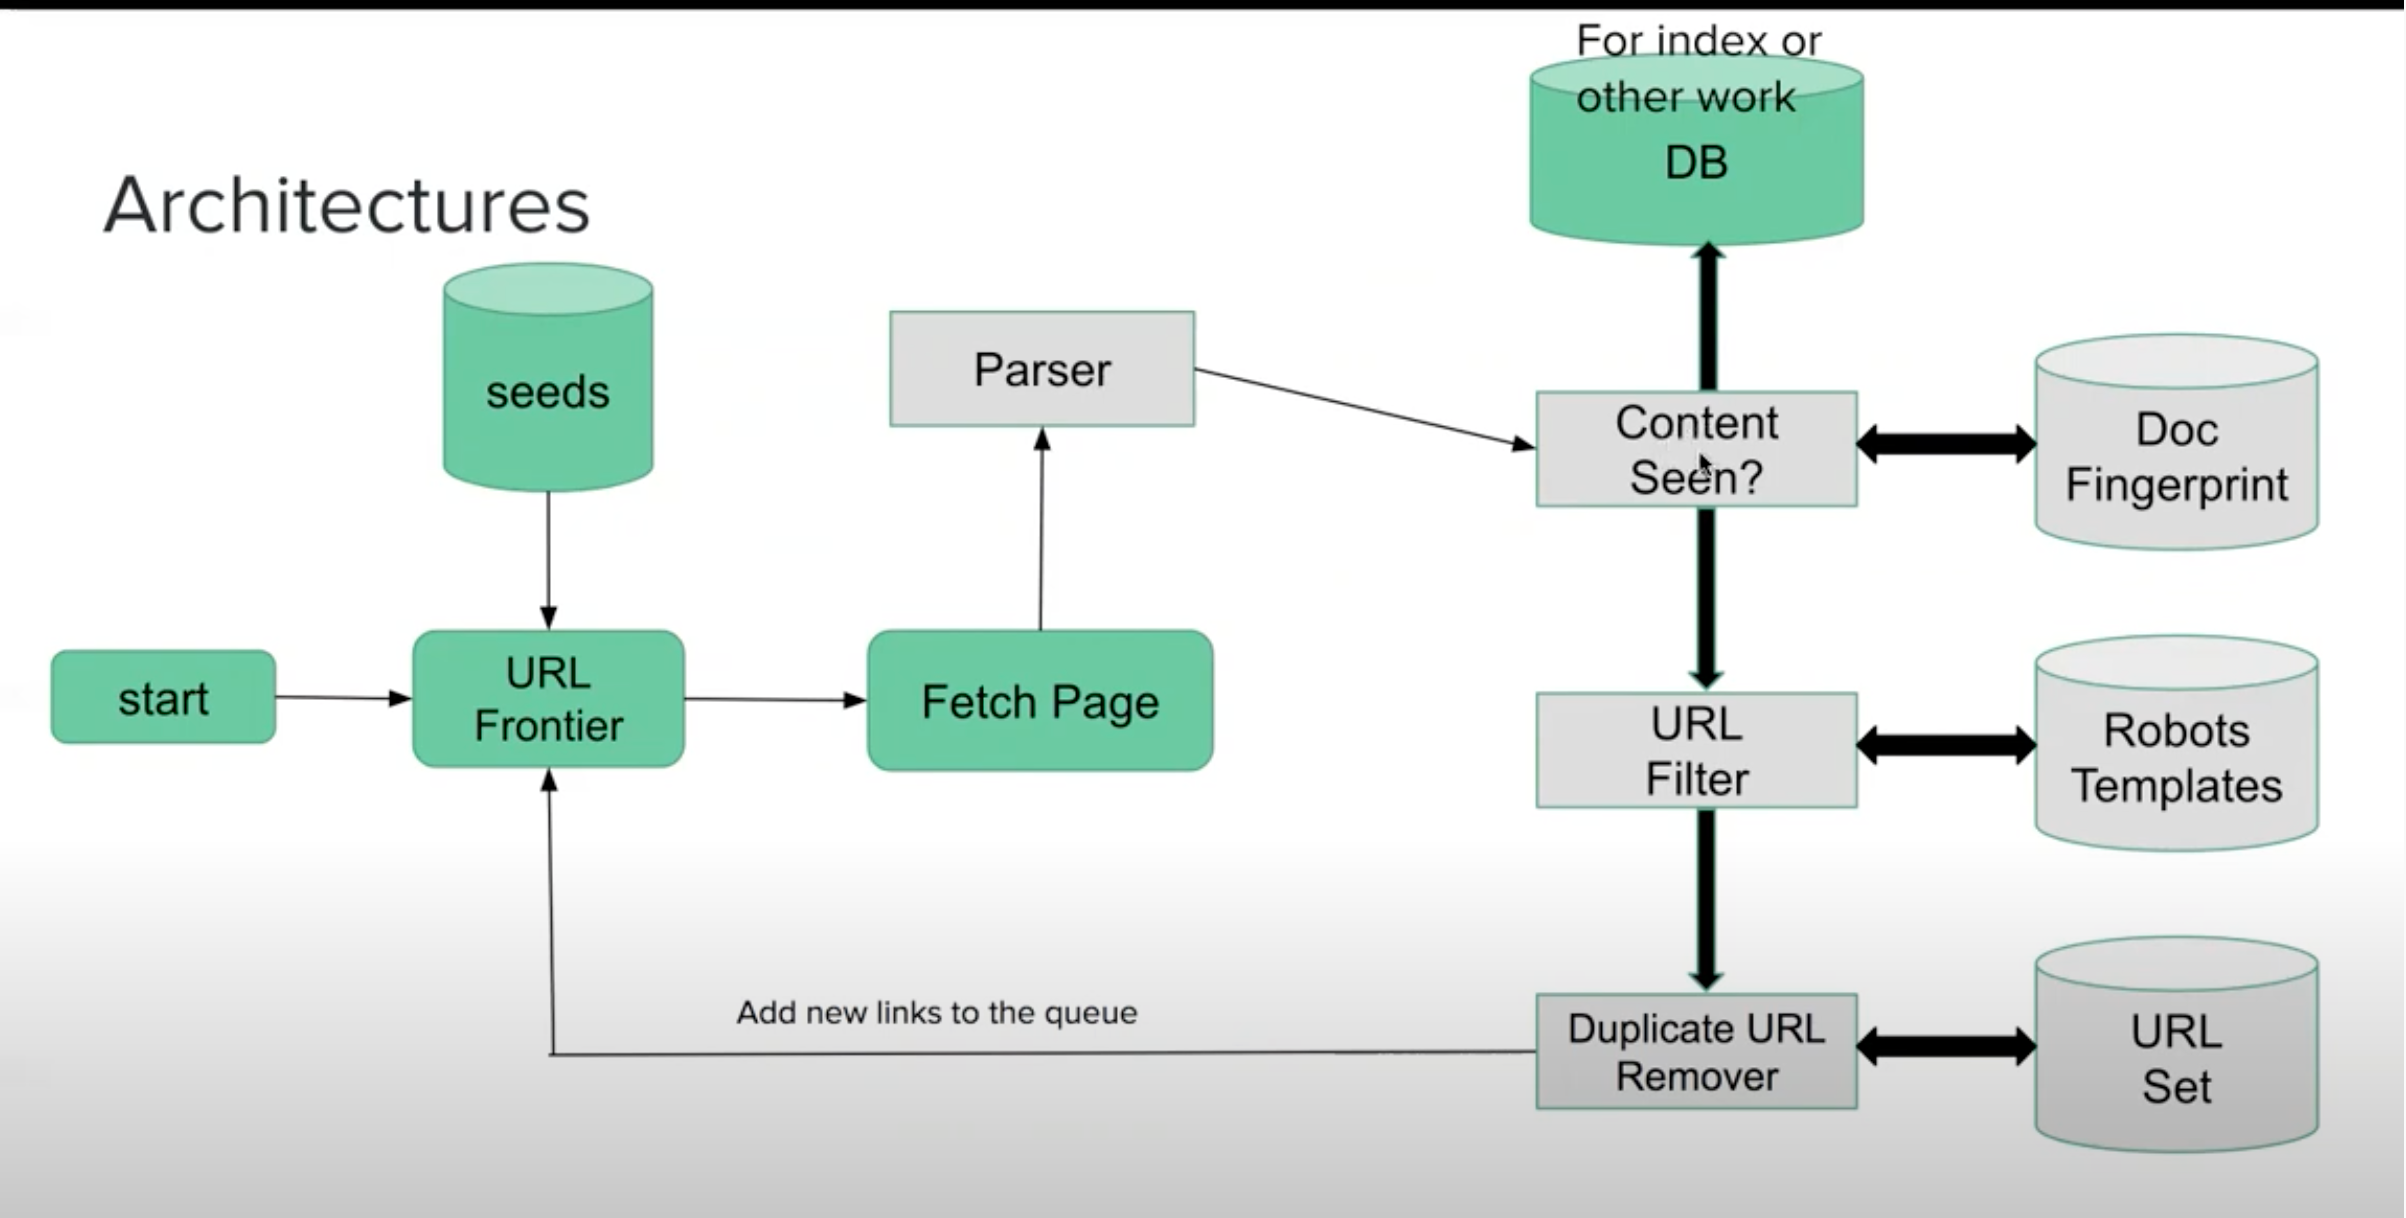
爬虫一开始是不知道该从哪里开始爬起的,所以我们可以给它一组优质种子网页的链接,比如新浪主页,腾讯主页等,这些主页比较知名,在 Alexa 排名上也非常靠前,拿到这些优质种子网页后,就对这些网页通过广度优先遍历BFS不断遍历这些网页,爬取网页内容,提取出其中的链接,不断将其将入到待爬取队列,然后爬虫不断地从 url 的待爬取队列里提取出 url 进行爬取,重复以上过程…
如何判重: 布隆过滤器或者指纹
存储
先拿到html后进行预处理,去掉<script 等标签。
分词: 划分成每个词
然后就是建倒排索引了。
临时的网页可以存储在HDFS里。
搜索可以使用ES,mysql数据同步到es里。参考
kafka对接mysql的slave,通过binlog方式把增量tweet读取出来,然后直接对接Elastic search建invert index,这样就能及时对lastest tweet建索引啦,用户也能很快的搜到新tweet。
流程很简单:
- 爬虫先爬取目录网页,比如首页等含有大量url的页面,解析出里面的url;
- url放bloomFilter里面去重,有重复的直接去掉,没重复的放入MessgaQueue,比如kafka、disruptor等
- 再由爬虫从MQ里读取url爬取具体的内容content;由于都是非结构化的数据,建议放分布式文件系统,譬如HDFS
- 存放好后就可以建倒排索引了,这个涉及到中文分词、MapReduce,索引建好后保存在NoSql数据库,比如cassandra、hbase等;key就是分词后的每个单词,value就是这个单词所在文章的编号index,倒排表。 index是一种典型的空间换时间的方式!
2、内容处理完毕,下一个就是要让用户查询了!用户输入关键词查询,可以先在redis查找一些hot key的index,再根据这些index去HDFS找到具体的content。如果redis没有缓存用户查询的key,就去Nosql数据库找!上面的流程也容易理解,下面重点介绍typeahead,也就是下面这种效果:用户输入一个关键词,联想出prefix top 10的历史query供用户参考选择!
爬虫构建typeahead 参考
搜索
排序
主要基于倒排索引,网页排序基于pagerank,PageRank让链接来”投票”
一个页面的“得票数”由所有链向它的页面的重要性来决定,到一个页面的超链接相当于对该页投一票。一个页面的PageRank是由所有链向它的页面(“链入页面”)的重要性经过递归算法得到的。一个有较多链入的页面会有较高的等级,相反如果一个页面没有任何链入页面,那么它没有等级。
搜索
用户输入关键词后,首先肯定是要经过分词器的处理。比如我输入「中国人民」,假设分词器分将其分为「中国」,「人民」两个词,接下来就用这个两词去倒排索引里查相应的文档
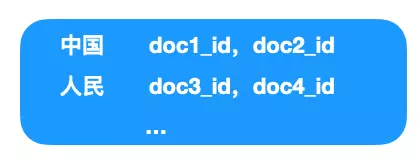
得到网页 id 后,我们分别去 doc 里提取出网页的链接和内容,按权重从大到小排列即可。
搜索联想提示词
如何实现的,这就不得不提到一种树形结构:Trie 树。Trie 树又叫字典树、前缀树(Prefix Tree)、单词查找树,是一种多叉树结构。
一般搜索引擎会维护一个词库,假设这个词库由所有搜索次数大于某个阈值(如 1000)的字符串组成,我们就可以用这个词库构建一颗 Trie 树,这样当用户输入字母的时候,就可以以这个字母作为前缀去 Trie 树中查找,以上文中提到的 Trie 树为例,则我们输入「te」时,由于以「te」为前缀的单词有 [“tea”,”ted”,”ted”,”ten”],则在搜索引擎的搜索提示框中就可以展示这几个字符串以供用户选择。
- frontend可以设置一个间隔周期:用户前后两个letter输入间隔超过500ms说明在思考,这时才调用queryService查询
- 一些hot query的top 10缓存在browser本地呗,每个1~2小时再调用queryService从backend得到跟新top 10
- 在鼠标失去焦点时才开始查询。
- 本地可以缓存trie树。
trie树太大,就只能存在后端,可以用前缀建立倒排索引。每个前缀都指向了一个联想词的列表。
- Key: 前缀.
- Value: 联想词list.
- Scale:
- DAU 5000w
- 词库 5000w - 10000w词条
- Performance:
- Latency: p90 300s
- QPS: 1w. Peak QPS: 5w.
- TPS : 1000
API 设计:
- 获取联想单词
- req: 输入文本
- resp: 联想词条列表
- 上报用户行为,增加词条热度
- req: 搜索的文本和点击的词条
- resp: NA
数据Model
- word_list 词条库
- 字段:
- id, 词条库id
- content, 词条内容,比如apple.
- example: id = 1001,content = apple
- 存储设计
- 需求: 通过id直接O(1)访问词条,支持MGet
- 实现:
- [Preferred] Option1: nosql,id作key, content 作value, eg HBase, TiDB. 可用Redis做缓存。
- Option2: sql, 比如mysql, id做主键。 可用Redis做缓存
- 字段:
- trie 前缀树
- 字段
- char 当前字符
- children 构成前缀的下一个字符的列表
- word_id_list 联想的词条列表,长度<=10
- 存储设计
- 需求: 根据文本得到联想的词条,至少10个。
- 实现, 路径压缩后类似倒排索引,前缀倒排表
- [Preferred] Option1: nosql,前缀作key, 其他作value, eg HBase, TiDB. 可用Redis做缓存。 按key做分片,支持大数据量
- Option2: sql, 比如mysql, 前缀作主键。 可用Redis做缓存。 需根据主键分库。
- 字段
获取联想单词API具体实现
- 逻辑: 通过调用trie 获取词条id列表,无需遍历整个trie树,然后MGet操作获取词条id的内容返回给端上。
- 场景举例, Apple联想
- 用户输入A, 通过key = ‘A’ 找到trie的前缀联想词条id 列表 (长度<=150个),然后通过根据词条id获取内容,返回给用户
- 当用户接着输入P, 通过key=’AP’ 找到trie的前缀联想词条id 列表 (长度<=150个),然后通过根据词条id获取内容,返回给用户
数据管理
- 词条管理:
- 基于用户商品自动分词、商家自动填入联想词汇、运营基于商家推流等人工添加。离线脚本定时更新词条数据以及基于搜索频率的词条热度
- 前缀树管理:
- 对新词条进行自动添加到前缀树并创建映射。
- 每个前缀树节点到词条的映射通过离线脚本,基于用户历史数据、关联性、词库热度来定时增改。
扩展
- 分布式系统,集群部署。
- 存储上,缓存、热门词条local cache。持久化存储需分片并每个分片有replica。
- 多机房,同城双活,异地多活。
Key Points:
数据规模
- Trie树可几个字符作为一个Trie节点,减少数据规模,比如Apple 前缀只保留A, App, Apple. 对于Ap的联想后退一个字符到A,从而得到数据联想到Apple.
- 历史长期不访问数据可异步统计并清理。

寻找热门搜索字符串
Trie 树除了作为前缀树来实现搜索提示词的功能外,还可以用来辅助寻找热门搜索字符串,只要对 Trie 树稍加改造即可。假设我们要寻找最热门的 10 个搜索字符串,则具体实现思路如下:
一般搜索引擎都会有专门的日志来记录用户的搜索词,我们用用户的这些搜索词来构建一颗 Trie 树,但要稍微对 Trie 树进行一下改造,上文提到,Trie 树实现的时候,可以在节点中设置一个标志,用来标记该结点处是否构成一个单词,也可以把这个标志改成以节点为终止字符的搜索字符串个数,每个搜索字符串在 Trie 树遍历,在遍历的最后一个结点上把字符串个数加 1,即可统计出每个字符串被搜索了多少次(根节点到结点经过的路径即为搜索字符串),然后我们再维护一个有 10 个节点的小顶堆(堆顶元素比所有其他元素值都小,如下图示)
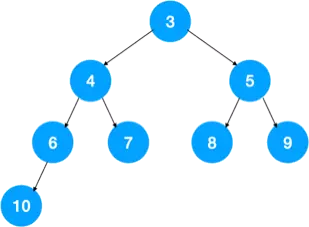
如图示:小顶堆中堆顶元素比其他任何元素都小
依次遍历 Trie 树的节点,将节点(字符串+次数)传给小顶堆,根据搜索次数不断调整小顶堆,这样遍历完 Trie 树的节点后,小顶堆里的 10 个节点即是最热门的搜索字符串。