字符串小结
type StringHeader struct {
	Data uintptr
	Len  int
}
- string不能修改
+号拼接不再具有优势,因为string是不可变的,每次拼接都会生成一个新的string,也就是会进行一次内存分配
go基础数据类型
虽然从底层而言,所有的数据都是由比特组成,但计算机一般操作的是固定大小的数,如整数、浮点数、比特数组、内存地址等。进一步将这些数组织在一起,就可表达更多的对象,例如数据包、像素点、诗歌,甚至其他任何对象。Go语言提供了丰富的数据组织形式,这依赖于Go语言内置的数据类型。这些内置的数据类型,兼顾了硬件的特性和表达复杂数据结构的便捷性。
Go语言将数据类型分为四类:基础类型、复合类型、引用类型和接口类型。本章介绍基础类型,包括:数字、字符串和布尔型。复合数据类型——数组(§4.1)和结构体(§4.2)——是通过组合简单类型,来表达更加复杂的数据结构。引用类型包括指针(§2.3.2)、切片(§4.2))字典(§4.3)、函数(§5)、通道(§8),虽然数据种类很多,但它们都是对程序中一个变量或状态的间接引用。这意味着对任一引用类型数据的修改都会影响所有该引用的拷贝。我们将在第7章介绍接口类型。
1. 整型
Go语言的数值类型包括几种不同大小的整形数、浮点数和复数。每种数值类型都决定了对应的大小范围和是否支持正负符号。让我们先从整形数类型开始介绍。
Go语言同时提供了有符号和无符号类型的整数运算。这里有int8、int16、int32和int64四种截然不同大小的有符号整形数类型,分别对应8、16、32、64bit大小的有符号整形数,与此对应的是uint8、uint16、uint32和uint64四种无符号整形数类型。
这里还有两种一般对应特定CPU平台机器字大小的有符号和无符号整数int和uint;其中int是应用最广泛的数值类型。这两种类型都有同样的大小,32或64bit,但是我们不能对此做任何的假设;因为不同的编译器即使在相同的硬件平台上可能产生不同的大小。Unicode字符rune类型是和int32等价的类型,通常用于表示一个Unicode码点。这两个名称可以互换使用。同样byte也是uint8类型的等价类型,byte类型一般用于强调数值是一个原始的数据而不是一个小的整数。
最后,还有一种无符号的整数类型uintptr,没有指定具体的bit大小但是足以容纳指针。uintptr类型只有在底层编程是才需要,特别是Go语言和C语言函数库或操作系统接口相交互的地方。
不管它们的具体大小,int、uint和uintptr是不同类型的兄弟类型。其中int和int32也是不同的类型,即使int的大小也是32bit,在需要将int当作int32类型的地方需要一个显式的类型转换操作,反之亦然。
其中有符号整数采用2的补码形式表示,也就是最高bit位用作表示符号位,一个n-bit的有符号数的值域是从
−2n − 1
到
2n − 1 − 1
。无符号整数的所有bit位都用于表示非负数,值域是0到
2n − 1
。例如,int8类型整数的值域是从-128到127,而uint8类型整数的值域是从0到255。

下面是Go语言中关于算术运算、逻辑运算和比较运算的二元运算符,它们按照先级递减的顺序的排列:

*      /      %      <<       >>     &       &^
+      -      |      ^
==     !=     <      <=       >      >=
&&
||
2. 浮点数
Go语言提供了两种精度的浮点数,float32和float64。它们的算术规范由IEEE754浮点数国际标准定义,该浮点数规范被所有现代的CPU支持。
这些浮点数类型的取值范围可以从很微小到很巨大。浮点数的范围极限值可以在math包找到。常量math.MaxFloat32表示float32能表示的最大数值,大约是 3.4e38;对应的math.MaxFloat64常量大约是1.8e308。它们分别能表示的最小值近似为1.4e-45和4.9e-324。
一个float32类型的浮点数可以提供大约6个十进制数的精度,而float64则可以提供约15个十进制数的精度;通常应该优先使用float64类型,因为float32类型的累计计算误差很容易扩散,并且float32能精确表示的正整数并不是很大(译注:因为float32的有效bit位只有23个,其它的bit位用于指数和符号;当整数大于23bit能表达的范围时,float32的表示将出现误差)
3. 复数
Go语言提供了两种精度的复数类型:complex64和complex128,分别对应float32和float64两种浮点数精度。内置的complex函数用于构建复数,内建的real和imag函数分别返回复数的实部和虚部:
var x complex128 = complex(1, 2) // 1+2i
var y complex128 = complex(3, 4) // 3+4i
fmt.Println(x*y)                 // "(-5+10i)"
fmt.Println(real(x*y))           // "-5"
fmt.Println(imag(x*y))           // "10"
4. 布尔型
一个布尔类型的值只有两种:true和false。if和for语句的条件部分都是布尔类型的值,并且==和<等比较操作也会产生布尔型的值。一元操作符!对应逻辑非操作,因此!true的值为false,更罗嗦的说法是(!true==false)==true,虽然表达方式不一样,不过我们一般会采用简洁的布尔表达式,就像用x来表示x==true。
| 布尔值可以和&&(AND)和 | (OR)操作符结合,并且可能会有短路行为:如果运算符左边值已经可以确定整个布尔表达式的值,那么运算符右边的值将不在被求值 |
5. 字符串
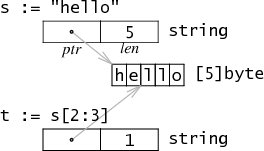
字符串在Go语言内存模型中用一个2字长的数据结构表示。它包含一个指向字符串存储数据的指针和一个长度数据。因为string类型是不可变的,对于多字符串共享同一个存储数据是安全的。切分操作str[i:j]会得到一个新的2字长结构,一个可能不同的但仍指向同一个字节序列(即上文说的存储数据)的指针和长度数据。这意味着字符串切分可以在不涉及内存分配或复制操作。这使得字符串切分的效率等同于传递下标。
(说句题外话,在Java和其他语言里有一个有名的“疑难杂症”:在你分割字符串并保存时,对于源字符串的引用在内存中仍然保存着完整的原始字符串–即使只有一小部分仍被需要,Go也有这个“毛病”。另一方面,我们努力但又失败了的是,让字符串分割操作变得昂贵–包含一次分配和一次复制。在大多数程序中都避免了这么做。)
一个字符串是一个不可改变的字节序列。字符串可以包含任意的数据,包括byte值0,但是通常是用来包含人类可读的文本。文本字符串通常被解释为采用UTF8编码的Unicode码点(rune)序列,我们稍后会详细讨论这个问题。
内置的len函数可以返回一个字符串中的字节数目(不是rune字符数目),索引操作s[i]返回第i个字节的字节值,i必须满足0 ≤ i< len(s)条件约束。
s := "hello, world"
fmt.Println(len(s))     // "12"
fmt.Println(s[0], s[7]) // "104 119" ('h' and 'w')
如果试图访问超出字符串索引范围的字节将会导致panic异常:
c := s[len(s)] // panic: index out of range
第i个字节并不一定是字符串的第i个字符,因为对于非ASCII字符的UTF8编码会要两个或多个字节。我们先简单说下字符的工作方式。
子字符串操作s[i:j]基于原始的s字符串的第i个字节开始到第j个字节(并不包含j本身)生成一个新字符串。生成的新字符串将包含j-i个字节。
fmt.Println(s[0:5]) // "hello"
同样,如果索引超出字符串范围或者j小于i的话将导致panic异常。
字符串是不可修改的,因此尝试修改字符串内部数据的操作也是被禁止的:
s[0] = 'L' // compile error: cannot assign to s[0]
不变性意味如果两个字符串共享相同的底层数据的话也是安全的,这使得复制任何长度的字符串代价是低廉的。同样,一个字符串s和对应的子字符串切片s[7:]的操作也可以安全地共享相同的内存,因此字符串切片操作代价也是低廉的。在这两种情况下都没有必要分配新的内存。 图3.4演示了一个字符串和两个子串共享相同的底层数据。
原生字符串面值用于编写正则表达式会很方便,因为正则表达式往往会包含很多反斜杠。原生字符串面值同时被广泛应用于HTML模板、JSON面值、命令行提示信息以及那些需要扩展到多行的场景。
const GoUsage = `Go is a tool for managing Go source code.

Usage:
    go command [arguments]
...`
UTF-8
UTF8是一个将Unicode码点编码为字节序列的变长编码。UTF8编码由Go语言之父Ken Thompson和Rob Pike共同发明的,现在已经是Unicode的标准。UTF8编码使用1到4个字节来表示每个Unicode码点,ASCII部分字符只使用1个字节,常用字符部分使用2或3个字节表示。每个符号编码后第一个字节的高端bit位用于表示总共有多少编码个字节。如果第一个字节的高端bit为0,则表示对应7bit的ASCII字符,ASCII字符每个字符依然是一个字节,和传统的ASCII编码兼容。如果第一个字节的高端bit是110,则说明需要2个字节;后续的每个高端bit都以10开头。更大的Unicode码点也是采用类似的策略处理。
0xxxxxxx                             runes 0-127    (ASCII)
110xxxxx 10xxxxxx                    128-2047       (values <128 unused)
1110xxxx 10xxxxxx 10xxxxxx           2048-65535     (values <2048 unused)
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx  65536-0x10ffff (other values unused)
变长的编码无法直接通过索引来访问第n个字符,但是UTF8编码获得了很多额外的优点。首先UTF8编码比较紧凑,完全兼容ASCII码,并且可以自动同步:它可以通过向前回朔最多2个字节就能确定当前字符编码的开始字节的位置。它也是一个前缀编码,所以当从左向右解码时不会有任何歧义也并不需要向前查看(译注:像GBK之类的编码,如果不知道起点位置则可能会出现歧义)。没有任何字符的编码是其它字符编码的子串,或是其它编码序列的子串,因此搜索一个字符时只要搜索它的字节编码序列即可,不用担心前后的上下文会对搜索结果产生干扰。同时UTF8编码的顺序和Unicode码点的顺序一致,因此可以直接排序UTF8编码序列。同时因为没有嵌入的NUL(0)字节,可以很好地兼容那些使用NUL作为字符串结尾的编程语言。
Go语言的源文件采用UTF8编码,并且Go语言处理UTF8编码的文本也很出色。unicode包提供了诸多处理rune字符相关功能的函数(比如区分字母和数组,或者是字母的大写和小写转换等),unicode/utf8包则提供了用于rune字符序列的UTF8编码和解码的功能。
字符串和Byte切片
标准库中有四个包对字符串处理尤为重要:bytes、strings、strconv和unicode包。strings包提供了许多如字符串的查询、替换、比较、截断、拆分和合并等功能。
bytes包也提供了很多类似功能的函数,但是针对和字符串有着相同结构的[]byte类型。因为字符串是只读的,因此逐步构建字符串会导致很多分配和复制。在这种情况下,使用bytes.Buffer类型将会更有效,稍后我们将展示。
strconv包提供了布尔型、整型数、浮点数和对应字符串的相互转换,还提供了双引号转义相关的转换。
unicode包提供了IsDigit、IsLetter、IsUpper和IsLower等类似功能,它们用于给字符分类。每个函数有一个单一的rune类型的参数,然后返回一个布尔值。而像ToUpper和ToLower之类的转换函数将用于rune字符的大小写转换。所有的这些函数都是遵循Unicode标准定义的字母、数字等分类规范。strings包也有类似的函数,它们是ToUpper和ToLower,将原始字符串的每个字符都做相应的转换,然后返回新的字符串。
字符串和数字的转换
除了字符串、字符、字节之间的转换,字符串和数值之间的转换也比较常见。由strconv包提供这类转换功能。
将一个整数转为字符串,一种方法是用fmt.Sprintf返回一个格式化的字符串;另一个方法是用strconv.Itoa(“整数到ASCII”):

x := 123
y := fmt.Sprintf("%d", x)
fmt.Println(y, strconv.Itoa(x)) // "123 123"
FormatInt和FormatUint函数可以用不同的进制来格式化数字:

fmt.Println(strconv.FormatInt(int64(x), 2)) // "1111011"
6.常量
常量表达式的值在编译期计算,而不是在运行期。每种常量的潜在类型都是基础类型:boolean、string或数字。
一个常量的声明语句定义了常量的名字,和变量的声明语法类似,常量的值不可修改,这样可以防止在运行期被意外或恶意的修改。例如,常量比变量更适合用于表达像π之类的数学常数,因为它们的值不会发生变化:
const pi = 3.14159 // approximately; math.Pi is a better approximation
和变量声明一样,可以批量声明多个常量;这比较适合声明一组相关的常量:
const (
    e  = 2.71828182845904523536028747135266249775724709369995957496696763
    pi = 3.14159265358979323846264338327950288419716939937510582097494459
)
所有常量的运算都可以在编译期完成,这样可以减少运行时的工作,也方便其他编译优化。当操作数是常量时,一些运行时的错误也可以在编译时被发现,例如整数除零、字符串索引越界、任何导致无效浮点数的操作等。
常量间的所有算术运算、逻辑运算和比较运算的结果也是常量,对常量的类型转换操作或以下函数调用都是返回常量结果:len、cap、real、imag、complex和unsafe.Sizeof(§13.1)。
因为它们的值是在编译期就确定的,因此常量可以是构成类型的一部分,例如用于指定数组类型的长度:
const IPv4Len = 4

// parseIPv4 parses an IPv4 address (d.d.d.d).
func parseIPv4(s string) IP {
    var p [IPv4Len]byte
    // ...
}
一个常量的声明也可以包含一个类型和一个值,但是如果没有显式指明类型,那么将从右边的表达式推断类型。在下面的代码中,time.Duration是一个命名类型,底层类型是int64,time.Minute是对应类型的常量。下面声明的两个常量都是time.Duration类型,可以通过%T参数打印类型信息:
const noDelay time.Duration = 0
const timeout = 5 * time.Minute
fmt.Printf("%T %[1]v\n", noDelay)     // "time.Duration 0"
fmt.Printf("%T %[1]v\n", timeout)     // "time.Duration 5m0s"
fmt.Printf("%T %[1]v\n", time.Minute) // "time.Duration 1m0s"
iota 常量生成器
常量声明可以使用iota常量生成器初始化,它用于生成一组以相似规则初始化的常量,但是不用每行都写一遍初始化表达式。在一个const声明语句中,在第一个声明的常量所在的行,iota将会被置为0,然后在每一个有常量声明的行加一。
下面是来自time包的例子,它首先定义了一个Weekday命名类型,然后为一周的每天定义了一个常量,从周日0开始。在其它编程语言中,这种类型一般被称为枚举类型。
无类型常量
Go语言的常量有个不同寻常之处。虽然一个常量可以有任意有一个确定的基础类型,例如int或float64,或者是类似time.Duration这样命名的基础类型,但是许多常量并没有一个明确的基础类型。编译器为这些没有明确的基础类型的数字常量提供比基础类型更高精度的算术运算;你可以认为至少有256bit的运算精度。这里有六种未明确类型的常量类型,分别是无类型的布尔型、无类型的整数、无类型的字符、无类型的浮点数、无类型的复数、无类型的字符串。
通过延迟明确常量的具体类型,无类型的常量不仅可以提供更高的运算精度,而且可以直接用于更多的表达式而不需要显式的类型转换。例如,例子中的ZiB和YiB的值已经超出任何Go语言中整数类型能表达的范围,但是它们依然是合法的常量,而且可以像下面常量表达式依然有效(译注:YiB/ZiB是在编译期计算出来的,并且结果常量是1024,是Go语言int变量能有效表示的):
fmt.Println(YiB/ZiB) // "1024"
另一个例子,math.Pi无类型的浮点数常量,可以直接用于任意需要浮点数或复数的地方:
var x float32 = math.Pi
var y float64 = math.Pi
var z complex128 = math.Pi
如果math.Pi被确定为特定类型,比如float64,那么结果精度可能会不一样,同时对于需要float32或complex128类型值的地方则会强制需要一个明确的类型转换:
const Pi64 float64 = math.Pi

var x float32 = float32(Pi64)
var y float64 = Pi64
var z complex128 = complex128(Pi64)