一、I/O 模型
一个输入操作通常包括两个阶段:
- 等待数据准备好
- 从内核向进程复制数据
对于一个套接字上的输入操作,第一步通常涉及等待数据从网络中到达。当所等待分组到达时,它被复制到内核中的某个缓冲区。第二步就是把数据从内核缓冲区复制到应用进程缓冲区。
Unix 下有五种 I/O 模型:
- 阻塞式 I/O
- 非阻塞式 I/O
- I/O 复用(select 和 poll)
- 信号驱动式 I/O(SIGIO)
- 异步 I/O(AIO)
阻塞式 I/O
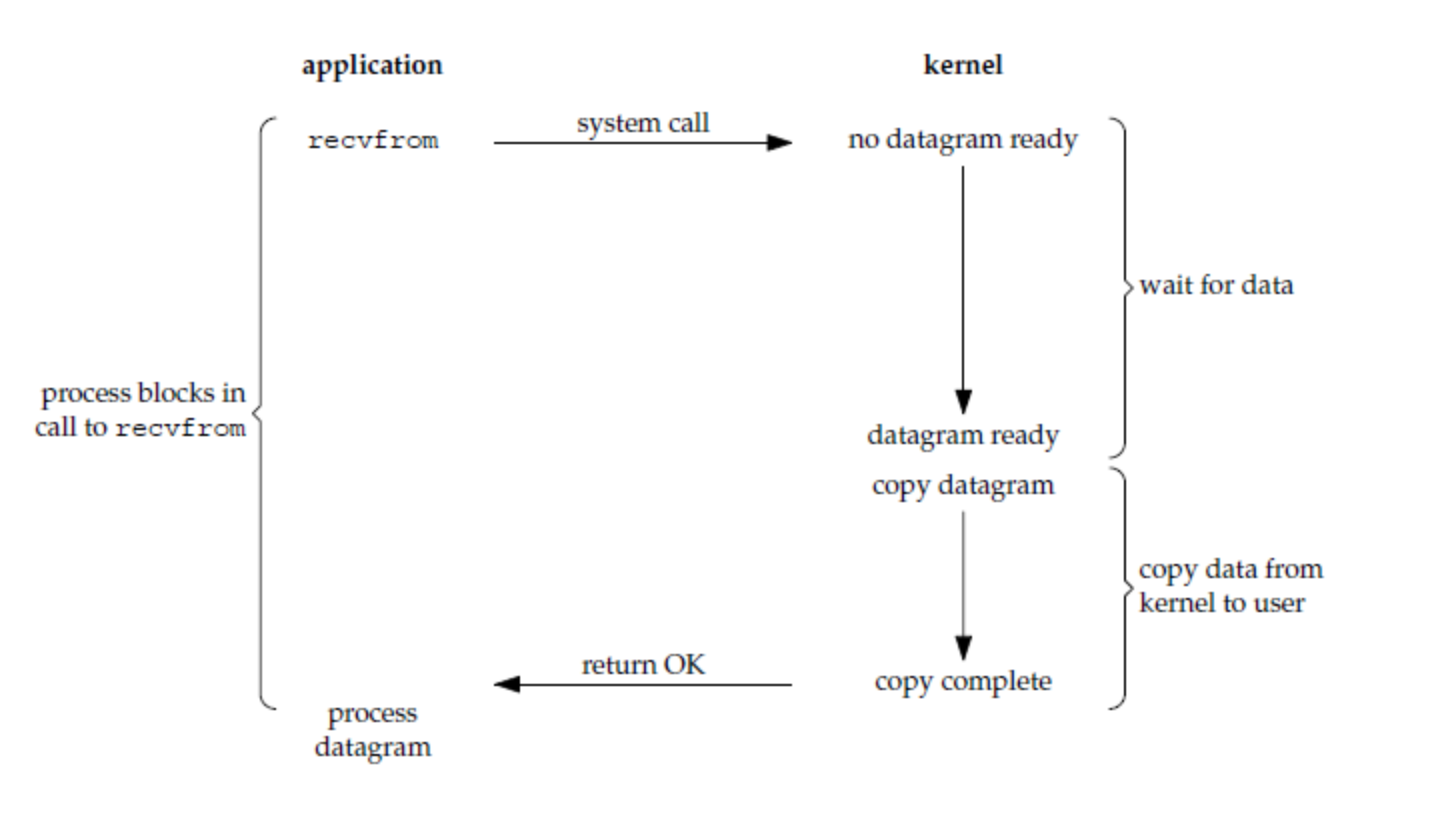
应用进程被阻塞,直到数据复制到应用进程缓冲区中才返回。
应该注意到,在阻塞的过程中,其它程序还可以执行,因此阻塞不意味着整个操作系统都被阻塞。因为其他程序还可以执行,因此不消耗 CPU 时间,这种模型的执行效率会比较高。
下图中,recvfrom 用于接收 Socket 传来的数据,并复制到应用进程的缓冲区 buf 中。这里把 recvfrom() 当成系统调用。
ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr *src_addr, socklen_t *addrlen);
非阻塞式 I/O
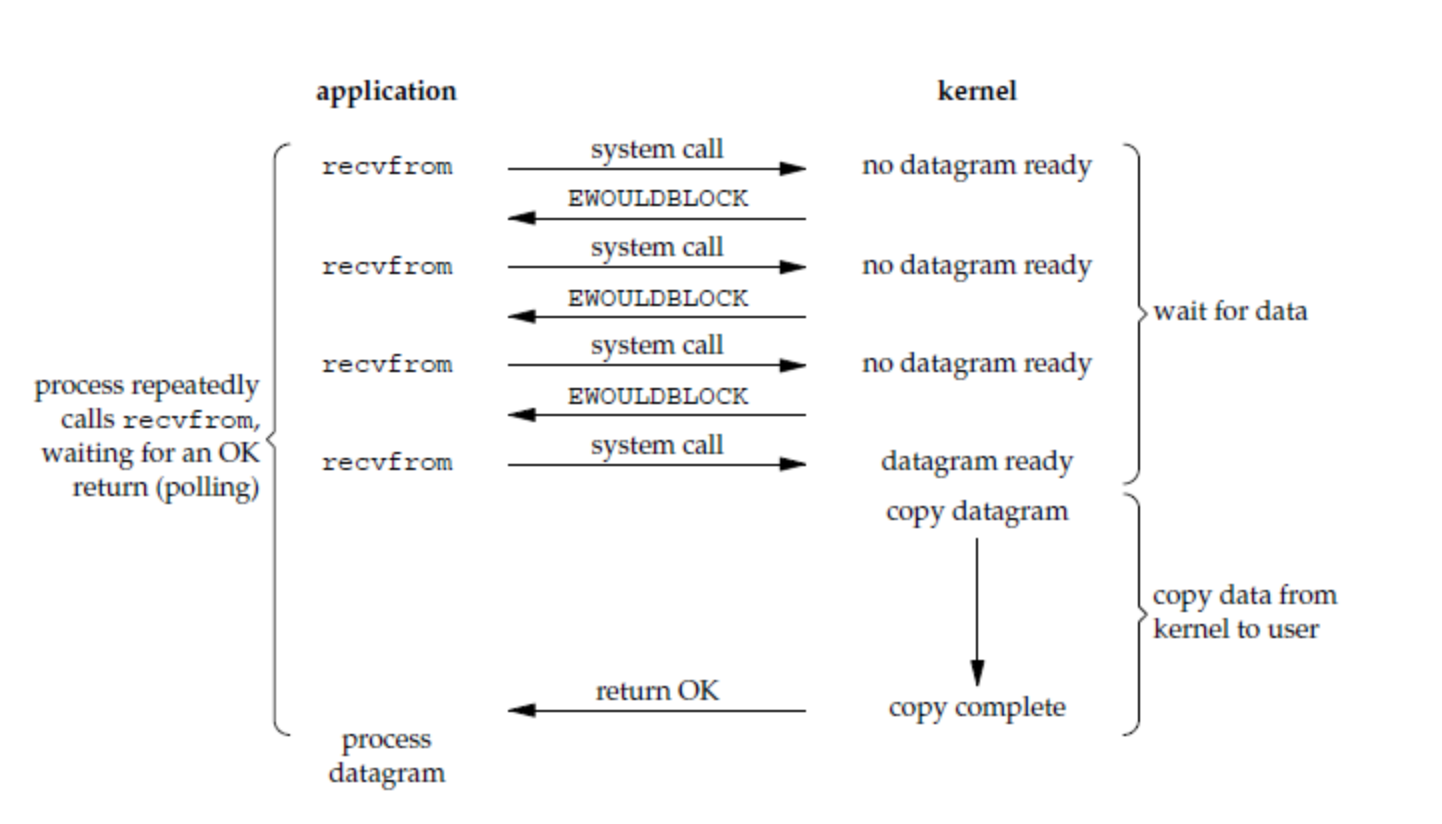
应用进程执行系统调用之后,内核返回一个错误码。应用进程可以继续执行,但是需要不断的执行系统调用来获知 I/O 是否完成,这种方式称为轮询(polling)。
由于 CPU 要处理更多的系统调用,因此这种模型是比较低效的。
I/O 复用
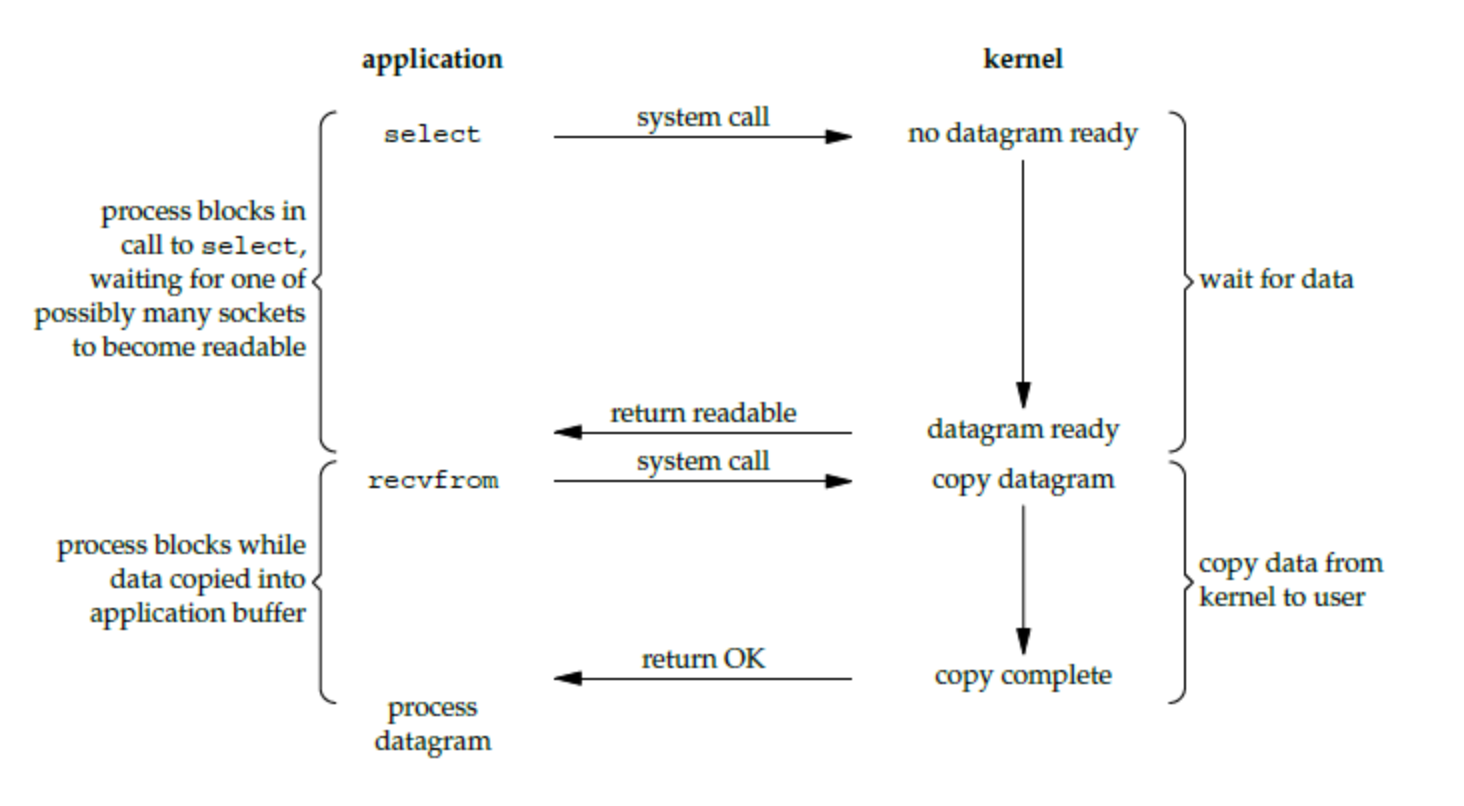
使用 select 或者 poll 等待数据,并且可以等待多个套接字中的任何一个变为可读,这一过程会被阻塞,当某一个套接字可读时返回。之后再使用 recvfrom 把数据从内核复制到进程中。
它可以让单个进程具有处理多个 I/O 事件的能力。又被称为 Event Driven I/O,即事件驱动 I/O。
如果一个 Web 服务器没有 I/O 复用,那么每一个 Socket 连接都需要创建一个线程去处理。如果同时有几万个连接,那么就需要创建相同数量的线程。并且相比于多进程和多线程技术,I/O 复用不需要进程线程创建和切换的开销,系统开销更小。
信号驱动 I/O
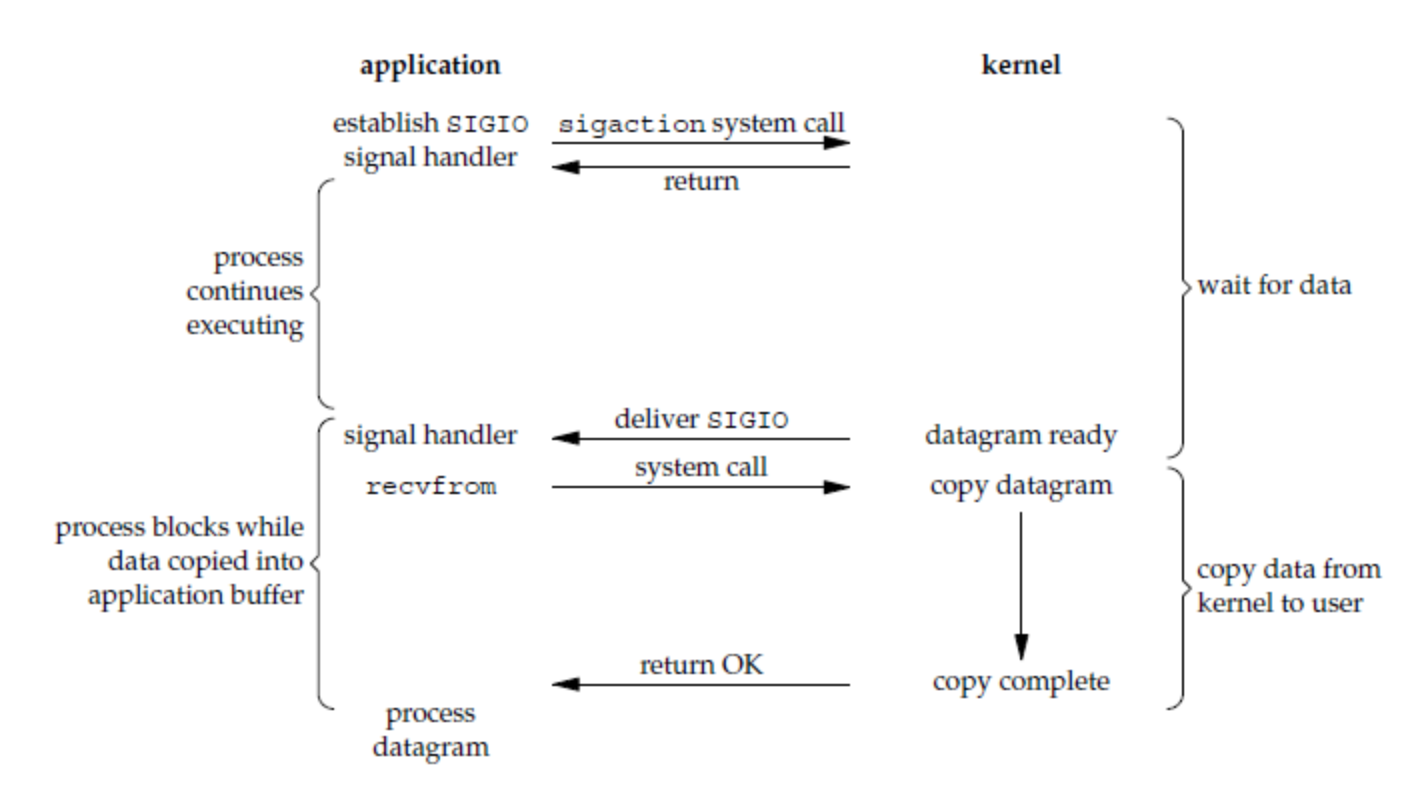
应用进程使用 sigaction 系统调用,内核立即返回,应用进程可以继续执行,也就是说等待数据阶段应用进程是非阻塞的。内核在数据到达时向应用进程发送 SIGIO 信号,应用进程收到之后在信号处理程序中调用 recvfrom 将数据从内核复制到应用进程中。
相比于非阻塞式 I/O 的轮询方式,信号驱动 I/O 的 CPU 利用率更高。
异步 I/O
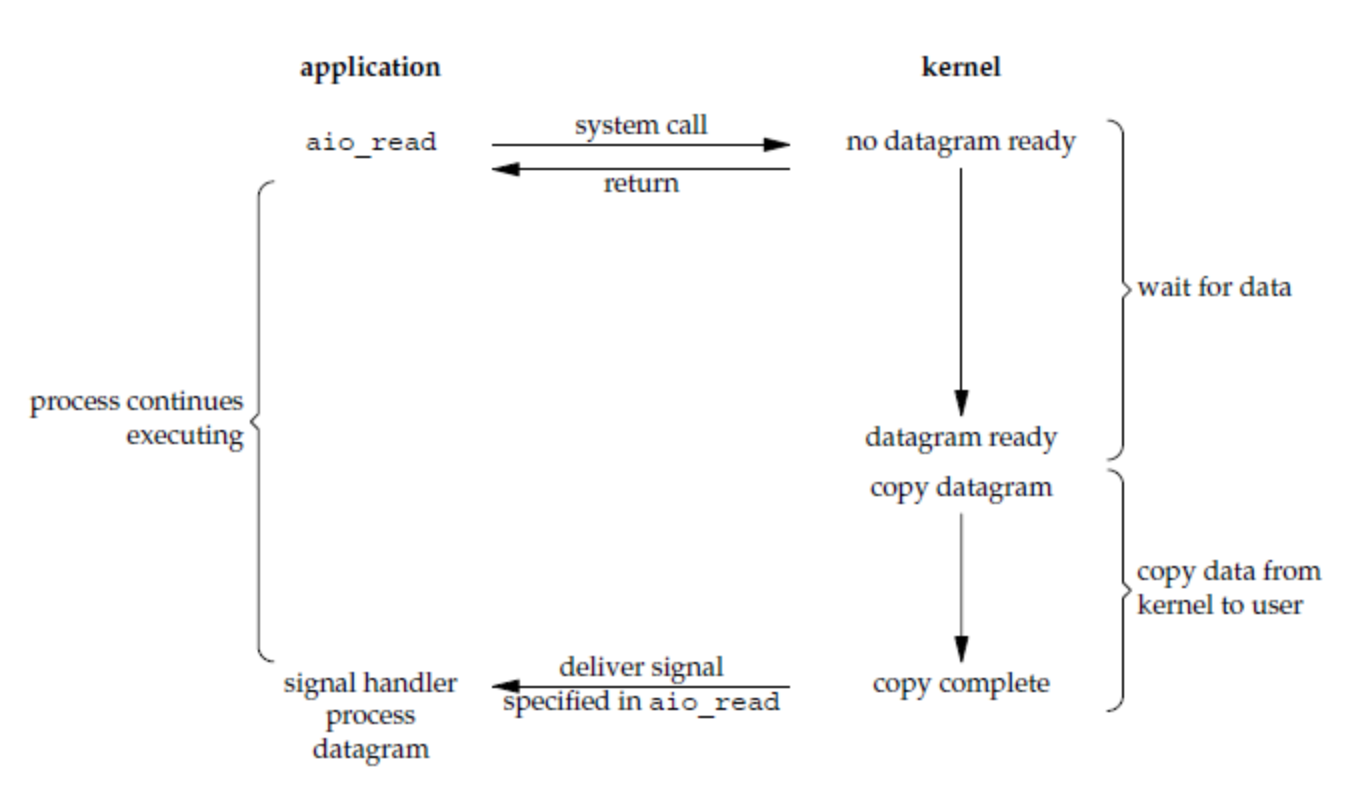
进行 aio_read 系统调用会立即返回,应用进程继续执行,不会被阻塞,内核会在所有操作完成之后向应用进程发送信号。
异步 I/O 与信号驱动 I/O 的区别在于,异步 I/O 的信号是通知应用进程 I/O 完成,而信号驱动 I/O 的信号是通知应用进程可以开始 I/O。
同步 I/O 与异步 I/O
- 同步 I/O:应用进程在调用 recvfrom 操作时会阻塞。
- 异步 I/O:不会阻塞。
阻塞式 I/O、非阻塞式 I/O、I/O 复用和信号驱动 I/O 都是同步 I/O,虽然非阻塞式 I/O 和信号驱动 I/O 在等待数据阶段不会阻塞,但是在之后的将数据从内核复制到应用进程这个操作会阻塞。
五大 I/O 模型比较
前四种 I/O 模型的主要区别在于第一个阶段,而第二个阶段是一样的:将数据从内核复制到应用进程过程中,应用进程会被阻塞。

二、I/O 复用
select/poll/epoll 都是 I/O 多路复用的具体实现,select 出现的最早,之后是 poll,再是 epoll。
总结
IO 多路复用是一种高效管理多个 IO 事件的技术,通过单线程监控多个文件描述符(fd),实现高并发的 IO 操作。
常见的 I/O 多路复用机制包括 select、poll 和 epoll 等。
| 特性 | select | poll | epoll |
|---|---|---|---|
| 文件描述符限制 | 受 FD_SETSIZE 限制 | 无限制 | 无限制 |
| 时间复杂度 | O(n) | O(n) | O(1) |
| 数据复制 | 需要 | 需要 | 不需要 |
| 工作方式 | 线性扫描 | 线性扫描 | 事件通知 |
| 内核支持 | 所有 UNIX 系统 | 所有 UNIX 系统 | Linux 2.6 及以上版本 |
| 适用场景 | 少量连接 | 中等连接 | 大量并发连接 |
select 使用位图管理 fd,每次调用都需要将 fd 集合从用户态复制到内核态。最大支持 1024 个文件描述符。
poll 使用动态数组管理 fd,链表形式,突破了 select 的数量限制。
epoll 使用红黑树和链表管理 fd,每次调用只需要将 fd 集合从用户态复制到内核态一次,不需要重复复制。
select
int select(int n, fd_set *readfds, fd_set *writefds, fd_set *exceptfds, struct timeval *timeout);


// 使用方法:

// Call the select
int ret = select( largest_sock + 1, &fd_in, &fd_out, NULL, &tv );

// Check if select actually succeed
if ( ret == -1 )
    // report error and abort
else if ( ret == 0 )
    // timeout; no event detected
else
{
    if ( FD_ISSET( sock1, &fd_in ) )
        // input event on sock1

    if ( FD_ISSET( sock2, &fd_out ) )
        // output event on sock2
}
将已连接的 Socket 都放到⼀个⽂件描述符集合fd_set,然后调⽤ select 函数将 fd_set 集合拷⻉到内核⾥,让内核来检查是否有⽹络事件产⽣,检查的⽅式很粗暴,就是通过遍历 fd_set 的⽅式,当检查到有事件产⽣后,将此 Socket 标记为可读或可写, 接着再把整个 fd_set 拷⻉回⽤户态⾥,然后⽤户态还需要再通过遍历的⽅法找到可读或可写的 Socket,再对其处理。
select 使⽤固定⻓度的 BitsMap,表示⽂件描述符集合,⽽且所⽀持的⽂件描述符的个数是有限制的,在 Linux 系统中,由内核中的 FD_SETSIZE 限制, 默认最⼤值为 1024 ,只能监听 0~1023 的⽂件描述符。
select 机制的缺点:
(1)每次调用 select,都需要把 fd_set 集合从用户态拷贝到内核态,如果 fd_set 集合很大时,那这个开销也很大,比如百万连接却只有少数活跃连接时这样做就太没有效率。
(2)每次调用 select 都需要在内核遍历传递进来的所有 fd_set,如果 fd_set 集合很大时,那这个开销也很大。
(3)为了减少数据拷贝带来的性能损坏,内核对被监控的 fd_set 集合大小做了限制,一般为 1024,如果想要修改会比较麻烦,可能还需要编译内核。
(4)每次调用 select 之前都需要遍历设置监听集合,重复工作。
poll
poll 不再⽤ BitsMap 来存储所关注的⽂件描述符,取⽽代之⽤动态数组,以链表形式来组织,突破了 select 的⽂件描述符个数限制,当然还会受到系统⽂件描述符限制。
但是 poll 和 select 并没有太⼤的本质区别,都是使⽤线性结构存储进程关注的 Socket 集合,因此都需要遍历⽂件描述符集合来找到可读或可写的 Socke,时间复杂度为 O(n),⽽且也需要在⽤户态与内核态之间拷⻉⽂件描述符集合,这种⽅式随着并发数上来,性能的损耗会呈指数级增⻓。
epoll
int epoll_create(int size);
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);
int epoll_wait(int epfd, struct epoll_event * events, int maxevents, int timeout);
epoll_ctl() 用于向内核注册新的描述符或者是改变某个文件描述符的状态。已注册的描述符在内核中会被维护在一棵红黑树上,通过回调函数内核会将 I/O 准备好的描述符加入到一个链表中管理,进程调用 epoll_wait() 便可以得到事件完成的描述符。
从上面的描述可以看出,epoll 只需要将描述符从进程缓冲区向内核缓冲区拷贝一次,并且进程不需要通过轮询来获得事件完成的描述符。不像select epoll只有一个函数。
epoll 通过两个⽅⾯,很好解决了 select/poll 的问题。
第⼀点,epoll 在内核⾥使⽤红⿊树来跟踪进程所有待检测的⽂件描述字,把需要监控的 socket 通过 epoll_ctl() 函数加⼊内核中的红⿊树⾥,红⿊树是个⾼效的数据结构,增删查⼀般时间复杂度是 O(logn) ,通过对这棵⿊红树进⾏操作,这样就不需要像 select/poll 每次操作时都传⼊整个 socket 集合,只需要传⼊⼀个待检测的 socket,减少了内核和⽤户空间⼤量的数据拷⻉和内存分配。
第⼆点, epoll 使⽤事件驱动的机制,内核⾥维护了⼀个链表来记录就绪事件,当某个 socket 有事件发⽣时,通过回调函数,内核会将其加⼊到这个就绪事件列表中,当⽤户调⽤ epoll_wait() 函数时,只会返回有事件发⽣的⽂件描述符的个数,不需要像 select/poll 那样轮询扫描整个 socket 集合,⼤⼤提⾼了检测的效率。

epoll 的⽅式即使监听的 Socket 数量越多的时候,效率不会⼤幅度降低,能够同时监听的 Socket 的数⽬也⾮常的多了,上限就为系统定义的进程打开的最⼤⽂件描述符个数。因⽽,epoll 被称为解决 C10K 问题的利器。
epoll 仅适用于 Linux OS。
epoll 比 select 和 poll 更加灵活而且没有描述符数量限制。
epoll 对多线程编程更有友好,一个线程调用了 epoll_wait() 另一个线程关闭了同一个描述符也不会产生像 select 和 poll 的不确定情况。
工作模式
epoll 的描述符事件有两种触发模式:LT(level trigger)和 ET(edge trigger)。
1. LT 模式(水平触发)
当 epoll_wait() 检测到描述符事件到达时,将此事件通知进程,进程可以不立即处理该事件,下次调用 epoll_wait() 会再次通知进程。是默认的一种模式,并且同时支持 Blocking 和 No-Blocking。
以单线程速度见长的Redis使用的是水平触发.
2. ET 模式(边缘触发)
和 LT 模式不同的是,通知之后进程必须立即处理事件,下次再调用 epoll_wait() 时不会再得到事件到达的通知。
很大程度上减少了 epoll 事件被重复触发的次数,因此效率要比 LT 模式高。只支持 No-Blocking,以避免由于一个文件句柄的阻塞读/阻塞写操作把处理多个文件描述符的任务饿死。
- LT 模式下,读事件触发后,可以按需收取想要的字节数,不用把本次接收到的数据收取干净(即不用循环到 recv 或者 read 函数返回 -1,错误码为 EWOULDBLOCK 或 EAGAIN);ET 模式下,读事件必须把数据收取干净,因为你不一定有下一次机会再收取数据了,即使有机会,也可能存在上次没读完的数据没有及时处理,造成客户端响应延迟。
- LT 模式下,不需要写事件一定要及时移除,避免不必要的触发,浪费 CPU 资源;ET 模式下,写事件触发后,如果还需要下一次的写事件触发来驱动任务(例如发上次剩余的数据),你需要继续注册一次检测可写事件。
- LT 模式和 ET 模式各有优缺点,无所谓孰优孰劣。使用 LT 模式,我们可以自由决定每次收取多少字节(对于普通 socket)或何时接收连接(对于侦听 socket),但是可能会导致多次触发;使用 ET 模式,我们必须每次都要将数据收完(对于普通 socket)或必须理解调用 accept 接收连接(对于侦听socket),其优点是触发次数少。
LT和ET对比。
- 采用水平触发(LT),则需要同步的在事件触发后主动完成 I/O,并向上层代码直接提供 buffer。
- 采用边沿触发(ET),可选择只管理事件通知(如 go net 设计),由上层代码完成 I/O 并管理 buffer。
LT需要主动IO,也是最常用的。两种方式各有优缺,netpoll 采用前者策略,水平触发时效性更好,容错率高,主动 I/O 可以集中内存使用和管理,提供 nocopy 操作并减少 GC。事实上一些热门开源网络库也是采用方式一的设计,如 easygo、evio、gnet 等。
应用场景
很容易产生一种错觉认为只要用 epoll 就可以了,select 和 poll 都已经过时了,其实它们都有各自的使用场景。
1. select 应用场景
select 的 timeout 参数精度为 1ns,而 poll 和 epoll 为 1ms,因此 select 更加适用于实时要求更高的场景,比如核反应堆的控制。
select 可移植性更好,几乎被所有主流平台所支持。
2. poll 应用场景
poll 没有最大描述符数量的限制,如果平台支持并且对实时性要求不高,应该使用 poll 而不是 select。
需要同时监控小于 1000 个描述符,就没有必要使用 epoll,因为这个应用场景下并不能体现 epoll 的优势。
需要监控的描述符状态变化多,而且都是非常短暂的,也没有必要使用 epoll。因为 epoll 中的所有描述符都存储在内核中,造成每次需要对描述符的状态改变都需要通过 epoll_ctl() 进行系统调用,频繁系统调用降低效率。并且epoll 的描述符存储在内核,不容易调试。
3. epoll 应用场景
只需要运行在 Linux 平台上,并且有非常大量的描述符需要同时轮询,而且这些连接最好是长连接。
参考资料
- Stevens W R, Fenner B, Rudoff A M. UNIX network programming[M]. Addison-Wesley Professional, 2004.
- Boost application performance using asynchronous I/O
- Synchronous and Asynchronous I/O
- Linux IO 模式及 select、poll、epoll 详解
- poll vs select vs event-based
- select / poll / epoll: practical difference for system architects
- Browse the source code of userspace/glibc/sysdeps/unix/sysv/linux/ online