概述
Redis 是速度非常快的非关系型(NoSQL)内存键值数据库,可以存储键和五种不同类型的值之间的映射。
键的类型只能为字符串,值支持五种数据类型:字符串、列表、集合、散列表、有序集合。
Redis 支持很多特性,例如将内存中的数据持久化到硬盘中,使用复制来扩展读性能,使用分片来扩展写性能。
数据类型
- 5 种基础数据类型:String(字符串)、List(列表)、Set(集合)、Hash(散列)、Zset(有序集合)。
- 3 种特殊数据类型:HyperLogLog(基数统计)、Bitmap (位图)、Geospatial (地理位置)。
除了上面提到的之外,还有一些其他的比如 Bloom filter(布隆过滤器)、Bitfield(位域)
Geospatial index(地理空间索引,简称 GEO) 主要用于存储地理位置信息,基于 Sorted Set 实现。通过 GEO 我们可以轻松实现两个位置距离的计算、获取指定位置附近的元素等功能。
| 数据类型 | 可以存储的值 | 操作 |
|---|---|---|
| STRING | 字符串、整数或者浮点数 | 对整个字符串或者字符串的其中一部分执行操作,对整数和浮点数执行自增或者自减操作 |
| LIST | 列表 | 从两端压入或者弹出元素 , 对单个或者多个元素进行修剪,, 只保留一个范围内的元素 |
| SET | 无序集合 | 添加、获取、移除单个元素, 检查一个元素是否存在于集合中, 计算交集、并集、差集, 从集合里面随机获取元素 |
| HASH | 包含键值对的无序散列表 | 添加、获取、移除单个键值对, 获取所有键值对, 检查某个键是否存在 |
| ZSET | 有序集合 | 添加、获取、删除元素, 根据分值范围或者成员来获取元素, 计算一个键的排名 |
STRING
> set hello world
OK
> get hello
"world"
> del hello
(integer) 1
> get hello
(nil)
LIST
> rpush list-key item
(integer) 1
> rpush list-key item2
(integer) 2
> rpush list-key item
(integer) 3

> lrange list-key 0 -1
1) "item"
2) "item2"
3) "item"

> lindex list-key 1
"item2"

> lpop list-key
"item"

> lrange list-key 0 -1
1) "item2"
2) "item"
SET
> sadd set-key item
(integer) 1
> sadd set-key item2
(integer) 1
> sadd set-key item3
(integer) 1
> sadd set-key item
(integer) 0

> smembers set-key
1) "item"
2) "item2"
3) "item3"

> sismember set-key item4
(integer) 0
> sismember set-key item
(integer) 1

> srem set-key item2
(integer) 1
> srem set-key item2
(integer) 0

> smembers set-key
1) "item"
2) "item3"
HASH
> hset hash-key sub-key1 value1
(integer) 1
> hset hash-key sub-key2 value2
(integer) 1
> hset hash-key sub-key1 value1
(integer) 0

> hgetall hash-key
1) "sub-key1"
2) "value1"
3) "sub-key2"
4) "value2"

> hdel hash-key sub-key2
(integer) 1
> hdel hash-key sub-key2
(integer) 0

> hget hash-key sub-key1
"value1"

> hgetall hash-key
1) "sub-key1"
2) "value1"
ZSET
> zadd zset-key 728 member1
(integer) 1
> zadd zset-key 982 member0
(integer) 1
> zadd zset-key 982 member0
(integer) 0

> zrange zset-key 0 -1 withscores
1) "member1"
2) "728"
3) "member0"
4) "982"

> zrangebyscore zset-key 0 800 withscores
1) "member1"
2) "728"

> zrem zset-key member1
(integer) 1
> zrem zset-key member1
(integer) 0

> zrange zset-key 0 -1 withscores
1) "member0"
2) "982"
数据结构
string
Redis 的 String 在内部结构实现上类似于 Java 的 ArrayList,采用预分配冗余空间的方式来减少内存的频繁分配。如上图所示,当前字符串实际分配的空间为 capacity,一般高于实际的字符串长度 len。当字符串长度小于 1M 时,扩容是对现有空间的成倍增长;如果长度超过 1M 时,扩容一次只会多增加 1M 的空间。最大长度为 512M。
Redis 是通过 C 语言实现的,但 Redis 并没有直接使用 C 语言的字符串,而是自己实现了一种叫做动态字符串 SDS 的类型。类似java的一个arrayList。 是可修改的字符串。额外存了长度。
struct sdshdr {
    int len; // buf 中已使用的长度
    int free; // buf 中未使用的长度
    char buf[]; // 数据空间
};
hashtable
dictht 是一个散列表结构,使用拉链法解决哈希冲突。
Redis 的字典 dict 中包含两个哈希表 dictht,这是为了方便进行 rehash 操作。在扩容时,将其中一个 dictht 上的键值对 rehash 到另一个 dictht 上面,完成之后释放空间并交换两个 dictht 的角色。
rehash 操作不是一次性完成,而是采用渐进方式,这是为了避免一次性执行过多的 rehash 操作给服务器带来过大的负担。
渐进式 rehash 通过记录 dict 的 rehashidx 完成,它从 0 开始,然后每执行一次 rehash 都会递增。例如在一次 rehash 中,要把 dict[0] rehash 到 dict[1],这一次会把 dict[0] 上 table[rehashidx] 的键值对 rehash 到 dict[1] 上,dict[0] 的 table[rehashidx] 指向 null,并令 rehashidx++。
在 rehash 期间,每次对字典执行添加、删除、查找或者更新操作时,都会执行一次渐进式 rehash。
采用渐进式 rehash 会导致字典中的数据分散在两个 dictht 上,因此对字典的查找操作也需要到对应的 dictht 去执行。
/* Performs N steps of incremental rehashing. Returns 1 if there are still
 * keys to move from the old to the new hash table, otherwise 0 is returned.
 *
 * Note that a rehashing step consists in moving a bucket (that may have more
 * than one key as we use chaining) from the old to the new hash table, however
 * since part of the hash table may be composed of empty spaces, it is not
 * guaranteed that this function will rehash even a single bucket, since it
 * will visit at max N*10 empty buckets in total, otherwise the amount of
 * work it does would be unbound and the function may block for a long time. */
int dictRehash(dict *d, int n) {
    int empty_visits = n * 10; /* Max number of empty buckets to visit. */
    if (!dictIsRehashing(d)) return 0;

    while (n-- && d->ht[0].used != 0) {
        dictEntry *de, *nextde;

        /* Note that rehashidx can't overflow as we are sure there are more
         * elements because ht[0].used != 0 */
        assert(d->ht[0].size > (unsigned long) d->rehashidx);
        while (d->ht[0].table[d->rehashidx] == NULL) {
            d->rehashidx++;
            if (--empty_visits == 0) return 1;
        }
        de = d->ht[0].table[d->rehashidx];
        /* Move all the keys in this bucket from the old to the new hash HT */
        while (de) {
            uint64_t h;

            nextde = de->next;
            /* Get the index in the new hash table */
            h = dictHashKey(d, de->key) & d->ht[1].sizemask;
            de->next = d->ht[1].table[h];
            d->ht[1].table[h] = de;
            d->ht[0].used--;
            d->ht[1].used++;
            de = nextde;
        }
        d->ht[0].table[d->rehashidx] = NULL;
        d->rehashidx++;
    }

    /* Check if we already rehashed the whole table... */
    if (d->ht[0].used == 0) {
        zfree(d->ht[0].table);
        d->ht[0] = d->ht[1];
        _dictReset(&d->ht[1]);
        d->rehashidx = -1;
        return 0;
    }

    /* More to rehash... */
    return 1;
}
Ziplist
参考https://www.jianshu.com/p/fc9d65b5bb9a
实际上就是Redis的ziplist是用一段连续的内存来存储列表数据的一个数据结构 当hashMap以及list数据量少于512时,使用ziplist节省内存。
每个Item是变长的
ziplist每个压缩列表节点都由 previous_entry_length 、 encoding 、 content 三个部分组成, 如
节点的 previous_entry_length 属性以字节为单位, 记录了压缩列表中前一个节点的长度。
节点的 encoding 属性记录了节点的 content 属性所保存数据的类型以及长度:
节点的 content 属性负责保存节点的值, 节点值可以是一个字节数组或者整数, 值的类型和长度由节点的 encoding 属性决定。 关于压缩列表的总结:
压缩列表是一种为节约内存而开发的顺序型数据结构。
压缩列表被用作列表键和哈希键的底层实现之一。
压缩列表可以包含多个节点,每个节点可以保存一个字节数组或者整数值。
添加新节点到压缩列表, 或者从压缩列表中删除节点, 可能会引发连锁更新操作, 但这种操作出现的几率并不高。
skiplist跳跃表
是有序集合的底层实现之一。
跳跃表是基于多指针有序链表实现的,可以看成多个有序链表。
在查找时,从上层指针开始查找,找到对应的区间之后再到下一层去查找。下图演示了查找 22 的过程。
与红黑树等平衡树相比,跳跃表具有以下优点:
- 插入速度非常快速,因为不需要进行旋转等操作来维护平衡性;
- 更容易实现;
- 支持无锁操作。
zset
ziplist:满足以下两个条件的时候
- 元素数量少于128的时候
- 每个元素的长度小于64字节
skiplist:不满足上述两个条件就会使用跳表,具体来说是组合了map和skiplist
- map用来存储member到score的映射,这样就可以在O(1)时间内找到member对应的分数
- skiplist按从小到大的顺序存储分数
- skiplist每个元素的值都是[score,value]对
List
- 列表对象的编码可以是 ziplist 或者 linkedlist 。
- 列表对象保存的所有字符串元素的长度都小于 64 字节并且保存的元素数量小于 512 个,使用 ziplist 编码;否则使用 linkedlist;
Hash
- 哈希对象的编码可以是 ziplist 或者 hashtable 。
- 哈希对象保存的所有键值对的键和值的字符串长度都小于 64 字节并且保存的键值对数量小于 512 个,使用ziplist 编码;否则使用hashtable;
Set
集合对象的编码可以是 intset 或者 hashtable 。
- intset整数集合的底层实现为数组, 这个数组以有序、无重复的方式保存集合元素, 在有需要时, 程序会根据新添加元素的类型, 改变这个数组的类型。
集合对象保存的所有元素都是整数值并且保存的元素数量不超过 512 个,使用intset 编码;否则使用hashtable;
使用场景
计数器
可以对 String 进行自增自减运算,从而实现计数器功能。
Redis 这种内存型数据库的读写性能非常高,很适合存储频繁读写的计数量。
缓存
将热点数据放到内存中,设置内存的最大使用量以及淘汰策略来保证缓存的命中率。
查找表
例如 DNS 记录就很适合使用 Redis 进行存储。
查找表和缓存类似,也是利用了 Redis 快速的查找特性。但是查找表的内容不能失效,而缓存的内容可以失效,因为缓存不作为可靠的数据来源。
消息队列
List 是一个双向链表,可以通过 lpush 和 rpop 写入和读取消息
不过最好使用 Kafka、RabbitMQ 等消息中间件。
会话缓存
可以使用 Redis 来统一存储多台应用服务器的会话信息。
当应用服务器不再存储用户的会话信息,也就不再具有状态,一个用户可以请求任意一个应用服务器,从而更容易实现高可用性以及可伸缩性。
分布式锁实现
在分布式场景下,无法使用单机环境下的锁来对多个节点上的进程进行同步。
可以使用 Redis 自带的 SETNX 命令实现分布式锁,除此之外,还可以使用官方提供的 RedLock 分布式锁实现。
其它
Set 可以实现交集、并集等操作,从而实现共同好友等功能。
ZSet 可以实现有序性操作,从而实现排行榜等功能。
数据淘汰策略
键的过期时间
Redis 可以为每个键设置过期时间,当键过期时,会自动删除该键。
对于散列表这种容器,只能为整个键设置过期时间(整个散列表),而不能为键里面的单个元素设置过期时间。
数据淘汰策略
可以设置内存最大使用量,当内存使用量超出时,会施行数据淘汰策略。
Redis 具体有 6 种淘汰策略:
| 策略 | 描述 |
|---|---|
| volatile-lru | 从已设置过期时间的数据集中挑选最近最少使用的数据淘汰 |
| volatile-ttl | 从已设置过期时间的数据集中挑选将要过期的数据淘汰 |
| volatile-random | 从已设置过期时间的数据集中任意选择数据淘汰 |
| allkeys-lru | 从所有数据集中挑选最近最少使用的数据淘汰 |
| allkeys-random | 从所有数据集中任意选择数据进行淘汰 |
| noeviction | 禁止驱逐数据 |
作为内存数据库,出于对性能和内存消耗的考虑,Redis 的淘汰算法实际实现上并非针对所有 key,而是抽样一小部分并且从中选出被淘汰的 key。
使用 Redis 缓存数据时,为了提高缓存命中率,需要保证缓存数据都是热点数据。可以将内存最大使用量设置为热点数据占用的内存量,然后启用 allkeys-lru 淘汰策略,将最近最少使用的数据淘汰。
Redis 4.0 引入了 volatile-lfu 和 allkeys-lfu 淘汰策略,LFU 策略通过统计访问频率,将访问频率最少的键值对淘汰。
小结:
几百qps的逐出是正常的,几千qps需要注意,同时会有上千qps的高峰,因为redis本质是个hash table,当Hash table满了时,有新的key必须要逐出一部分才可以插入。
实践-过期数据删除
惰性删除:读写操作前判断是否过期(ttl)
定期删除:定时事件中随机抽取部分key判断是否过期(ttl)
以上两种方式不是可选的,是都有的
建议:打散key过期事件,避免大量key在同一时间过期 不要都集中在晚上某个时间点过期
持久化
Redis 是内存型数据库,为了保证数据在断电后不会丢失,需要将内存中的数据持久化到硬盘上。
Redis 支持同时启用 RDB 和 AOF。优先级:如果两者都启用,Redis 在重启时会优先加载 AOF 文件。
在 Redis 4.0 后,增加了 AOF 和 RDB 混合的数据持久化机制: 把数据以 RDB 的方式写入文件,再将后续的操作命令以 AOF 的格式存入文件,既保证了 Redis 重启速度,又降低数据丢失风险。如果把混合持久化打开,AOF 重写的时候就直接把 RDB 的内容写到 AOF 文件开头。这样做的好处是可以结合 RDB 和 AOF 的优点, 快速加载同时避免丢失过多的数据。当然缺点也是有的, AOF 里面的 RDB 部分是压缩格式不再是 AOF 格式,可读性较差。
重启方式
正常关闭 (
SHUTDOWN) 并重启- Redis 会将内存中的数据写入持久化文件(如果持久化开启),重启后可以恢复。
非正常关闭(如强制杀进程或断电)
- 如果没有及时保存快照或同步 AOF,数据可能丢失。可能丢失最近的部分写入。
RDB 持久化
将某个时间点的所有数据都存放到硬盘上。
可以将快照复制到其它服务器从而创建具有相同数据的服务器副本。
如果系统发生故障,将会丢失最后一次创建快照之后的数据。
如果数据量很大,保存快照的时间会很长。
RDB 做快照时会阻塞线程吗?
Redis 提供了两个命令来生成 RDB 快照文件,分别是 save 和 bgsave。save 命令在主线程中执行,会导致阻塞。而 bgsave 命令则会创建一个子进程,用于写入 RDB 文件的操作,避免了对主线程的阻塞,这也是 Redis RDB 的默认配置。
fork子进程dump可能造成瞬间卡顿
- 经过压缩的二进制格式
- fork子进程dump可能造成瞬间卡顿
- 是全量的
RDB 做快照的时候数据能修改吗?
save 是同步的会阻塞客户端命令,bgsave 的时候是可以修改的。
- 如果主线程执行读操作,则主线程和 bgsave 子进程互相不影响;
- 如果主线程执行写操作,则被修改的数据会复制一份副本,然后 bgsave 子进程会把该副本数据写入 RDB 文件,在这个过程中,主线程仍然可以直接修改原来的数据。
AOF 持久化
AOF持久化:保存所有修改数据库命令,先写缓存再写文件(beforeSleep时),aof重写在达到阀值时触发。
AOF 采用的是写后日志的方式,Redis 先执行命令把数据写入内存,然后再记录日志到文件中。AOF 日志记录的是操作命令,不是实际的数据,如果采用 AOF 方法做故障恢复时需要将全量日志都执行一遍。
为什么是在执行完命令之后记录日志呢?
避免额外的检查开销,AOF 记录日志不会对命令进行语法检查;
在命令执行完之后再记录,不会阻塞当前的命令执行。
后写日志主要有两个风险可能会发生:
- 数据可能会丢失:如果 Redis 刚执行完命令,此时发生故障宕机,会导致这条命令存在丢失的风险。
- 可能阻塞其他操作:AOF 日志其实也是在主线程中执行,所以当 Redis 把日志文件写入磁盘的时候,还是会阻塞后续的操作无法执行。
应用:利用aof文件灾备,恢复到三天内任意小时状态
将写命令添加到 AOF 文件(Append Only File)的末尾。
使用 AOF 持久化需要设置同步选项,从而确保写命令同步到磁盘文件上的时机。这是因为对文件进行写入并不会马上将内容同步到磁盘上,而是先存储到缓冲区,然后由操作系统决定什么时候同步到磁盘。有以下同步选项:
| 选项 | 同步频率 |
|---|---|
| always | 每个写命令都同步 |
| everysec | 每秒同步一次 |
| no | 让操作系统来决定何时同步 |
- always 选项会严重减低服务器的性能;
- everysec 选项比较合适,可以保证系统崩溃时只会丢失一秒左右的数据,并且 Redis 每秒执行一次同步对服务器性能几乎没有任何影响;
- no 选项并不能给服务器性能带来多大的提升,而且也会增加系统崩溃时数据丢失的数量。
随着服务器写请求的增多,AOF 文件会越来越大。Redis 提供了一种将 AOF 重写的特性,能够去除 AOF 文件中的冗余写命令。
对比
RDB 文件存储的内容是经过压缩的二进制数据, 保存着某个时间点的数据集,文件很小,适合做数据的备份,灾难恢复。AOF 文件存储的是每一次写命令,类似于 MySQL 的 binlog 日志,通常会比 RDB 文件大很多。
- Redis 保存的数据丢失一些也没什么影响的话,可以选择使用 RDB。
- 不建议单独使用 AOF,因为时不时地创建一个 RDB 快照可以进行数据库备份、更快的重启以及解决 AOF 引擎错误。
- 如果保存的数据要求安全性比较高的话,建议同时开启 RDB 和 AOF 持久化或者开启 RDB 和 AOF 混合持久化。
redis单机内存寻址
Redis拿到一个 key 后,先判断当前库的 0 号和1号哈希表是否为空,如果为 true 直接返回 NULL。这里可以布隆过滤器优化
redis底层其实就是一个hash结构,拉链法的一个hash map.
Redis 中的 “0 号和 1 号哈希表” 是 Redis 底层 dict 结构中的双哈希表,用于管理键值对和支持渐进式 rehash。它们与 Redis 的哈希数据类型(HSET、HGET 等)无关,而是 Redis 存储引擎的实现细节,用于优化性能和动态扩容。
哈希表 0 和哈希表 1 的用途:
- 哈希表 0:当前正在使用的主哈希表,存储了所有的键值对。
- 哈希表 1:在执行哈希表扩容或收缩时(如重新哈希操作),用作临时存储。
事件驱动
Redis 服务器是一个事件驱动程序。
Redis是单线程服务
文件事件(连接相关,相应请求)-> 时间事件(定时任务,以无序列表保存)
beforesleep:进入event loop前执行,比如cluster集群状态检查、将aof buffer持久化到aof文件。 beforeSleep ->processEvents( 文件事件(epollwait -> 处理请求) -> 定时事件 ) 建议:减少大key,减少耗时命令…

文件事件
服务器通过套接字与客户端或者其它服务器进行通信,文件事件就是对套接字操作的抽象。
Redis 基于 Reactor 模式开发了自己的网络事件处理器,使用 I/O 多路复用程序来同时监听多个套接字,并将到达的事件传送给文件事件分派器,分派器会根据套接字产生的事件类型调用相应的事件处理器。
- read事件: 新建请求、接收请求
- write事件: 返回结果
时间事件
服务器有一些操作需要在给定的时间点执行,时间事件是对这类定时操作的抽象。
时间事件又分为:
- 定时事件:是让一段程序在指定的时间之内执行一次;
- 周期性事件:是让一段程序每隔指定时间就执行一次。
Redis 将所有时间事件都放在一个无序链表中,通过遍历整个链表查找出已到达的时间事件,并调用相应的事件处理器。
- 更新服务器统计信息,如内存等。
- key过期请群里
- 关闭清理失效客户端连接
- 检查是否需要rdb dump, aof重写。
- 主从同步
事件的调度与执行
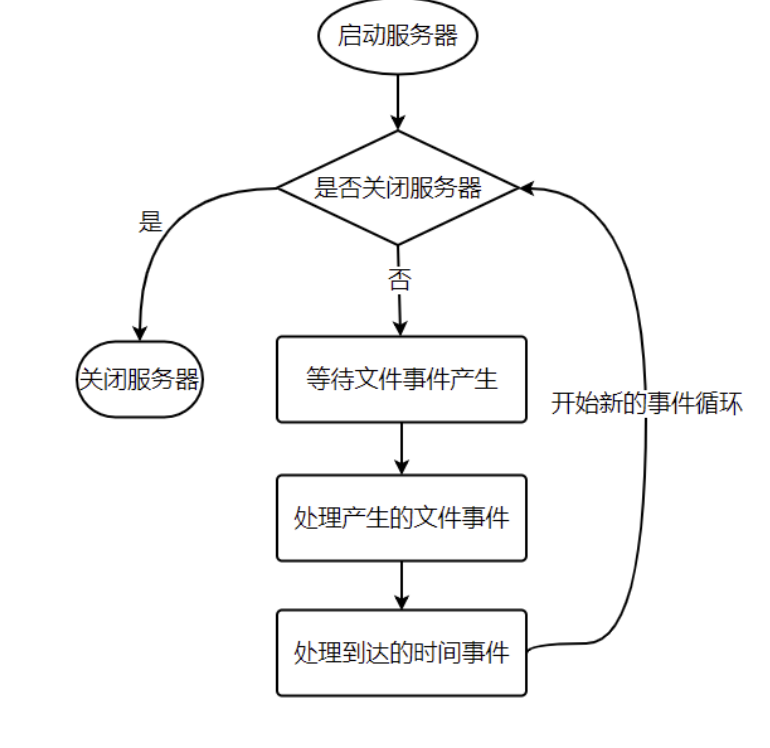
服务器需要不断监听文件事件的套接字才能得到待处理的文件事件,但是不能一直监听,否则时间事件无法在规定的时间内执行,因此监听时间应该根据距离现在最近的时间事件来决定。
事件调度与执行由 aeProcessEvents 函数负责,伪代码如下:
def aeProcessEvents():
    # 获取到达时间离当前时间最接近的时间事件
    time_event = aeSearchNearestTimer()
    # 计算最接近的时间事件距离到达还有多少毫秒
    remaind_ms = time_event.when - unix_ts_now()
    # 如果事件已到达,那么 remaind_ms 的值可能为负数,将它设为 0
    if remaind_ms < 0:
        remaind_ms = 0
    # 根据 remaind_ms 的值,创建 timeval
    timeval = create_timeval_with_ms(remaind_ms)
    # 阻塞并等待文件事件产生,最大阻塞时间由传入的 timeval 决定
    aeApiPoll(timeval)
    # 处理所有已产生的文件事件
    procesFileEvents()
    # 处理所有已到达的时间事件
    processTimeEvents()
将 aeProcessEvents 函数置于一个循环里面,加上初始化和清理函数,就构成了 Redis 服务器的主函数,伪代码如下:
def main():
    # 初始化服务器
    init_server()
    # 一直处理事件,直到服务器关闭为止
    while server_is_not_shutdown():
        aeProcessEvents()
    # 服务器关闭,执行清理操作
    clean_server()
从事件处理的角度来看,服务器运行流程如下:
分片
分片是将数据划分为多个部分的方法,可以将数据存储到多台机器里面,这种方法在解决某些问题时可以获得线性级别的性能提升。
假设有 4 个 Redis 实例 R0,R1,R2,R3,还有很多表示用户的键 user:1,user:2,… ,有不同的方式来选择一个指定的键存储在哪个实例中。
- 最简单的方式是范围分片,例如用户 id 从 0~1000 的存储到实例 R0 中,用户 id 从 1001~2000 的存储到实例 R1 中,等等。但是这样需要维护一张映射范围表,维护操作代价很高。
- 还有一种方式是哈希分片,使用 CRC32 哈希函数将键转换为一个数字,再对实例数量求模就能知道应该存储的实例。
根据执行分片的位置,可以分为三种分片方式:
- 客户端分片:客户端使用一致性哈希等算法决定键应当分布到哪个节点。
- 代理分片:将客户端请求发送到代理上,由代理转发请求到正确的节点上。
- 服务器分片:Redis Cluster。
Pipline & mget
如果没有代理层,那就会逻辑实现在客户端。
Pipeline
client:将多个命令缓存,满了就发送
redis:处理一个tcp发来的多个命令
twemproxy:既要处理一个client发来的多个命令,又要将到同一个下游redis server的命令缓存起来一起发
Twemproxy(也称为 Nutcracker)是由 Twitter 开发的一款轻量级的中间件,主要用于:
- 代理多个 Redis 或 Memcached 实例。
- 提供简单的分布式支持,而无需客户端直接实现分布式逻辑。
- 支持将请求按照特定的分片算法分发到多个 Redis 或 Memcached 实例。
- 客户端只需连接 Twemproxy,而无需直接管理多个实例。
- 客户端与 Twemproxy 之间是长连接,减少了频繁建立连接的开销。
- 支持一致性hash分片
mget
proxy缓存,延时是最后一个key回复时间,一起返回给上游(pipeline是每个命令分别回复)
使用
pipeline- 如果需要批量执行多种 Redis 命令(如
SET和GET的混合操作),或者希望减少网络通信延迟。
- 如果需要批量执行多种 Redis 命令(如
使用
mget- 如果场景仅涉及批量
GET操作,mget是更高效的选择,因为它直接对多键查询进行了底层优化。
- 如果场景仅涉及批量
建议使用pipeline 但要注意请求数量(50-)
集群部署
- 主从
- 多机房:通过队列同步,记得延迟删除。防止主库删数据后,缓存失效,查从库都读回来了。