必备知识
一个整数4个字节,一个字节有8位。1G = 2^10M = 1024M, 1K= 2^10B, 1B = 8b
B 是字节,b是位,1024=2^10.
内存512M指的是512M字节。
所以4G个数用位图存的是4G/8字节,因为一个字节8位。
位图存储所有整数, 2^32位 。 2²⁹ 字节 = 512 MB 就够了
注意哈希的使用,哈希不等,一般就不相等了
- 分治 + 哈希
- 位图扩展
- 分治 + 比对
找最大
在超大文件中找出访问百度次数最多的IP
题目描述
现有海量日志数据保存在一个超级大的文件中,该文件无法直接读入内存,要求从中提取某天出访问百度次数最多的那个IP
思考过程
(1)面试中若题目提到大文件等,其实就是告诉你数据量大,不能一次性加载到内存中,而实际中我们就需要估算。既然是要对访问百度次数的ip做统计,我们最好先预处理一下,遍历把访问百度的所有ip写到另一个文件a中
(2)ip用32位表示,所以最多有2^32个不同ip地址。同样的,当内存不能一次性加载数据时,我们就需要考虑分治法。
step1:采用hash映射(hash(ip)%1000)分别把结果保存到小文件a0….a999中。有人可能会问,这里一定要用1000吗?当然不一定,需要估算,比如若文件a总共320G远远大于4G内存,我们就需要分块(hash映射),若分为1000块,则每块大约300M,再读入内存就没问题了。
step2:可以采用hash_map进行频率统计,找出每个小文件中出现频率最大的IP。对于每一个小文件ai,具体操作如下:创建hash_map,遍历小文件中每条记录。对于每条记录,先在hash_map中搜索,若有,将hash_map中记录count+1,若没有,插入hash_map
step3:在这1000个最大的IP中,找出count最大的ip
Top K问题
查找出现次数在前K的IP地址
题目描述
如题
思考过程
和上一个题目类似,不同的是
将所有文件的出现次数前K个IP地址放在一起,再找出前K个IP地址,就是所要求的IP,至此问题解决。
关于堆实现Top K:有一堆海量数据,需要求最大的K个数,排序太耗时间,这个时候用的即堆,建一个元素个数为K个的堆,由于要找最大的N个数,所以要建小堆(没错就是小堆),然后依次从文件读取数据,当读入数据大于堆顶元素,就取代堆顶元素,然后重新调整为小堆,直至元素读取完成。
位图
给两个文件,分别有100亿个整数,我们只有1G内存,如何找到两个文件的交集?
题目描述
给两个文件,分别有100亿个整数,我们只有1G内存,如何找到两个文件的交集?
思考过程
位图 + 比对
我们知道对于整形数据来说,不管是有符号的还是无符号的,总共有2^32=4G个数据(100亿个数据中肯定存在重复的数据),我们可以采用位图的方式来解决,假如我们用一个位来代表一个整形数据,那仫4G个数共占512M内存(八个数一个字节,4G/8=512M)。我们的做法是将第一个文件里的数据映射到位图中,再拿第二个文件中的数据和第一个文件中的数据做对比,有相同的数据就是存在交集(重复的数据,交集中只会出现一次).

分治 + 比对
整数无非是32位,将其按位切割,对文件1进行切割,第一位(也就是最高位)为1的切割进一个文件,第一位(最高位)为0进入另一个文件; 重复第1步,对切割的文件进行再次切割,第1次是第1位,第2次对第2位进行切割,直至切割完毕; 文件2每个数进行查找,由于已经进行切割,查找类似于二分查找,效率很高,最坏也不过查找32次。
假定一个文件有100亿个整形数据,1G内存,如何找到出现次数不超过两次的数字?
题目描述
假定一个文件有100亿个整形数据,1G内存,如何找到出现次数不超过两次的数字?
思考过程
分析:要解决这个问题同样需要用到位图的思想,在问题二中已经了解到采用位图的一个位可以判断数据是否存在,那仫找到出现次数不超过两次的数字使用一个位是无法解决的,在这里可以考虑采用两个位的位图来解决.
根据上述分析我们可以借助两个位,来表示数字的存在状态和存在次数,比如:00表示不存在,01表示存在一次,10表示存在两次,11表示存在超过两次;类似问题二的计算过程:如果一个数字占一位,需要512M内存即可,但是如果一个数字占两位,则需要(2^32)/(2^2)=2^30=1G内存;将所有数据映射到位图中查找不是11的所对应的数字就解决上述问题了。
题目扩展:其他条件不变,假如只给定512M内存该如何找到出现次数不超过两次的数字?
分析:将数据分批处理,假若给定的是有符号数,则先解决正数,再解决负数,此时512M正好解决上述问题.
类似的找出现一次的,出现两次的
如何从40亿整数中找到不存在的一个
https://zhuanlan.zhihu.com/p/53366992
内存够大就位图,
不够大就hash后再位图,实际上可以按照比特位,每次选数据少的那堆,因为数据少的肯定比数据多的还缺(只有不重复情况下有效)。
给两个文件,分别有100亿个query,我们只有1G内存,如何找到两文件交集?分别给出精确算法和近似算法!
题目描述
给两个文件,分别有100亿个query,我们只有1G内存,如何找到两文件交集?分别给出精确算法和近似算法!
其实就是查找相同的字符串,但字符串没法子桶装了,因为数量无限啊,不像int那样32位
思考过程
看到字符串首先应该反应过来的就是布隆过滤器,而问题四的近似算法就是采用布隆过滤器的方法,之所以说布隆过滤器是近似的算法,因为它存在一定 的误判(不存在是肯定的,存在是不肯定的);而要想精确判断字符串文件的交集,我们可以采用分而治之的方法:将大文件切分为一个一个的小文件,将一个又一个的小文件拿到内存中做对比,找到对应的交集。
哈希切分的精确解决办法:
既然叫做切分,顾名思义就是将大文件切分为小文件,那仫如何切分?切分的依据是什仫呢?如果我们在切分的时候可以将相似或者相同的文件切分到同一个文件中那仫是不是就加快了查找交集的速度呢?答案是肯定的。
知道了哈希切分的依据我们应该如何处理呢?我们可以根据字符串的某个哈希算法得到该字符串的key,然后将key模要分割的文件数(假设为1000个文件,文件编号为0~999),我们将结果相同的字符串放到同一个文件中(两个文件中的字符串通过相同的哈希算法就会被分到下标相同的文件中),此时我们只需要将下标相同的文件进行比对就可以了。。。
也算是桶分组后分而治之了
近似算法
布隆过滤器。将其中一个文件的内存映射到位图中,在用另一个文件中的内存到这个位图中寻找。布隆器介绍在后面
给上千个文件,每个文件大小为1K~100M。给n个词,设计算法对每个词找到所有包含它的文件,你只有100K内存
题目描述
给上千个⽂文件,每个文件大小为1K~100M。给n个词,设计算法对每个词找到所有包含它的文件,你只有100K内存
倒排索引
将n个单词构成一颗二叉搜索树,如果是中文,则先经过分词再构建;
对每个文件的每个词进行搜索,如果该词存在,将其文件名挂在对应单词后面,直至文件读取结束;
每个节点后所挂的文件信息列表即需要获取的信息
看图了解倒排索引

字典树
有一个词典,包含N个英文单词,现在任意给一个字符串,设计算法找出包含这个字符串的所有英文单词
题目描述
有一个词典,包含N个英文单词,现在任意给一个字符串,设计算法找出包含这个字符串的所有英文单词
思考过程
字典树
字典树是一种特殊的树,根节点为空,每个节点只有一个字母,如图:

根节点不包含字符,除根节点外每个节点都只包含一个字符。从根节点到某一节点,路径上所有经过的字符连接起来,为该节点对应的字符串。每个节点的所有子节点包含的字符都不相同。
解决方案:
用给出的N个单词简历一棵与上述字典树不同的字典树,用任意字符串与字典树中的每个节点中的单词进行比较,在每层中查找与任意字符串首字母一样的,找到则遍历其下面的子树,直到全部相同。
布隆过滤器(Bloom Filter)详解
直观的说,bloom算法类似一个hash set,用来判断某个元素(key)是否在某个集合中。 和一般的hash set不同的是,这个算法无需存储key的值,对于每个key,只需要k个比特位,每个存储一个标志,用来判断key是否在集合中。
算法:
- 首先需要k个hash函数,每个函数可以把key散列成为1个整数
- 初始化时,需要一个长度为n比特的数组,每个比特位初始化为0
- 某个key加入集合时,用k个hash函数计算出k个散列值,并把数组中对应的比特位置为1
- 判断某个key是否在集合时,用k个hash函数计算出k个散列值,并查询数组中对应的比特位,如果所有的比特位都是1,认为在集合中。
缺点:
- 算法判断key在集合中时,有一定的概率key其实不在集合中
- 无法删除
应用场景
某些存储系统的设计中,会存在空查询缺陷:当查询一个不存在的key时,需要访问慢设备,导致效率低下。
比如一个前端页面的缓存系统,可能这样设计:先查询某个页面在本地是否存在,如果存在就直接返回,如果不存在,就从后端获取。但是当频繁从缓存系统查询一个页面时,缓存系统将会频繁请求后端,把压力导入后端。
这时只要增加一个bloom算法的服务,后端插入一个key时,在这个服务中设置一次。 需要查询后端时,先判断key在后端是否存在,这样就能避免后端的压力。
如何扩展BloomFilter使得它支持删除元素的操作?
由于布隆过滤器是不存在为一定,存在不一定,如果很多个元素拥有相同的BIT位,此时删除其中一个位,会影响到其他的数据,所以不能删除,因此可以采用对每个位进行引用计数即可。
大数据流问题
数据流采样k个元素
其实就是蓄水池抽样
基数估计(统计UV)
- set 大数据量有问题
- bitmap 数据范围大则内存也大
- HyperLogLog
HyperLogLog实际上不会存储每个元素的值,它使用的是概率算法,通过存储元素的hash值的第一个1的位置,来计算元素数量。
最直白的解释是,给定一个集合 S,对集合中的每一个元素,我们做一个哈希,假设生成一个 16 位的比特串,从所有生成的比特串中挑选出前面连续 0 次数最多的比特串,假设为 0000000011010110,连续 0 的次数为 8,因此我们可以估计该集合 S 的基数为 2^9。就像抛硬币直到抛正也就是为1用了多少次,那根据伯努利原理就可以估计总共进行了多少次
当然单独用这样的单一估计偶然性较大,导致误差较大,因此在实际的 HyperLogLog 算法中,采取分桶平均原理了来消除误差。
参考:
频率统计
- hashmap 或者+分片,但大数据量还是有代价
- Count-Min Sketch
- 其实就是布隆过滤器(d个hash,每次hash成一个int)加个计数功能,d个hash的计数取最小那个。
Top K频繁项
hashmap + heap
多机hashmap+ heap,多可以多机的heap合并
Count-Min Sketch + Heap
在数据流不断流入的过程中,维护一个标准的Count-Min Sketch 二维数组
维护一个小根堆,容量为k
每次来一个新元素,
- 将相应的sketch增1
- 在堆中查找该元素,如果找到,把堆里的计数器也增1,并调整堆;如果没有找到,把这个元素的sketch作为钙元素的频率的近似值,跟堆顶元素比较,如果大于堆丁元素的频率,则把堆丁元素替换为该元素,并调整堆
Lossy Counting
Lossy Couting 算法流程:
- 建立一个HashMap,用于存放每个元素的出现次数
- 建立一个窗口(窗口的大小由错误率决定,后面具体讨论)
- 等待数据流不断流进这个窗口,直到窗口满了,开始统计每个元素出现的频率,统计结束后,每个元素的频率减1,然后将出现次数为0的元素从HashMap中删除
- 返回第2步,不断循环
Lossy Counting 背后朴素的思想是,出现频率高的元素,不太可能减一后变成0,如果某个元素在某个窗口内降到了0,说明它不太可能是高频元素,可以不再跟踪它的计数器了。随着处理的窗口越来越多,HashMap也会不断增长,同时HashMap里的低频元素会被清理出去,这样内存占用会保持在一个很低的水平。
很显然,Lossy Counting 算法是个近似算法,但它的错误率是可以在数学上证明它的边界的。假设要求错误率不大于ε,那么窗口大小为1/ε,对于长度为N的流,有N/(1/ε)=εN 个窗口,由于每个窗口结束时减一了,那么频率最多被少计数了窗口个数εN。
该算法只需要一遍扫描,所以时间复杂度是
O(n)。
范围查找
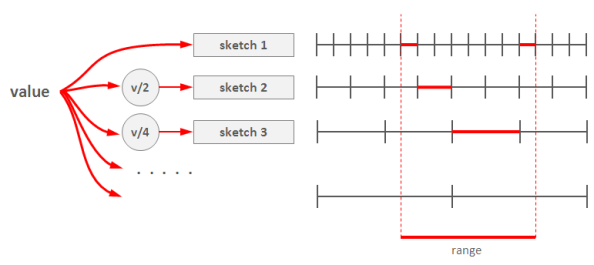
给定一个无限的整数数据流,如何查询在某个范围内的元素出现的总次数?例如数据库常常需要SELECT count(v) WHERE v >= l AND v < u。这个经典的问题称为范围查询(Range Query)。
Array of Count-Min Sketches
有一个简单方法,既然Count-Min Sketch可以计算每个元素的频率,那么我们把指定范围内所有元素的sketch加起来,不就是这个范围内元素出现的总数了吗?要注意,由于每个sketch都是近似值,多个近似值相加,误差会被放大,所以这个方法不可行。
解决的办法就是使用多个“分辨率”不同的Count-Min Sketch。第1个sketch每个格子存放单个元素的频率,第2个sketch每个格子存放2个元素的频率(做法很简答,把该元素的哈希值的最低位bit去掉,即右移一位,等价于除以2,再继续后续流程),第3个sketch每个格子存放4个元素的频率(哈希值右移2位即可),以此类推,最后一个sketch有2个格子,每个格子存放一半元素的频率总数,即第1个格子存放最高bit为0的元素的总次数,第2个格子存放最高bit为1的元素的总次数。Sketch的个数约等于log(不同元素的总数)。
插入元素时,算法伪代码如下,
  def insert(x):
      for i in range(1, d+1):
          M1[i][h[i](x)] += 1
          M2[i][h[i](x)/2] += 1
          M3[i][h[i](x)/4] += 1
          M4[i][h[i](x)/8] += 1
          # ...
查询范围[l, u)时,从粗粒度到细粒度,找到多个区间,能够不重不漏完整覆盖区间[l, u),将这些sketch的值加起来,就是该范围内的元素总数。举个例子,给定某个范围,如下图所示,最粗粒度的那个sketch里找不到一个格子,就往细粒度找,最后找到第1个sketch的2个格子,第2个sketch的1个格子和第3个sketch的1个格子,共4个格子,能够不重不漏的覆盖整个范围,把4个红线部分的值加起来就是所求结果