复杂度
- 若待排序的记录的关键字在一个明显有限范围内时,且空间允许时用桶排序。
- 当n较大时,关键字元素比较随机,对稳定性没要求宜用快速排序。
- 当n较大时,关键字元素可能出现本身是有序的,对稳定性有要求时,空间允许的情况下宜用归并排序。
- 当n较大时,关键字元素可能出现本身是有序的,对稳定性没有要求时宜用堆排序
排序算法的比较
| 算法 | 稳定性 | 时间复杂度 | 空间复杂度 | 备注 |
|---|---|---|---|---|
| 选择排序 | × | N2 | 1 | |
| 冒泡排序 | √ | N2 | 1 | |
| 插入排序 | √ | N ~ N2 | 1 | 时间复杂度和初始顺序有关 |
| 希尔排序 | × | N 的若干倍乘于递增序列的长度 | 1 | |
| 快速排序 | × | NlogN - N2 | logN | |
| 三向切分快速排序 | × | N ~ NlogN | logN | 适用于有大量重复主键 |
| 归并排序 | √ | NlogN | N | |
| 堆排序 | × | NlogN | 1 | |
| 桶排序 | √ | N | N |
快速排序是最快的通用排序算法,它的内循环的指令很少,而且它还能利用缓存,因为它总是顺序地访问数据。它的运行时间近似为 ~cNlogN,这里的 c 比其它线性对数级别的排序算法都要小。使用三向切分快速排序,实际应用中可能出现的某些分布的输入能够达到线性级别,而其它排序算法仍然需要线性对数时间。
归并排序
以size()==1作为出栈的时间

class Solution:
    def merge(self, left_arr, right_arr):
        arr = []
        while left_arr and right_arr:
            if left_arr[0] <= right_arr[0]:
                arr.append(left_arr.pop(0))
            else:
                arr.append(right_arr.pop(0))
        while left_arr:
            arr.append(left_arr.pop(0))
        while right_arr:
            arr.append(right_arr.pop(0))
        return arr

    def mergeSort(self, arr):
        size = len(arr)
        if size < 2:
            return arr
        mid = len(arr) // 2
        left_arr, right_arr = arr[0: mid], arr[mid:]
        return self.merge(self.mergeSort(left_arr), self.mergeSort(right_arr))

    def sortArray(self, nums: List[int]) -> List[int]:
        return self.mergeSort(nums)
快速排序
以l==r作为出栈入口

def partition(nums, l, r):
    if l > r:
        return
    v = nums[l]
    while l < r:
        while l < r and nums[r] > v:
            r -= 1
        if l < r:
            nums[l] = nums[r]
            l += 1
        while l < r and nums[l] < v:
            l += 1
        if l < r:
            nums[r] = nums[l]
            r -= 1
    nums[l] = v
    return l

# 快速排序
def quick_sort(nums, l, r):
    if l >= r:
        return
    mid = partition(nums, l, r)
    quick_sort(nums, l, mid - 1)
    quick_sort(nums, mid + 1, r)


'''
找第k小,k从0开始
'''
def find_K(nums, k):
    ans = None

    def f(l, r):
        if l > r:
            return
        mid = partition(nums, l, r)
        if mid == k:
            nonlocal ans
            ans = nums[mid]
            return
        if mid > k:
            f(l, mid - 1)
        else:
            f(mid + 1, r)

    f(0, len(nums) - 1)
    return ans


if __name__ == '__main__':
    nums = [1, 23, 4, 3, 134, 1, 31, 24, 321, 4, 21, 4, 3, 12]
    r = find_K(nums, 10)
    print(r)
    quick_sort(nums, 0, len(nums) - 1)
    print(nums)
int partition(vector<int> &v, int left, int right) {
	int p = v[left];
	while (left < right) {
		while (left<right&&v[right]>p) right--;
		if(left<right) v[left++] = v[right];
		while (left < right&&v[left] < p) left++;
		if (left < right) v[right--] = v[left];
	}
	v[left] = p;
	return left;
}
int quicksort(vector<int>&v, int left, int right) {
	if (left < right) {
		int r = partition(v, left, right);
		quicksort(v, left, r - 1);
		quicksort(v, r + 1, right);
	}
	return 0;
}
以上是填坑法,下面是交换法
交换法的思想: 用两个指针 i 和 j 分别指向数组的第一个数和最后一个数,选取第一个数为基准数 pivot = arr [0],首先从 j 所指位置自右向左逐一搜索,找到第一个小于 pivot 的数字,再从 i 所指位置自左向右逐一搜索,找到第一个大于 pivot 的数字,如果此时 i < j,则交换 i 和 j 所指的两个数字,然后继续以上搜索,满足条件时交换,直至 i == j 为止,最后将基准值位置的数字(基准值)与 i, j 相等时所指位置的数字交换,至此一次分区结束。
参考: https://neverknowstomorrow.github.io/2019/09/13/quick-sort/ 小心代码可能有问题。
算法改进
(一)切换到插入排序
因为快速排序在小数组中也会递归调用自己,对于小数组,插入排序比快速排序的性能更好,因此在小数组中可以切换到插入排序。
(二)三数取中
最好的情况下是每次都能取数组的中位数作为切分元素,但是计算中位数的代价很高。人们发现取 3 个元素并将大小居中的元素作为切分元素的效果最好。
(三)三向切分
对于有大量重复元素的数组,可以将数组切分为三部分,分别对应小于、等于和大于切分元素。
三向切分快速排序对于只有若干不同主键的随机数组可以在线性时间内完成排序。
public class ThreeWayQuickSort<T extends Comparable<T>> extends QuickSort<T> {
    @Override
    protected void sort(T[] nums, int l, int h) {
        if (h <= l)
            return;
        int lt = l, i = l + 1, gt = h;
        T v = nums[l];
        while (i <= gt) {
            int cmp = nums[i].compareTo(v);
            if (cmp < 0)
                swap(nums, lt++, i++);
            else if (cmp > 0)
                swap(nums, i, gt--);
            else
                i++;
        }
        sort(nums, l, lt - 1);
        sort(nums, gt + 1, h);
    }
}
快速排序找第k小
自己写的
改造于快排,记得是if(left<right)
快排切分时间复杂度分析: 因为我们是要找下标为k的元素,第一次切分的时候需要遍历整个数组 (0 ~ n) 找到了下标是 j 的元素,假如 k 比 j 小的话,那么我们下次切分只要遍历数组 (0~k-1)的元素就行啦,反之如果 k 比 j 大的话,那下次切分只要遍历数组 (k+1~n) 的元素就行啦,总之可以看作每次调用 partition 遍历的元素数目都是上一次遍历的 1/2,因此时间复杂度是 N + N/2 + N/4 + … + N/N = 2N, 因此时间复杂度是 O(N)。
参考上面
解释一下为什么时间复杂度是O(n):
- 第一次分区查找,我们需要对大小为 n 的数组执行分区操作,需要遍历 n 个元素。第二次分区查找,我们只需要对大小为 n/2 的数组执行分区操作,需要遍历 n/2 个元素。依次类推,分区遍历元素的个数分别为、n/2、n/4、n/8、n/16.……直到区间缩小为 1。 如果我们把每次分区遍历的元素个数加起来,就是:n+n/2+n/4+n/8+…+1。这是一个等比数列求和,最后的和等于 2n-1。所以,上述解决思路的时间复杂度就为 O(n)。
选择排序
public class Selection<T extends Comparable<T>> extends Sort<T> {
    @Override
    public void sort(T[] nums) {
        int N = nums.length;
        for (int i = 0; i < N; i++) {
            int min = i;
            for (int j = i + 1; j < N; j++)
                if (less(nums[j], nums[min]))
                    min = j;
            swap(nums, i, min);
        }
    }
}
插入排序
void insertSort(vector<int> &v) {
	int n = v.size();
	for (int i = 0; i < n; i++) {
		int t = v[i],j=i-1;
		for (j = i - 1; j >= 0 && v[j] > t; j--) {
			v[j + 1] = v[j];
		}
		v[j + 1] = t;
	}
}

void insertsort(vector<int> &d) {
	int n = d.size();
	for (int i = 1; i < n; i++) {
		for (int j = i; j > 0 && d[j] < d[j - 1]; j--) {
			swap(d[j], d[j - 1]);
		}
	}
}


int main()
{
	vector<int> v = { 3,2,1,4,5,8,3,5,5 };
	insertSort(v);
	for (auto it : v) {
		cout << it << " ";
	}
	return 0;
}
希尔排序
希尔排序是把记录按下标的一定增量分组,对每组使用直接插入排序算法排序;随着增量逐渐减少,每组包含的关键词越来越多,当增量减至1时,整个文件恰被分成一组,算法便终止
第二个for循环是插入排序
插入排序中就有外边的总的遍历,也就是第二个for循环,然后第三个for循环实现插入排序的找插入位置
void shellsort(vector<int> &v) {
	for (int d = v.size() / 2; d > 0; d /= 2) {
		for (int i = d; i < v.size(); i++) {
			for (int j = i - d; j >= 0 && v[j] > v[j + d]; j -= d) {
				swap(v[j], v[j + d]);
			}
		}
	}
}

int main() {
	vector<int> v = { 3,1,3,2,4,8,5,6,9 };
	shellsort(v);
	for (auto it : v) {
		cout << it << endl;
	}
	return 0;
}
    public static void sort(Comparable[] a){
        int n=a.length;
        for(int gap=n/2;gap>0;gap/=2){
            for(int i=gap;i<n;i++){
                for(int j=i;j>=gap&&less(a[j],a[j-gap]);j-=gap){
                    swap(a,j,j-gap);
                }
            }
        }
    }
void shellsort3(int a[], int n)
{
	int i, j, gap;

	for (gap = n / 2; gap > 0; gap /= 2)
		for (i = gap; i < n; i++)
			for (j = i - gap; j >= 0 && a[j] > a[j + gap]; j -= gap)
				Swap(a[j], a[j + gap]);
}
堆排序
时间复杂度
建堆:O(n); 更新堆: O(nlogn)
建堆时间复杂度分析: 堆排序中建堆过程时间复杂度O(n)怎么来的? - TOMOCAT的回答 - 知乎 https://www.zhihu.com/question/20729324/answer/2223732201
由于是完全二叉树, 故有:
PARENT(i)
  return i / 2
LEFT(i)
  return 2 * i
RIGHT(i)
  2 * i + 1
建堆
对非叶子节点形成堆,伪代码:
//
MAX-HEAPIFY(A, i)

l = LIFT(i)
r = RIGHT(i)
if l <= A.heapsize and A[l] > A[i]
  largest = l
else largest = i
if r <= A.heapsize and A[r] > A[largest]
  largest = r
if largest != i
  exchage A[i] with A[largest]
  MAX-HEAPIFY(A, largest)
非递归写法。1开始
// x 是要下沉的元素,从树的顶部开始下沉
private void shift_down(int x) {
  while (x * 2 <= n) {
    // minChild 是获取更小的子节点的索引并返回
    mc = minChild(x);
    if (h[mc] <= h[x]) break;
    swap(h[x], h[mc]);
    x = mc;
  }
}
Build Heap
以最大堆为例,伪代码:
BUILD-MAX-HEAP(A):

A.heap-size = A.length
for A.length / 2 downto 1
  MAX-HEAPIFY(A, i)
堆排序
以最大堆为例,伪代码:
HEAPSORT(A) :
BUILD-MAX-HEAP(A)

for i = A.length downto 2
  exchange A[1] with A[i]
  A.heap-size = A.heap-size - 1
  MAX-HEAPIFY(A, 1)
c++代码
#include<cstdio>
#include<iostream>
#include<cstring>
#include<algorithm>
using namespace std;
// index实际就是end
void adjust(int arr[], int len, int index)
{
    int left = 2*index + 1;
    int right = 2*index + 2;
    int maxIdx = index;
    if(left<len && arr[left] > arr[maxIdx]) maxIdx = left;
    if(right<len && arr[right] > arr[maxIdx]) maxIdx = right;  // maxIdx是3个数中最大数的下标
    if(maxIdx != index)                 // 如果maxIdx的值有更新
    {
        swap(arr[maxIdx], arr[index]);
        adjust(arr, len, maxIdx);       // 递归调整其他不满足堆性质的部分
    }

}
void heapSort(int arr[], int size)
{
    for(int i=size/2 - 1; i >= 0; i--)  // 对每一个非叶结点进行堆调整(从最后一个非叶结点开始)
    {
        adjust(arr, size, i);
    }
    for(int i = size - 1; i >= 1; i--)
    {
        swap(arr[0], arr[i]);           // 将当前最大的放置到数组末尾
        adjust(arr, i, 0);              // 将未完成排序的部分继续进行堆排序
    }
}

int main()
{
    int array[8] = {8, 1, 14, 3, 21, 5, 7, 10};
    heapSort(array, 8);
    for(auto it: array)
    {
        cout<<it<<endl;
    }
    return 0;
}
def maxHeap(data: List[int], length, i):
    left = 2 * i + 1
    right = 2 * i + 2
    largest = i
    if left < length and data[left] > data[largest]:
        largest = left
    if right < length and data[right] > data[largest]:
        largest = right
    if largest != i:
        data[largest], data[i] = data[i], data[largest]
        maxHeap(data, length, largest)


def headTest(data):
    # 建堆
    for i in range(len(data) // 2 - 1, -1, -1):
        maxHeap(data, len(data), i)
    for i in range(len(data)-1, 0, -1):
        # 最大的放在末尾
        data[i], data[0] = data[0], data[i]
        maxHeap(data, i, 0)
    print(data)
堆的插入
堆是完全二叉树,索引是按2i, 2i+1索引的,一层一层存的,因此新插入元素一定在最后一个。
然后将这个值与父元素比较,如果不满足大顶堆小顶堆规则,则与父元素替换(如下图所示)。
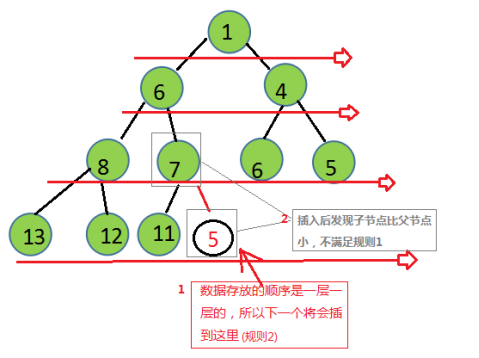
也就是上浮
private void swim(int k) {
    while (k > 1 && less(k / 2, k)) {
        swap(k / 2, k);
        k = k / 2;
    }
}
将新元素放到数组末尾,然后上浮到合适的位置。
public void insert(Comparable v) {
    heap[++N] = v;
    swim(N);
}
冒泡排序
void bubbleSort(vector<int>& d) {
	for (int i = 0; i < d.size(); i++) {
		bool isT = true;
		for (int j = 0; j < d.size() - i - 1; j++) {
			if (d[j] > d[j + 1]) {
				swap(d[j], d[j + 1]);
				isT = false;
			}
		}
		if (isT) {
			return;
		}
	}
}
桶排序
桶排序 (Bucket sort)或所谓的箱排序,是一个排序算法,工作的原理是将数组分到有限数量的桶子里。每个桶子再个别排序(有可能再使用别的排序算法或是以递归方式继续使用桶排序进行排序)。桶排序是鸽巢排序的一种归纳结果。当要被排序的数组内的数值是均匀分配的时候,桶排序使用线性时间(Θ(n))。但桶排序并不是 比较排序,他不受到 O(n log n) 下限的影响。
就是利用数组的索引记录每个元素的出现次数,然后遍历数组就好了
衍生的,就是求出现次数高低的那种题目,就是倒过来,就是记录每个元素m的出现次数n,然后book[n].add(m),然后再遍历book[]数组就是每个元素出现次数的高低啦,比如这道题目347. 前 K 个高频元素
计数排序vs基数排序vs桶排序
从计数排序说起
计数排序是一种非基于元素比较的排序算法,而是将待排序数组元素转化为计数数组的索引值,从而间接使待排序数组具有顺序性。
计数排序的实现一般有两种形式:基于辅助数组和基于桶排序。
基于辅助数组
整个过程包含三个数组:待排序数组A、计数数组B和输出数组C。
简单来说,就是通过统计待排序数组A中元素不同值的分布直方图,生成计数数组B,然后计算计数数组B的前缀和(此步操作可以看成计算待排序数组A中每个元素的位置信息),最后通过逆序循环将元素对应赋值到输出数组C中,输出数组C即是最终排序结果。
基于桶排序
其实就是用桶排序来维护稳定性,因为在每个桶中的元素是以队列结构排序的,可以维护元素的顺序。
主要步骤:
1. 按元素的最大健值与最小健值之差来创建指定数量的桶,并在每个桶中创建一个队列。
2. 按顺序遍历待排序数组,将它们放到对应桶的队列中。
3. 按桶编号顺序进行遍历,将每个桶中队列按顺序输出回原数组中。
计数排序的不足
可以看到辅助数组的长度和桶的数量由最大值和最小值决定,假如两者之差很大,而待排序数组又很小,那么就会导致辅助数组或桶大量浪费。
class Solution:
    def countingSort(self, arr):
        arr_min, arr_max = min(arr), max(arr)
        size = arr_max - arr_min + 1
        counts = [0 for _ in range(size)]

        for num in arr:
            counts[num - arr_min] += 1
        for j in range(1, size):
            counts[j] += counts[j - 1]

        res = [0 for _ in range(len(arr))]
        for i in range(len(arr) - 1, -1, -1):
            res[counts[arr[i] - arr_min] - 1] = arr[i]
            counts[arr[i] - arr_min] -= 1

        return res

    def sortArray(self, nums: List[int]) -> List[int]:
        return self.countingSort(nums)
基数排序
基数排序改善了计数排序,简单来说,基数排序算法就是将整数或字符串切分成不同的数字或字符,然后按对应位置的数或字符分别进行比较,这样就能将辅助数组或桶的数量降低到一个较小的值,经过多轮排序后得到最终的排序结果。
比如下面对于十进制的数值比较,只需要10个桶即可,但要保证每个桶能放得进所有元素。
第一阶段:针对个位数将元素放到对应的桶中。
第二阶段:针对十位数将元素放到对应的桶中。
第三阶段:针对百位数将元素放到对应的桶中。
最终按照桶顺序输出得到排序结果。这样桶里顺序都是有序的,阶段越往后,决定程度越大
class Solution:
    def radixSort(self, arr):
        size = len(str(max(arr)))

        for i in range(size):
            buckets = [[] for _ in range(10)]
            for num in arr:
                buckets[num // (10 ** i) % 10].append(num)
            arr.clear()
            for bucket in buckets:
                for num in bucket:
                    arr.append(num)

        return arr

    def sortArray(self, nums: List[int]) -> List[int]:
        return self.radixSort(nums)
桶排序
桶排序是改善计数排序的方法之一,其基本思想是将待排序数组分配到若干个桶内,然后每个桶内再各自进行排序,桶内的排序可以使用不同的算法,比如插入排序或快速排序,属于分治法。每个桶执行完排序后,最后依次将每个桶内的有序序列拿出来,即得到完整的排序结果。
待排序数组的最大元素与最小元素分别为19和1,那么总的范围区间可定义为[0,19],假设用4个桶,则桶的区间分别为[0,4][5,9][10,14][15,19]。可以看到桶的数量可以控制在很小的范围内,而且桶的容量大小可以动态扩充。
按照值将元素放到对应桶内。
按照桶顺序将元素依次输出得到排序结果。
总结
- 基数排序和桶排序可以看成是计数排序的泛化版本,使用了某些措施优化排序过程。
- 在桶排序中当桶的个数取最大值(max-min+1)的时候,就变成了计数排序,所以计数排序时桶排序的一种特例。
- 基数排序可以看做是多轮桶排序,基数排序以有效位的角度,每个有效位都进行一轮桶排序。
- 当用最大值作为基数时,基数排序就退化成了计数排序。
排序问题
得到数组排序需要的最小交换次数
给一个序列,序列两两元素可以任意交换,求最少的交换次数使得序列有序
这是一个经典问题,一般有两种做法
非置换环方法。模拟,遇到不对就换一次。
        def min_swaps(nums):
            mp = {}
            sort_nums = sorted(nums)
            for i in range(len(sort_nums)):
                mp[sort_nums[i]] = i
            ans = 0
            for i in range(len(nums)):
                while nums[i] != sort_nums[i]:
                    t = mp[nums[i]]
                    nums[i], nums[t] = nums[t], nums[i]
                    ans += 1
            return ans
置换环的思想为 : 对每个节点,将其指向其排序后应该放到的位置,直到首位相接形成了一个环。

        def min_swaps(nums):
            mp = {}
            sort_nums = sorted(nums)
            for i in range(len(sort_nums)):
                mp[sort_nums[i]] = i
            lops = 0
            flags = []
            for i in range(len(nums)):
                flags.append(False)
            for i in range(len(nums)):
                if not flags[i]:
                    j = i
                    while not flags[j]:
                        flags[j] = True
                        j = mp[nums[j]]
                    lops += 1
            return len(nums) - lops